做完你会得到什么
一个「拍餐估热量」App:拍下这顿饭,AI 列出每样食物、分量和估算热量,App 自己算出合计;点「记到今天」,一天吃了几顿、多少千卡一目了然,第二天自动从零开始。
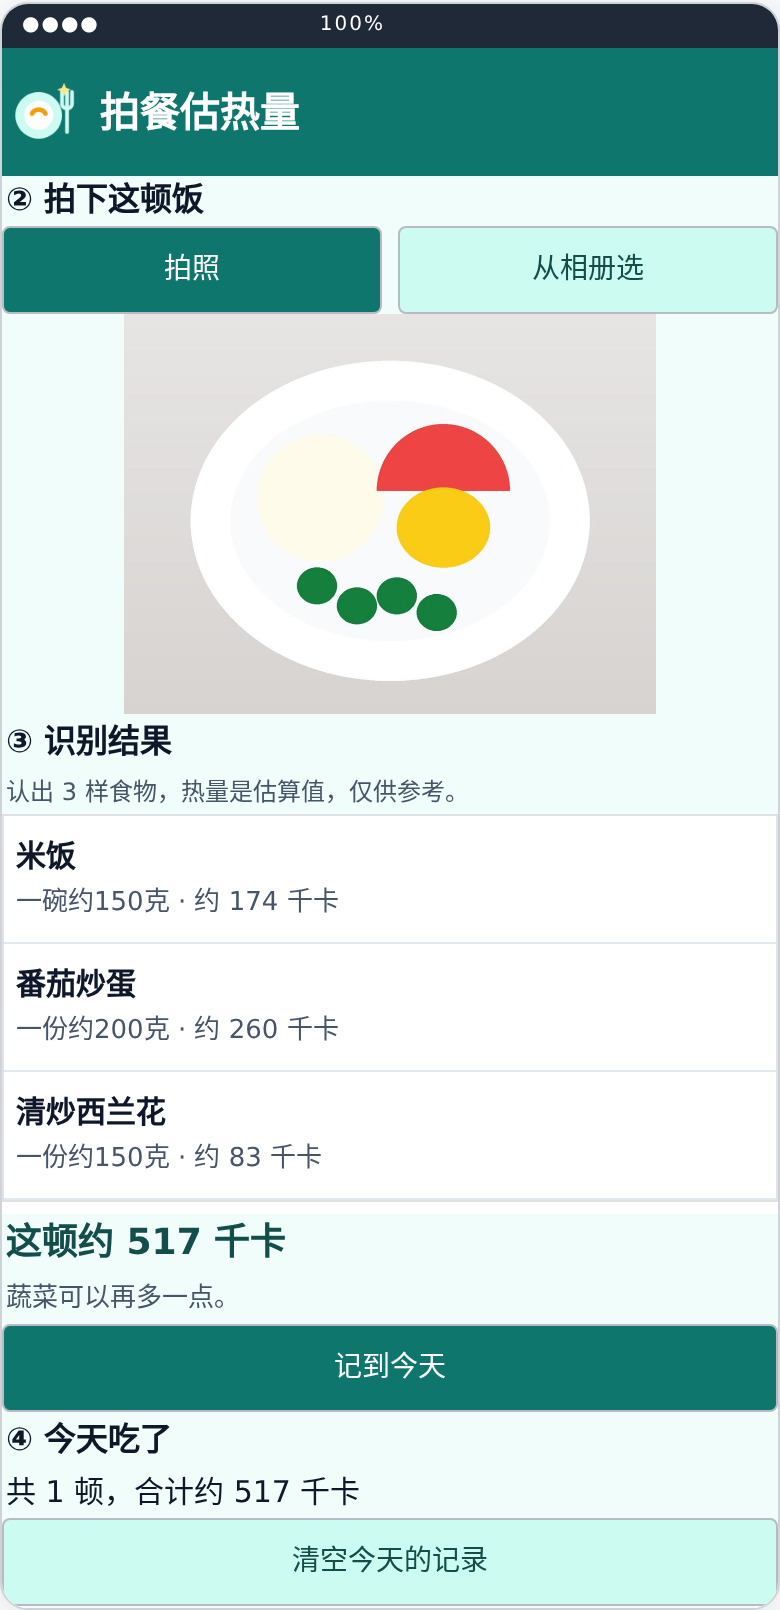
图为执行最终 .aia 里的真实积木生成的布局预览,不是真机截图;AI 的回答与照片、生成的图片都是示意。
| 难度 | 用时 | 前置 | 用到的模型 |
|---|---|---|---|
| ★★★ | 60 分钟 | 第 1 课、会用字典 | 通义千问视觉模型 qwen3-vl-plus |
为什么要让模型回 JSON
前两课的回答是给人看的,一段话显示出来就完了。可一旦要用回答里的数据——加总热量、存进数据库、画成图表——一段自然语言就没法用了:「大概两百来卡」「约 174 千卡」「一碗饭 174kcal 左右」,积木拆不出数字。
办法是和模型约定一个格式:只回一个 JSON 对象,字段名、类型都写死。App 拿到后用 Web 客户端.用字典解码JSON文本 变成字典,按键取值,跟解析任何网络接口一样。
本课约定的格式:
| 字段 | 类型 | 例子 |
|---|---|---|
foods |
数组,每项是一个对象 | |
foods[].name |
文本 | 米饭 |
foods[].amount |
文本 | 一碗约150克 |
foods[].kcal |
数字 | 174 |
total |
数字 | 480 |
tip |
文本,30 字以内 | 蔬菜可以再多一点。 |
准备
| 准备什么 | 说明 |
|---|---|
| 阿里云百炼 API Key | 到 阿里云百炼控制台 开通服务,创建 API Key(sk- 开头)。新用户一般有一定的免费额度,以控制台显示为准 |
| 视觉模型 | Qwen 组件默认的 qwen-plus 只懂文字,识图要换成视觉模型。本课用 qwen3-vl-plus,想更快更便宜可以换 qwen3-vl-flash |
界面组件
在第 1 课的基础上(API Key 卡片、拍照、相册、压缩相同):
| 组件 | 命名 | 关键属性 / 作用 |
|---|---|---|
| Qwen(拓展) | Qwen1 | 积木里改 ModelName 与 StreamMode,设计器不用动 |
| 列表显示框 | 列表显示框_食物 | 布局选「主文本 + 详细文本」(ListViewLayout = 1),高 200 |
| 标签 | 标签_合计、标签_建议、标签_今日 | |
| 按钮 | 按钮_记一笔、按钮_清空今天 | 按钮_记一笔 默认不启用 |
| Web 客户端 | Web客户端1 | 只用它的 JSON 解码,不联网 |
| 计时器 | 计时器1 | 取今天的日期;启用计时 设为假 |
分步搭
第 1 步:换视觉模型,关掉流式
流式回答是一小段一小段到的,半个 JSON 没法解码。关掉流式后,回答一次性从 GotText 送来。
when Screen1.Initialize() {
  组件美化1.SetAsCard(垂直布局_密钥)
  组件美化1.SetAsCard(垂直布局_拍餐)
  组件美化1.SetAsCard(垂直布局_结果)
  组件美化1.SetAsCard(垂直布局_今日)
  // 默认的 qwen-plus 是纯文本模型,识图要换视觉模型;要完整 JSON 才能解析,所以关掉流式
  Qwen1.ModelName = "qwen3-vl-plus"
  Qwen1.StreamMode = false
  密码输入框_密钥.Text = 微数据库1.GetValue("qwenKey", "")
  使用密钥(密码输入框_密钥.Text)
  显示今天()
}
第 2 步:结构化输出的提示词
写好 JSON 提示词有四个要点,这一段全用上了:
- 只要 JSON:「只输出一个 JSON 对象,不要任何解释,不要代码块标记」。不说的话,模型很喜欢先来一句「好的,结果如下」,再用
```json包起来。 - 每个字段写清含义和类型,尤其是数字:「kcal(热量千卡,只写数字)」,否则会得到
"约200千卡"。 - 给出空结果的样子:「图里没有食物时 foods 为空数组」,拍到桌子时它就不会硬编一道菜。
- 限制长度:「不超过30字的饮食建议」。
字段说明用文字描述就行,不必在积木里写一段带引号的 JSON 样例(那样字符串里满是转义符,难读也容易抄错)。
global 正在识别 = false
global 本餐 = 0

procedure 识别(图片) {
  if 正在识别 {
    底部提示条1.Show("还在识别上一张,稍等一下")
  } else if Qwen1.APIKey == "" {
    底部提示条1.Show("先在上面填好 API Key 并点保存")
  } else {
    var 小图 = 图片处理1.Compress(图片, 1024, 80)
    if 小图 == "" {
      底部提示条1.Show("这张图片处理不了,换一张试试")
    } else {
      图像_餐.Picture = 小图
      正在识别 = true
      本餐 = 0
      按钮_拍照.Enabled = false
      图像选择器_相册.Enabled = false
      按钮_记一笔.Enabled = false
      列表显示框_食物.Elements = []
      标签_合计.Text = ""
      标签_建议.Text = ""
      标签_状态.Text = "正在识别……"
      Qwen1.StartNewChat()
      Qwen1.ChatWithImage("你是营养师。识别图中每一样食物,估算分量和热量。只输出一个 JSON 对象,不要任何解释,不要代码块标记。对象有三个字段:foods 是数组,每一项含 name(食物名)、amount(分量,如一碗约150克)、kcal(热量千卡,只写数字);total 是总热量千卡(数字);tip 是一句不超过30字的饮食建议。图里没有食物时 foods 为空数组。", 小图)
    }
  }
}
拍照、选图两个入口都调用 识别,与第 1 课相同。
第 3 步:把 JSON 从回答里「抠」出来再解码
就算提示词写得再清楚,也要按「模型不一定听话」来写解析:
- 它可能还是加了客套话或
```json标记; - 安卓的解码器遇到
}后面多出的文字会忽略,鸿蒙的解码器很严格,多一个字就失败。
最稳的做法:从第一个 { 截到最后一个 },前后的东西一概不要。文本积木里只有「从前往后找」,最后一个 } 用一个循环找:每遇到一个 } 就记下位置,循环结束时记下的就是最后一个。
when Qwen1.GotText(text) {
  正在识别 = false
  按钮_拍照.Enabled = true
  图像选择器_相册.Enabled = true
  显示结果(text)
}

procedure 显示结果(回答) {
  var 开头 = startsat(回答, "{")
  var 结尾 = 0
  for i = 1 to textlength(回答) {
    if segment(回答, i, 1) == "}" {
      结尾 = i
    }
  }
  if 开头 == 0 or 结尾 < 开头 {
    没看懂()
  } else {
    // 鸿蒙的 JSON 解码很严格,} 后面多一个字都会失败;截干净了两个平台都稳
    var 结果 = Web客户端1.JsonTextDecodeWithDictionaries(segment(回答, 开头, 结尾 - 开头 + 1))
    if isdict(结果) {
      填表(结果)
    } else {
      没看懂()
    }
  }
}

procedure 没看懂() {
  标签_状态.Text = "AI 没按约定的格式回答,再拍一次试试。"
}
JSON 本身坏了(比如被截断成 {"foods":[{"name":"饺子",),解码会失败:屏幕的「出现错误时」收到函数名 JsonTextDecodeWithDictionaries、错误编号 1105,解码返回空文本,isdict 为假,走「没看懂」。第 6 步会在出错事件里单独处理它。
第 4 步:填列表,合计自己算
合计不要信模型给的 total——它是「估」出来的,可能和各项加起来对不上(比如三样加起来 174 + 260 + 82.5 = 516.5,total 却写成 480)。按各项自己加,显示的数字才自洽。
kcal 也要防一手:约定了只写数字,偶尔还是会来个 "约550"。用 isnumber 判断,不是数字就按 0 算,不让一项坏数据毁掉整顿。
procedure 填表(结果) {
  var 行 = []
  var 合计 = 0
  foreach 食物 in dictget(结果, "foods", []) {
    if isdict(食物) {
      var 千卡 = dictget(食物, "kcal", 0)
      if not isnumber(千卡) {
        千卡 = 0
      }
      合计 = 合计 + 千卡
      listadd(行, 列表显示框_食物.CreateElement(dictget(食物, "name", "(没认出)"), join(dictget(食物, "amount", ""), " · 约 ", round(千卡), " 千卡"), ""))
    }
  }
  列表显示框_食物.Elements = 行
  // 合计按各项自己加:模型写的 total 有时和各项之和对不上
  本餐 = round(合计)
  if length(行) == 0 {
    标签_状态.Text = "图里没认出食物,换个角度再拍一张。"
    标签_合计.Text = ""
    标签_建议.Text = ""
  } else {
    标签_状态.Text = join("认出 ", length(行), " 样食物,热量是估算值,仅供参考。")
    标签_合计.Text = join("这顿约 ", 本餐, " 千卡")
    标签_建议.Text = dictget(结果, "tip", "")
    按钮_记一笔.Enabled = 本餐 > 0
  }
}
中途验证:拍一份盖浇饭。列表里两三行,每行「名称」+「分量 · 约 N 千卡」;合计是各行之和;「记到今天」变成可点。
第 5 步:按天记账
每天用一个标签:meals-2026-10-12,里面存一个列表,每顿一个千卡数。日期变了标签就变了,第二天自然从零开始,不用写「每天清零」的逻辑。
function 今日标签() {
  return join("meals-", 计时器1.FormatDate(计时器1.Now(), "yyyy-MM-dd"))
}

when 按钮_记一笔.Click() {
  var 记录 = 微数据库1.GetValue(今日标签(), [])
  listadd(记录, 本餐)
  微数据库1.StoreValue(今日标签(), 记录)
  按钮_记一笔.Enabled = false
  底部提示条1.Show(join("已记下 ", 本餐, " 千卡"))
  显示今天()
}

when 按钮_清空今天.Click() {
  微数据库1.ClearTag(今日标签())
  显示今天()
}

procedure 显示今天() {
  var 记录 = 微数据库1.GetValue(今日标签(), [])
  var 总 = 0
  foreach 千卡 in 记录 {
    总 = 总 + 千卡
  }
  if length(记录) == 0 {
    标签_今日.Text = "今天还没有记录。"
  } else {
    标签_今日.Text = join("共 ", length(记录), " 顿,合计约 ", 总, " 千卡")
  }
}
记完一笔把按钮变灰,防止同一顿点两次记成两顿。
中途验证:记两顿,「今天吃了」显示「共 2 顿,合计约 …」;退出 App 再打开,记录还在。
第 6 步:出错处理
when Screen1.ErrorOccurred(component, functionName, errorNumber, message) {
  正在识别 = false
  按钮_拍照.Enabled = true
  图像选择器_相册.Enabled = true
  if functionName == "JsonTextDecodeWithDictionaries" {
    没看懂()
  } else {
    标签_状态.Text = 错误说明(message)
  }
}

function 错误说明(message) {
  return choose(containstext(message, "401"), "API Key 不对:检查是否抄全,或到百炼控制台重新创建。", choose(containstext(message, "Arrearage"), "阿里云账户欠费:充值后再试。", choose(containstext(message, "429"), "请求太频繁了,等几秒再试。", choose(containstext(message, "不支持图片"), "当前模型不支持图片:确认 ModelName 是视觉模型(如 qwen3-vl-plus)。", join("出错了:", message)))))
}
「不支持图片」这一条靠的是拓展:识图请求被接口拒绝、错误里提到 image / vision 等字样时,拓展会在消息末尾追加一句「当前模型可能不支持图片/视频……」。
这一课的要点
- 要用数据,就让模型回 JSON:关流式 → 提示词约定格式 → 截取
{…}→ 字典解码 → 按键取值。 - 永远按「模型不一定听话」写解析:截取、
isdict判断、dictget带默认值、isnumber校验,一层都别省。 - 能自己算的不让模型算:加法、计数、日期,App 做得又快又准。
- 换个提示词,同一套解析能做很多 App:拍票据记账(商户、金额、日期)、拍名片存通讯录(姓名、电话、公司)、拍植物记录(名称、是否有毒、浇水频率)。
常见问题
| 现象 | 原因与处理 |
|---|---|
| 一直提示「AI 没按约定的格式回答」 | 先把 text 原样显示到一个标签上看看。常见是模型名还是 qwen-plus(纯文本模型看不到图,于是道歉),或提示词被改掉了「只输出 JSON」 |
| 安卓上正常,鸿蒙上偶尔解析失败 | 回答在 } 后面带了文字。照第 3 步截到最后一个 } 再解码 |
| 合计和模型说的总数不一样 | 本课故意不用模型的 total,以各项相加为准 |
| 某样食物显示「约 0 千卡」 | 模型把 kcal 写成了文字(如「约550」)。提示词里强调「只写数字」,或换更大的模型 |
| 状态行「当前模型不支持图片」 | ModelName 被改回了纯文本模型。用 qwen3-vl-plus / qwen3-vl-flash / qwen-vl-max 等视觉模型 |
| 状态行「阿里云账户欠费」 | 免费额度用完或欠费,到阿里云控制台充值 |
| 热量估得离谱 | 一张照片看不出油和分量,本来就只能估个大概。界面上要写明「估算值,仅供参考」 |
平台说明
- 安卓、鸿蒙都能运行。鸿蒙的 JSON 解码比安卓严格,本课的截取写法两边都验证过逻辑。
- 业务检查见验证记录:带客套话和代码块、
kcal不是数字、JSON 被截断、没有食物、跨天记账、重开 App 记录还在等情况都逐条执行过。
下一课
第 4 课 AI 画图:前三课都是「看图说话」;下一课反过来,让 AI 画图,再一句一句地改。
 扫码添加客服咨询