变声器
先了解你将做出什么
挑战:制作自己的变声器
“深度伪造”声音由模型学习真人录音后生成;本教程制作的应用不是真正的深度伪造,而是把语音识别得到的文字用不同音调和语速读出来。请把它用于创作和学习,不要冒充他人或误导别人。
Chromebook 不能作为本教程的测试设备;请使用 Android 或 iOS 手机/平板。
设置电脑和手机
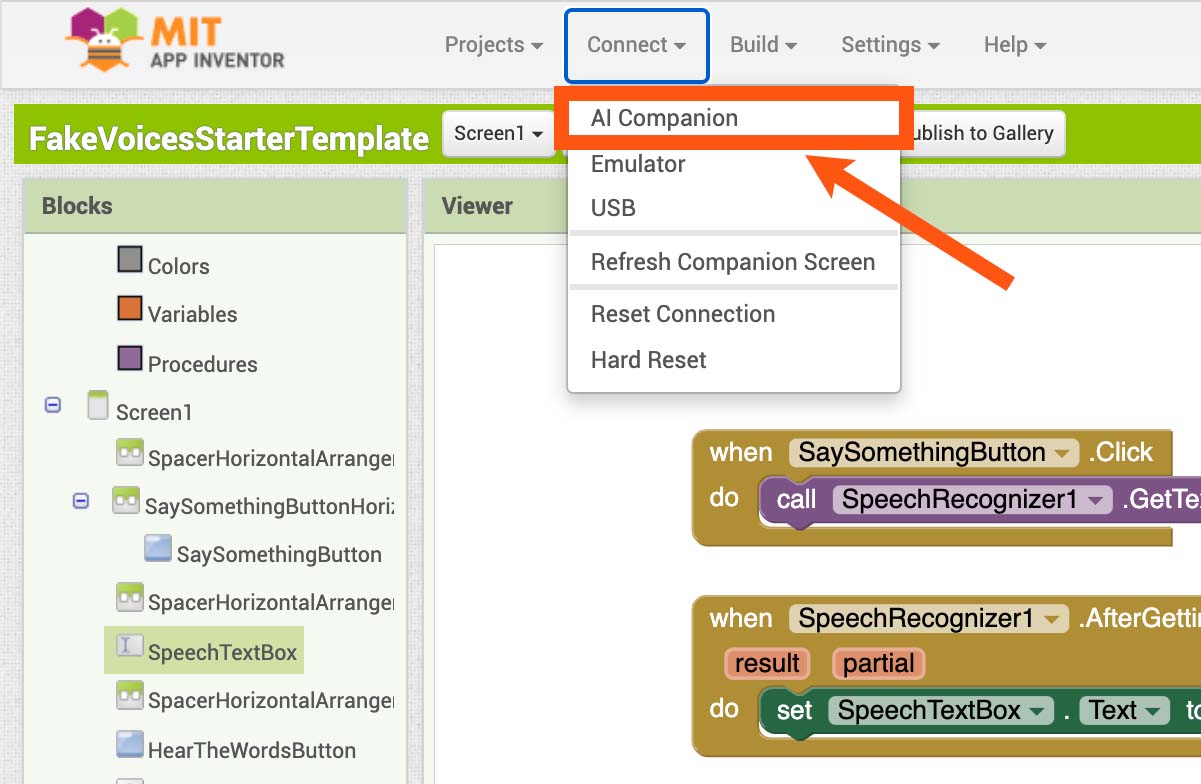
安装 AI2 Companion,并用“连接”菜单把手机接到 App Inventor。首次测试语音识别和文本朗读时,要允许麦克风权限并确认系统已经安装语音服务。
认识 App Inventor 环境
1. 查看设计器和积木编辑器
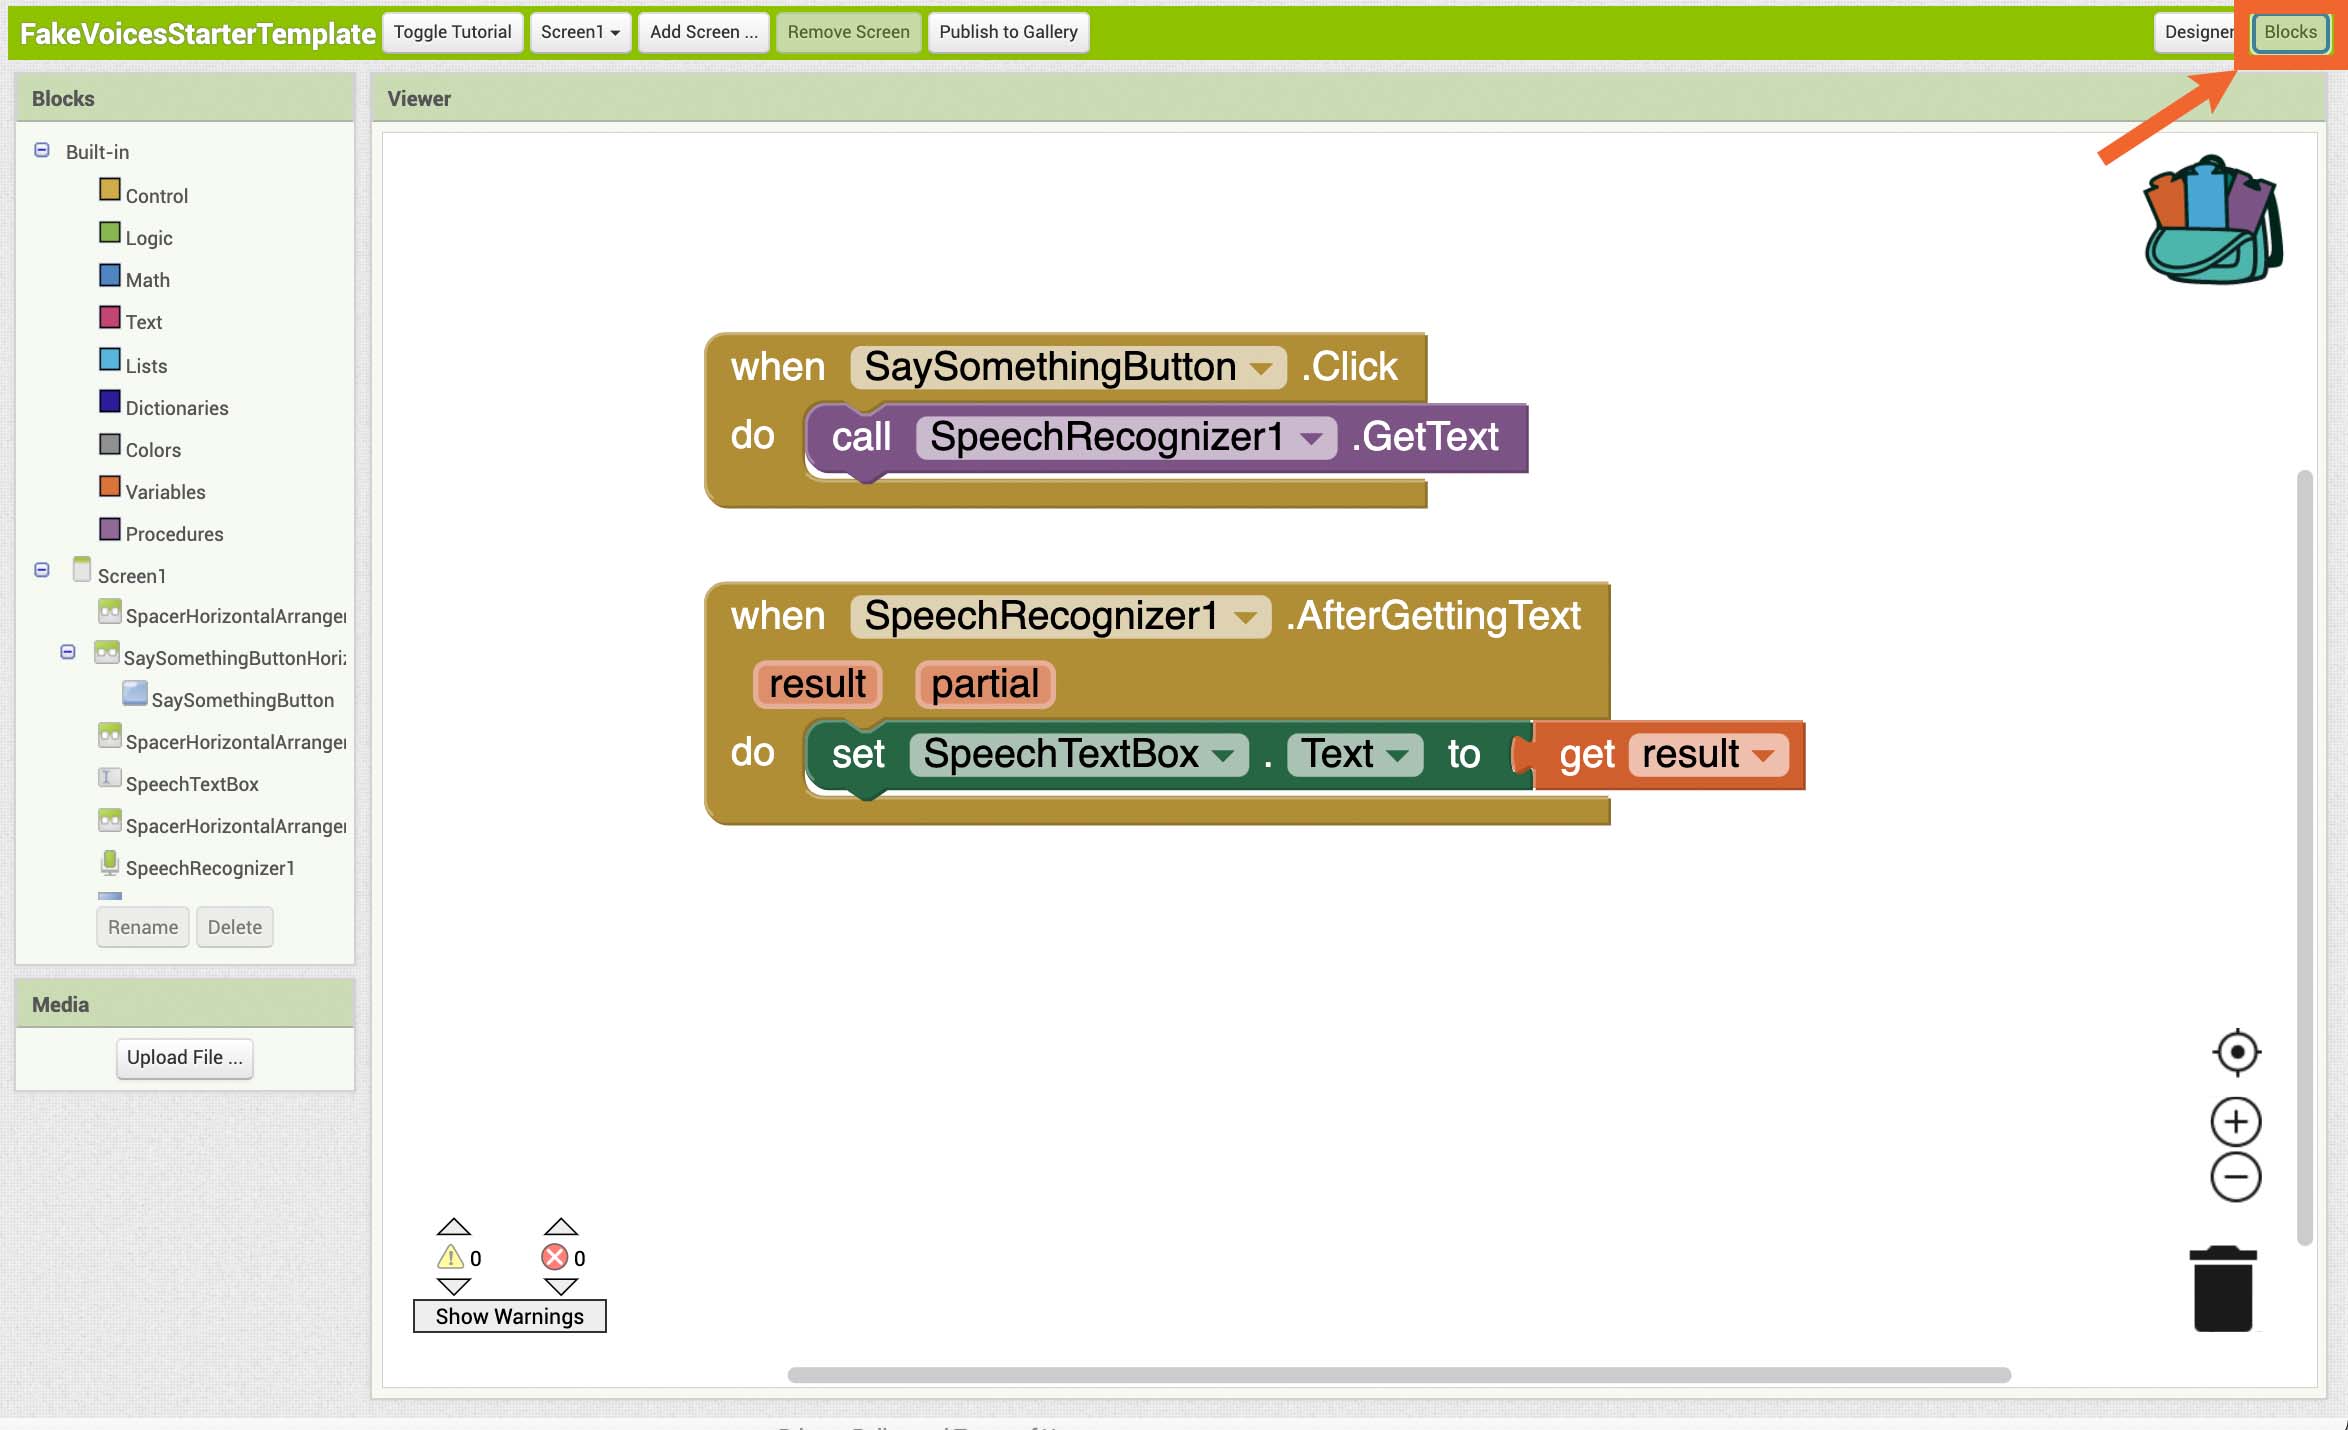
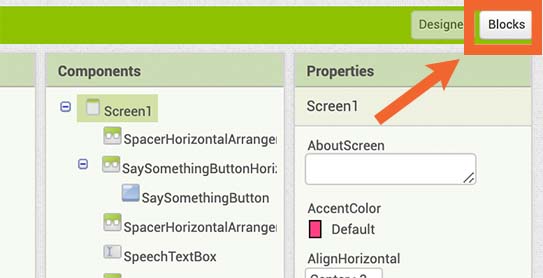
App Inventor 有两个主要工作区:设计器用来添加组件、排列界面;积木编辑器用来编写程序。右上角的按钮可以在两个页面之间切换。
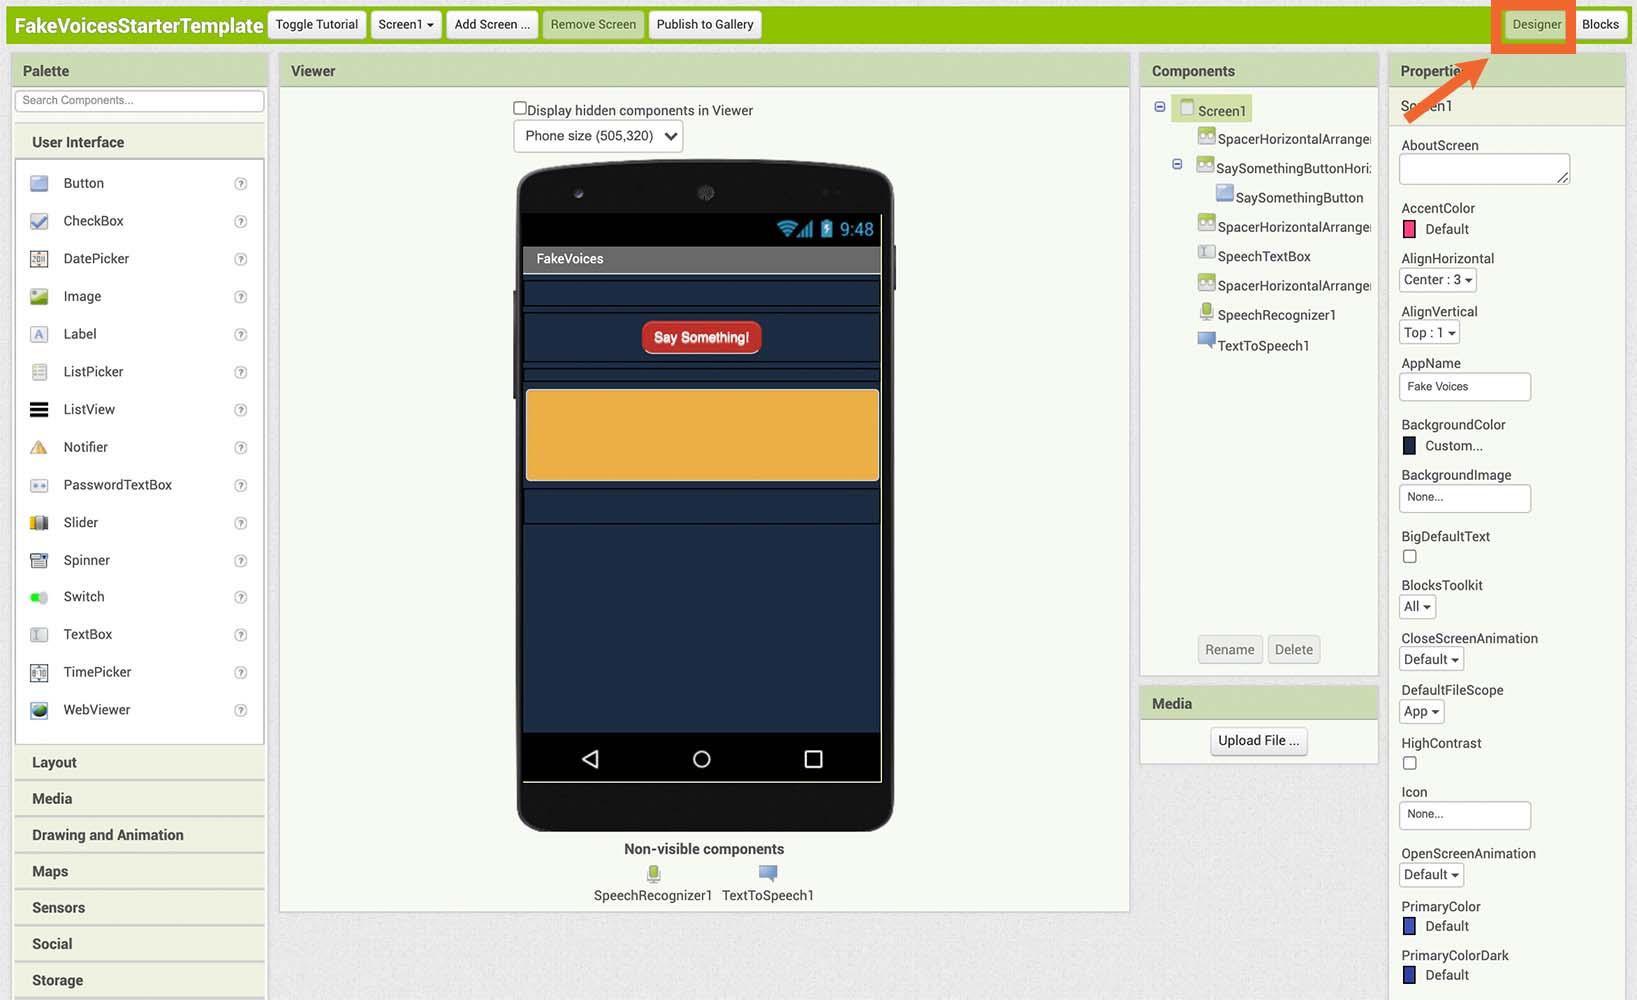
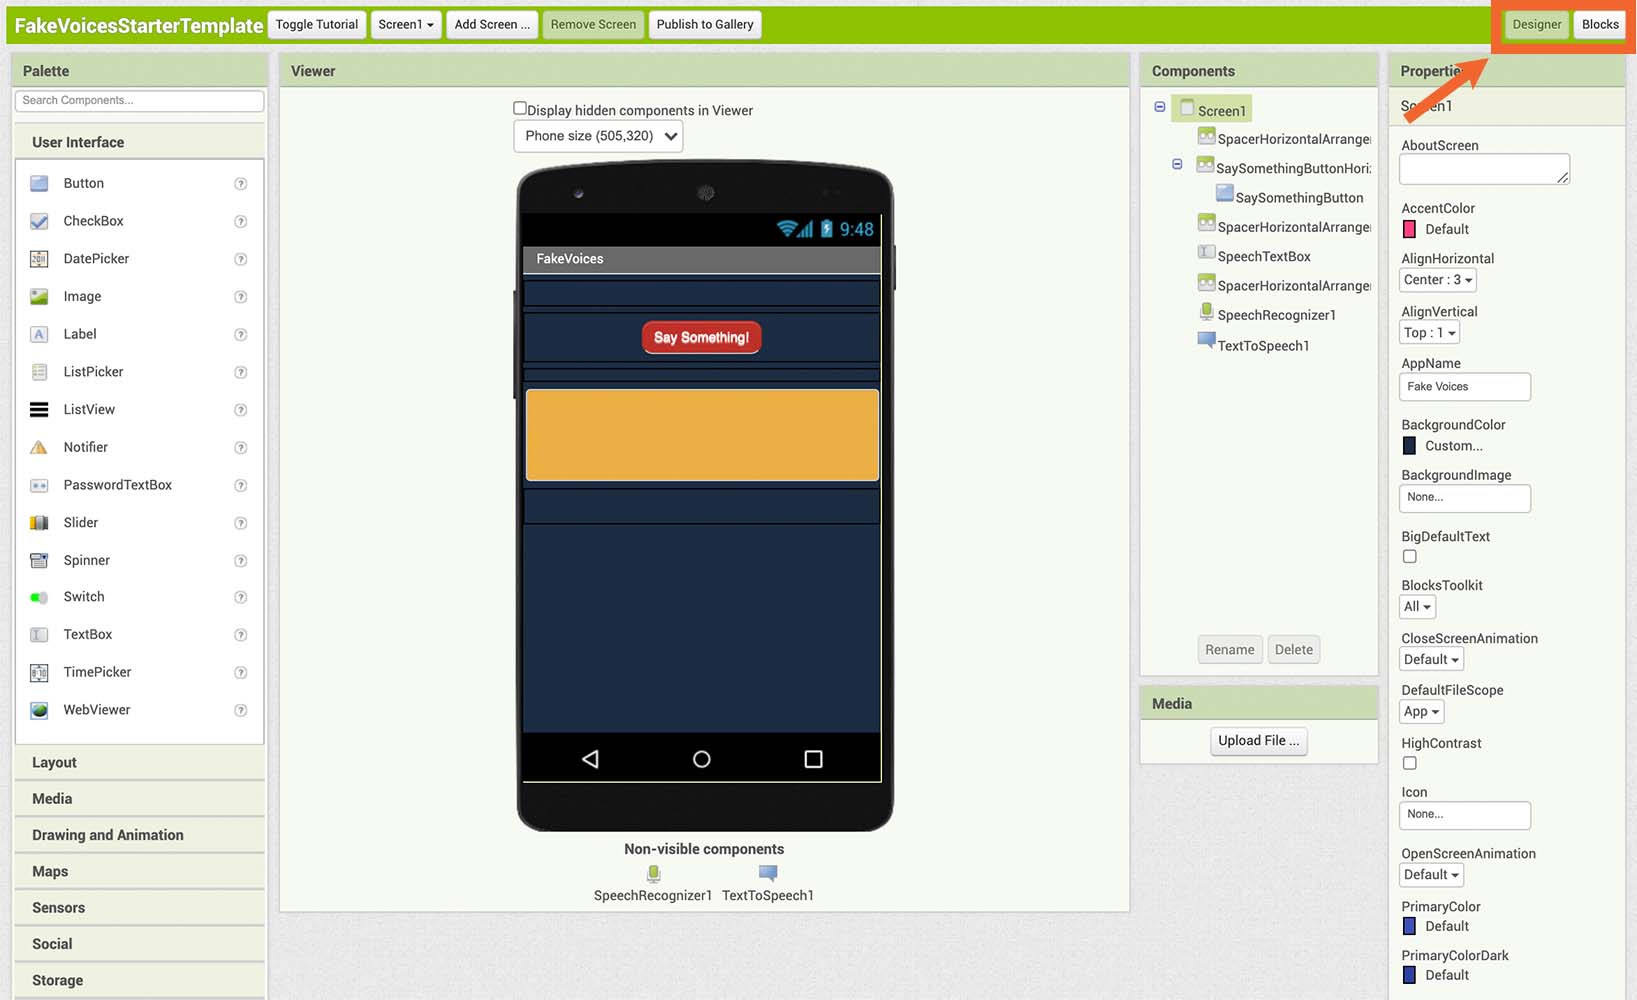
2. 认识设计器面板
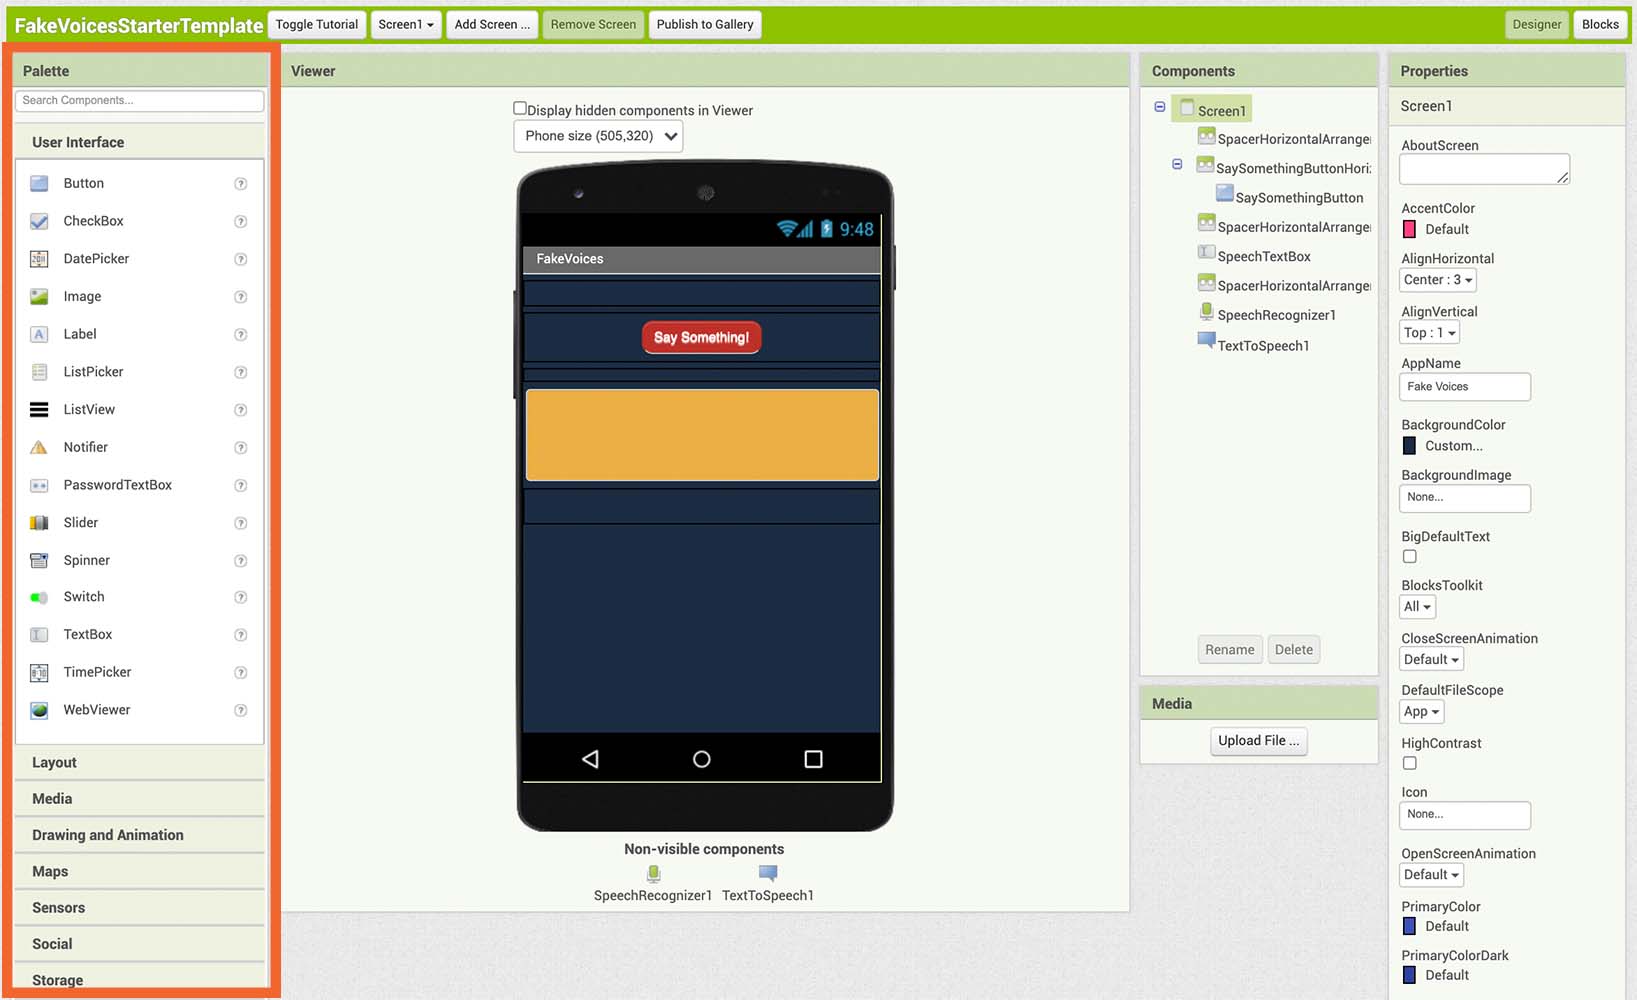
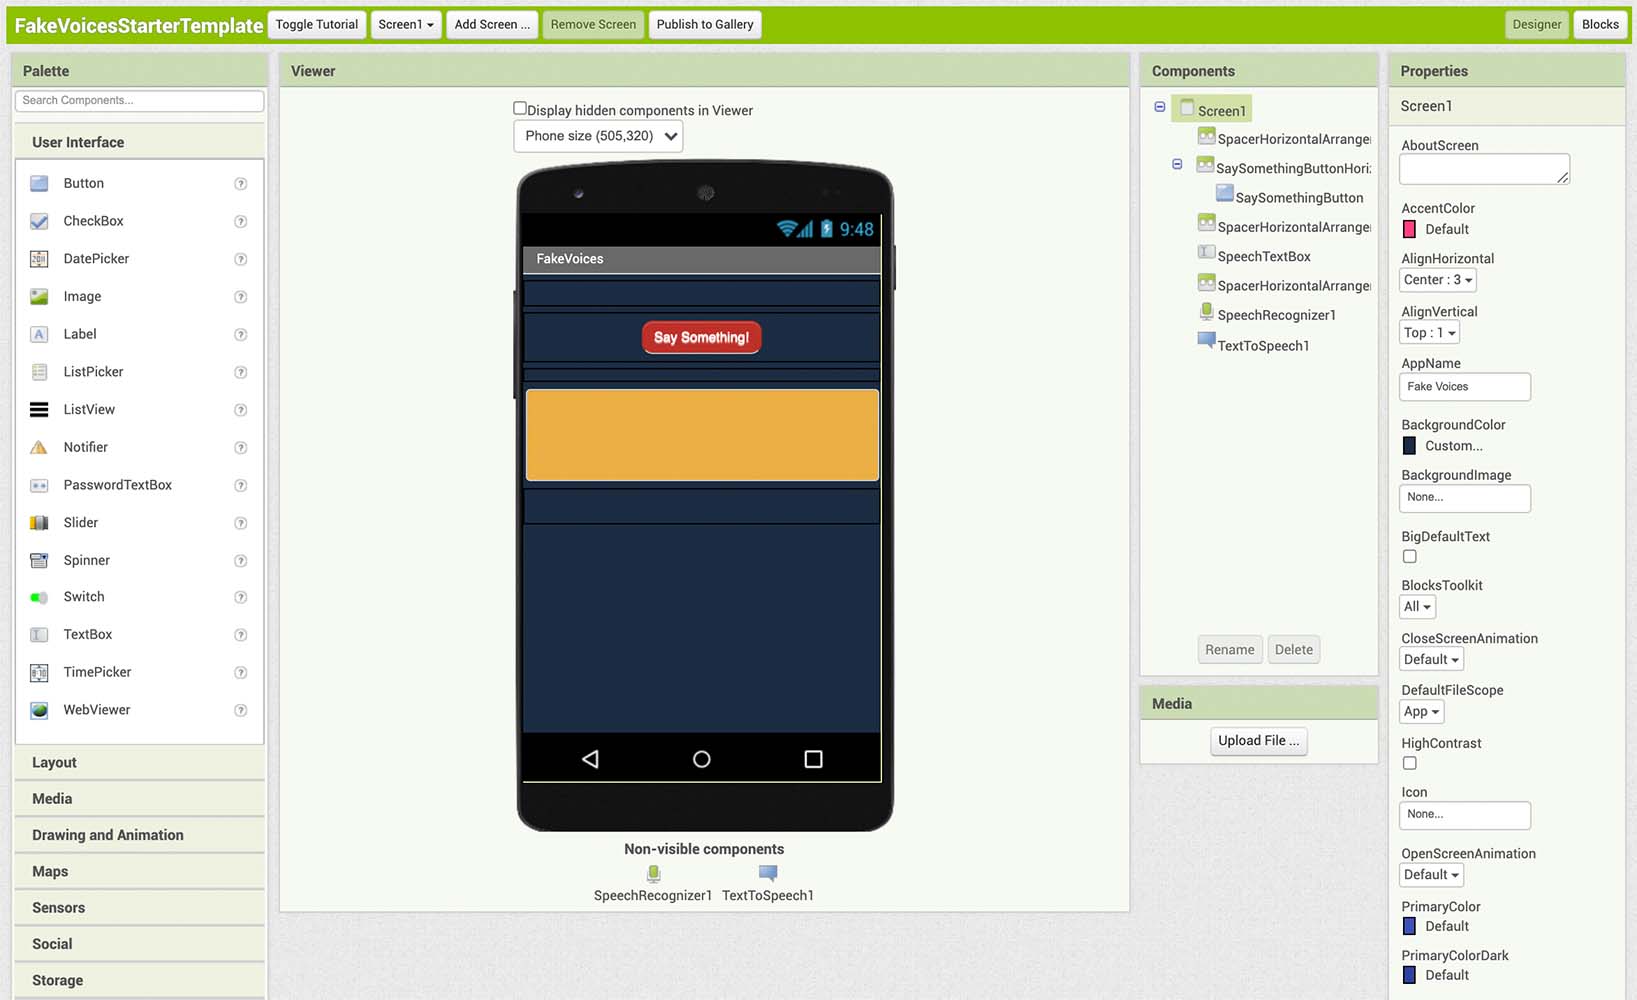
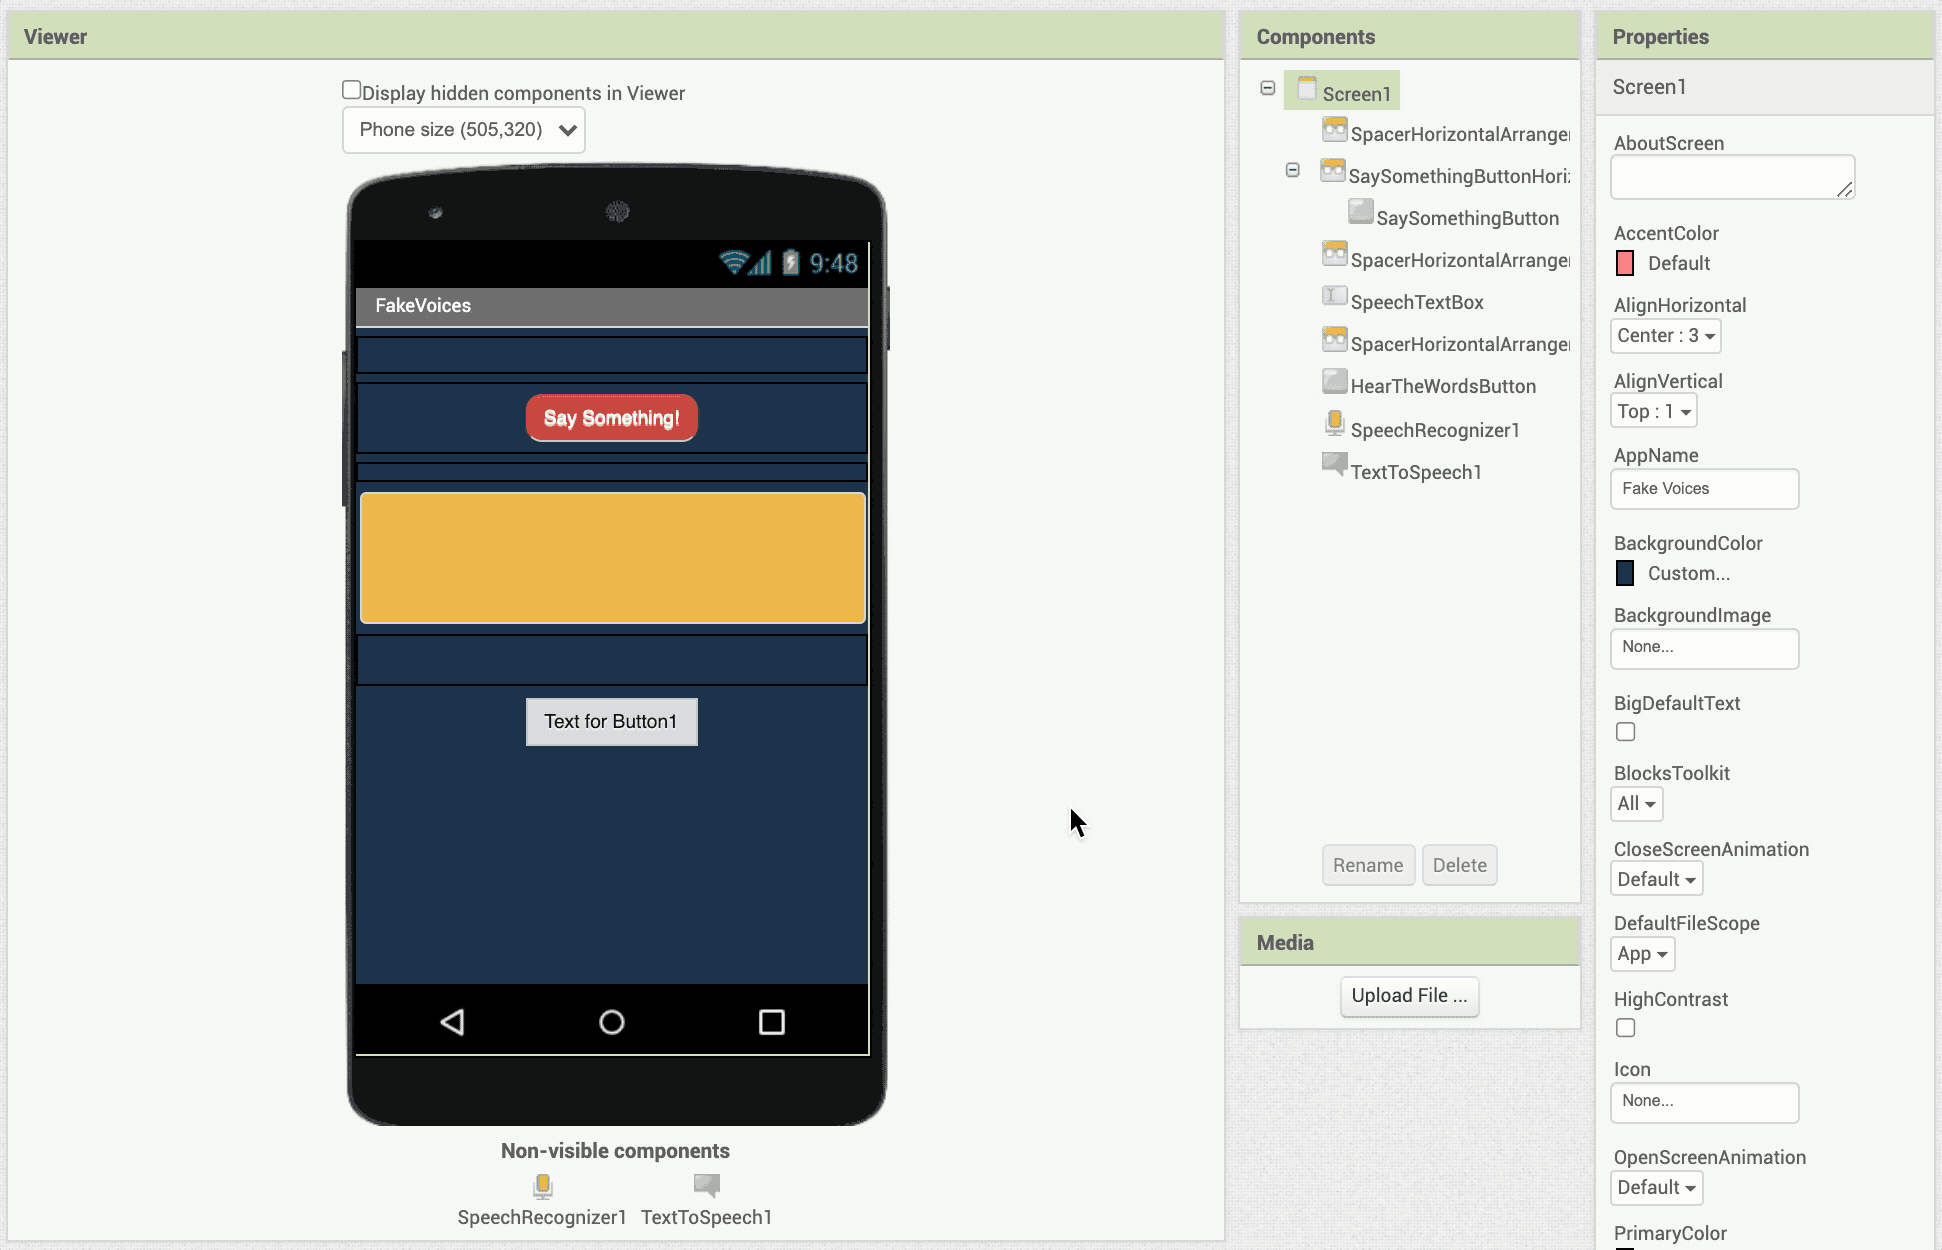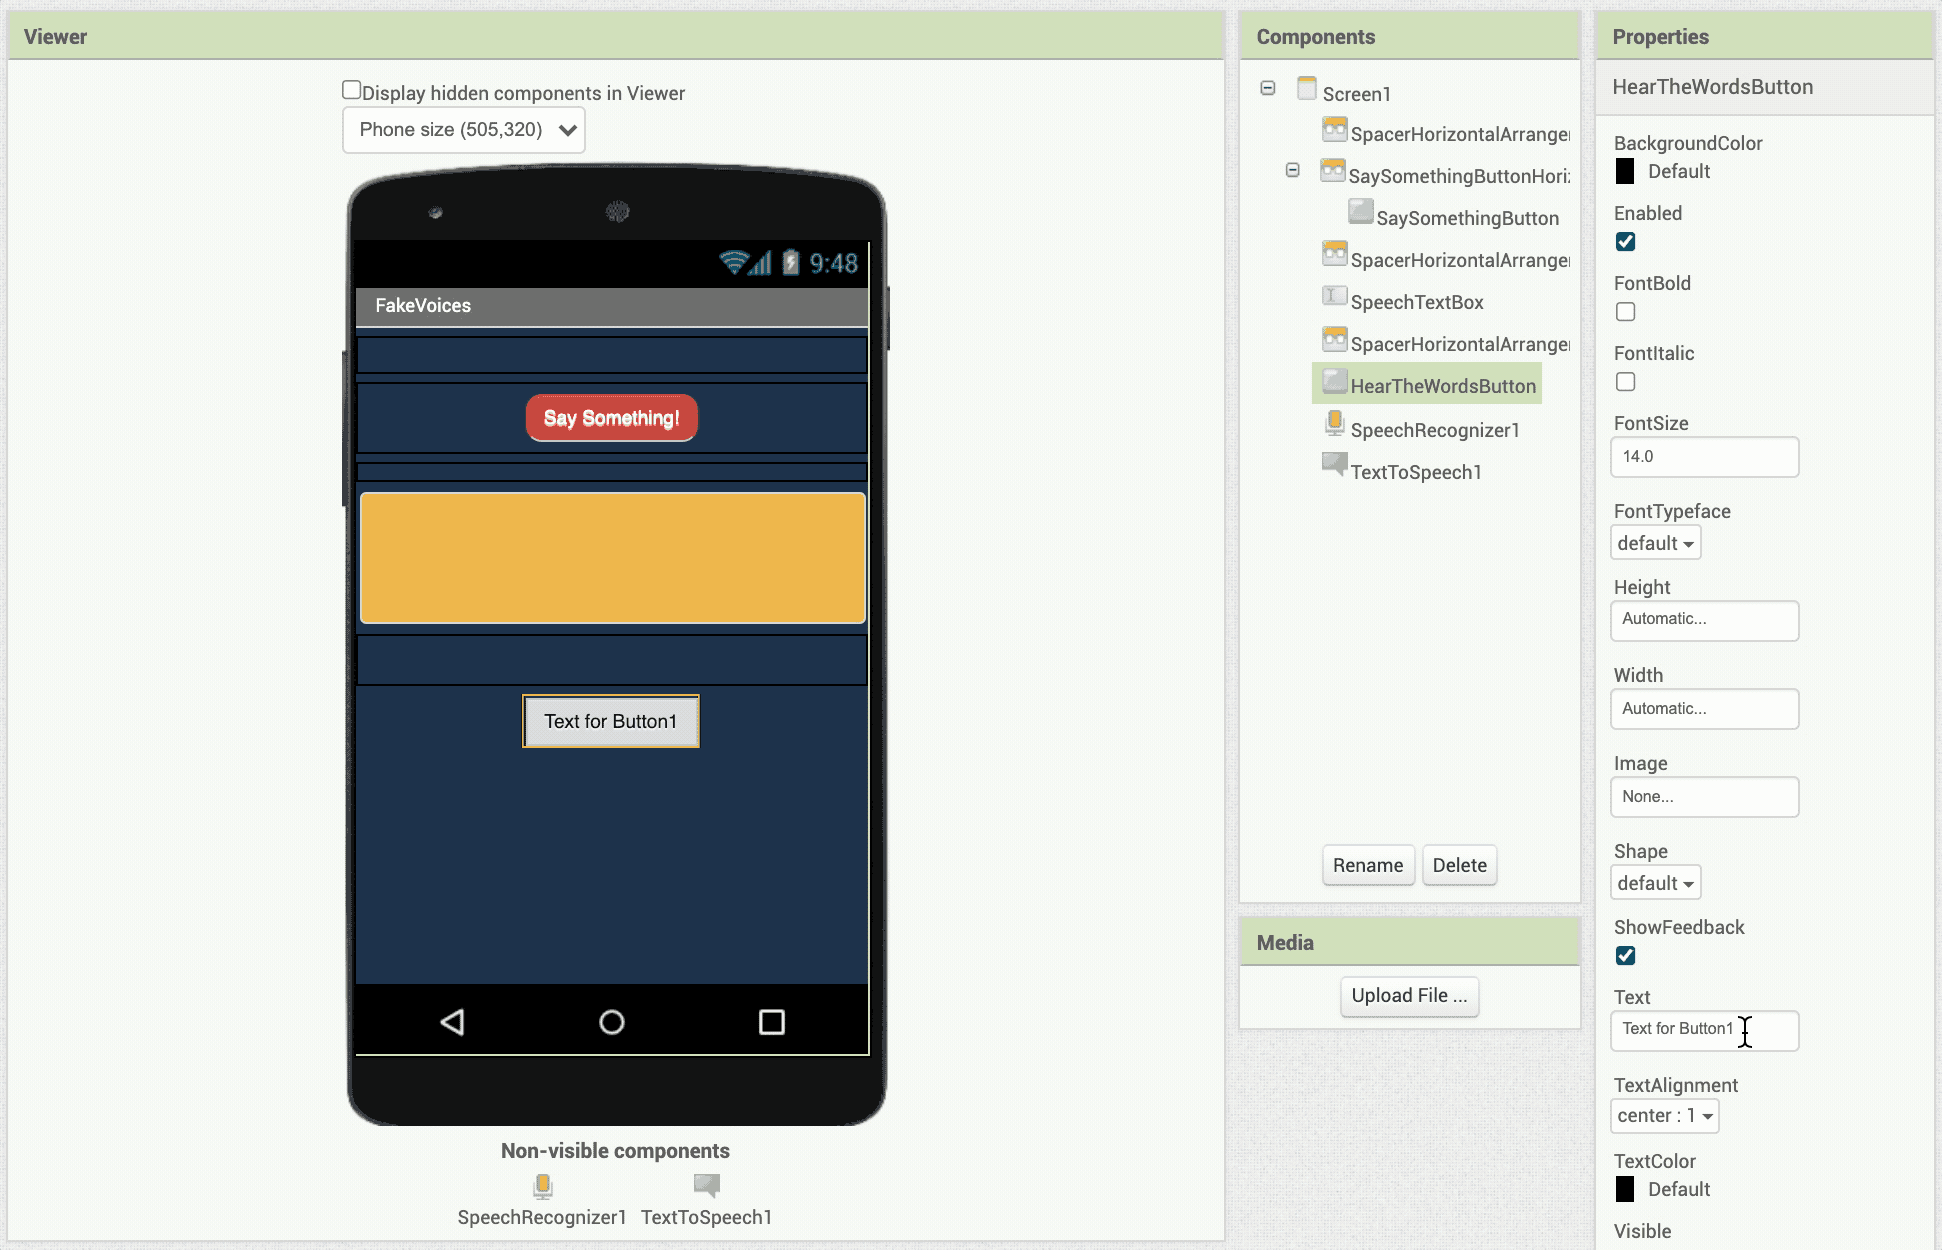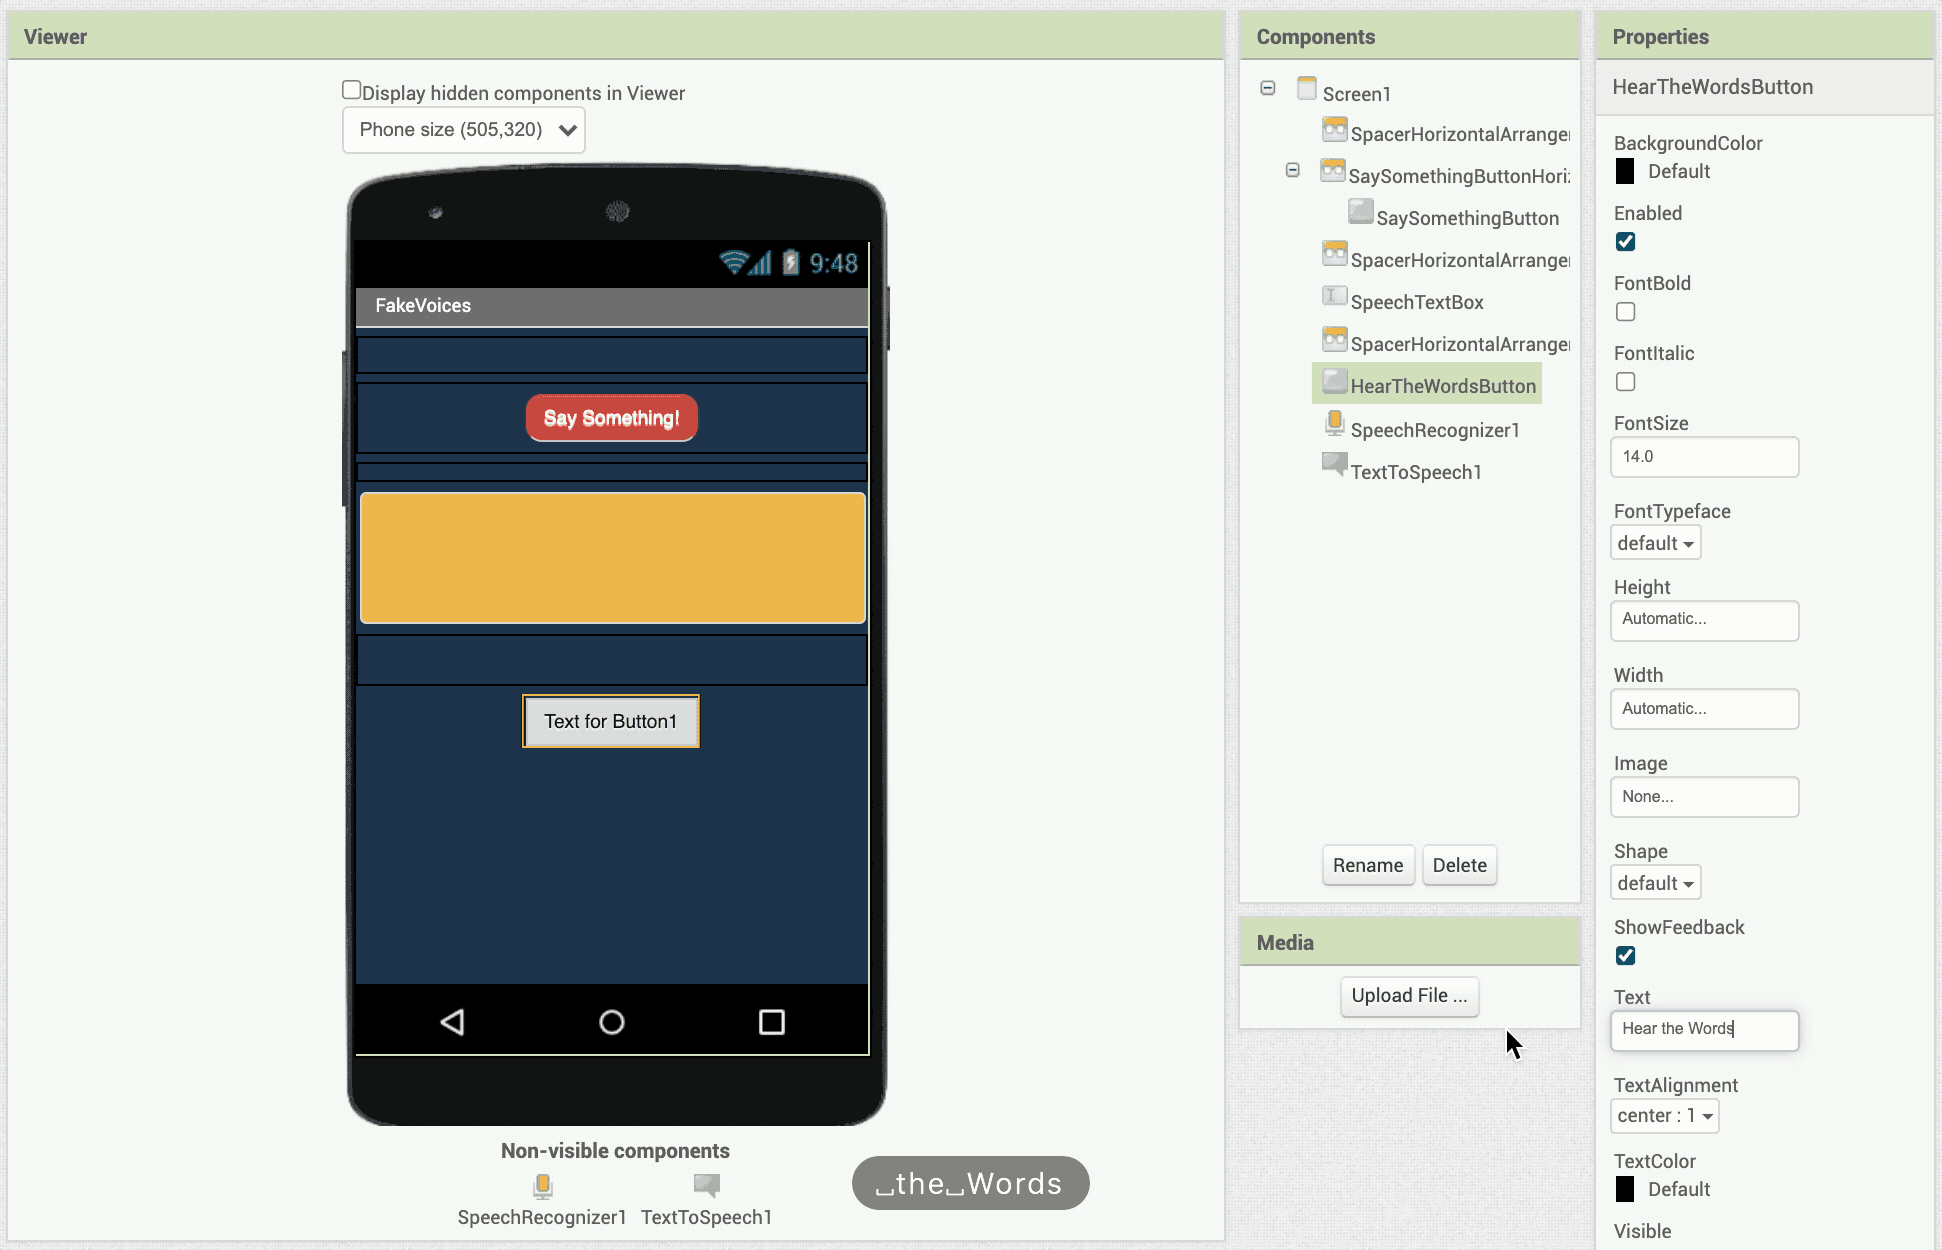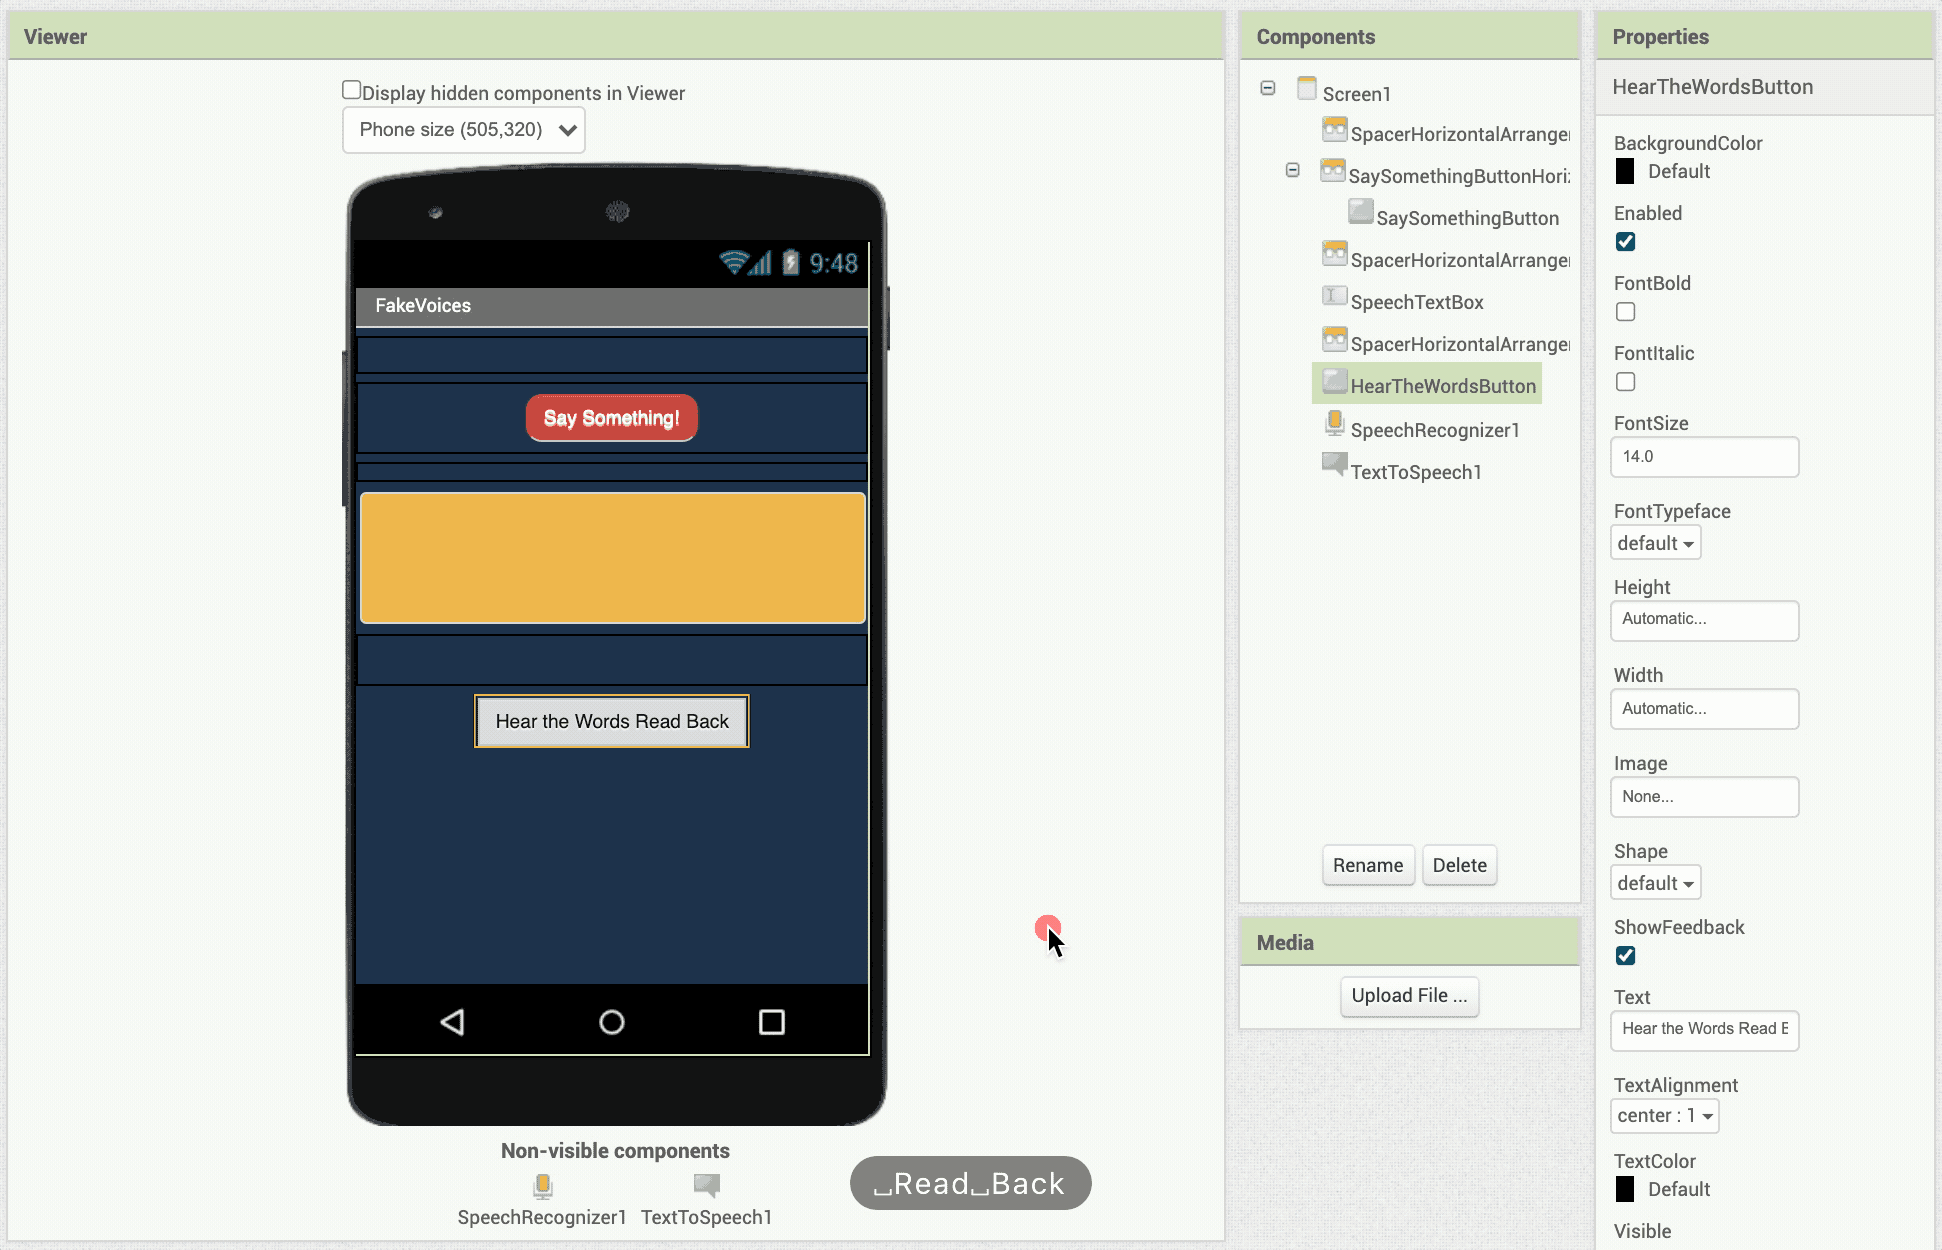
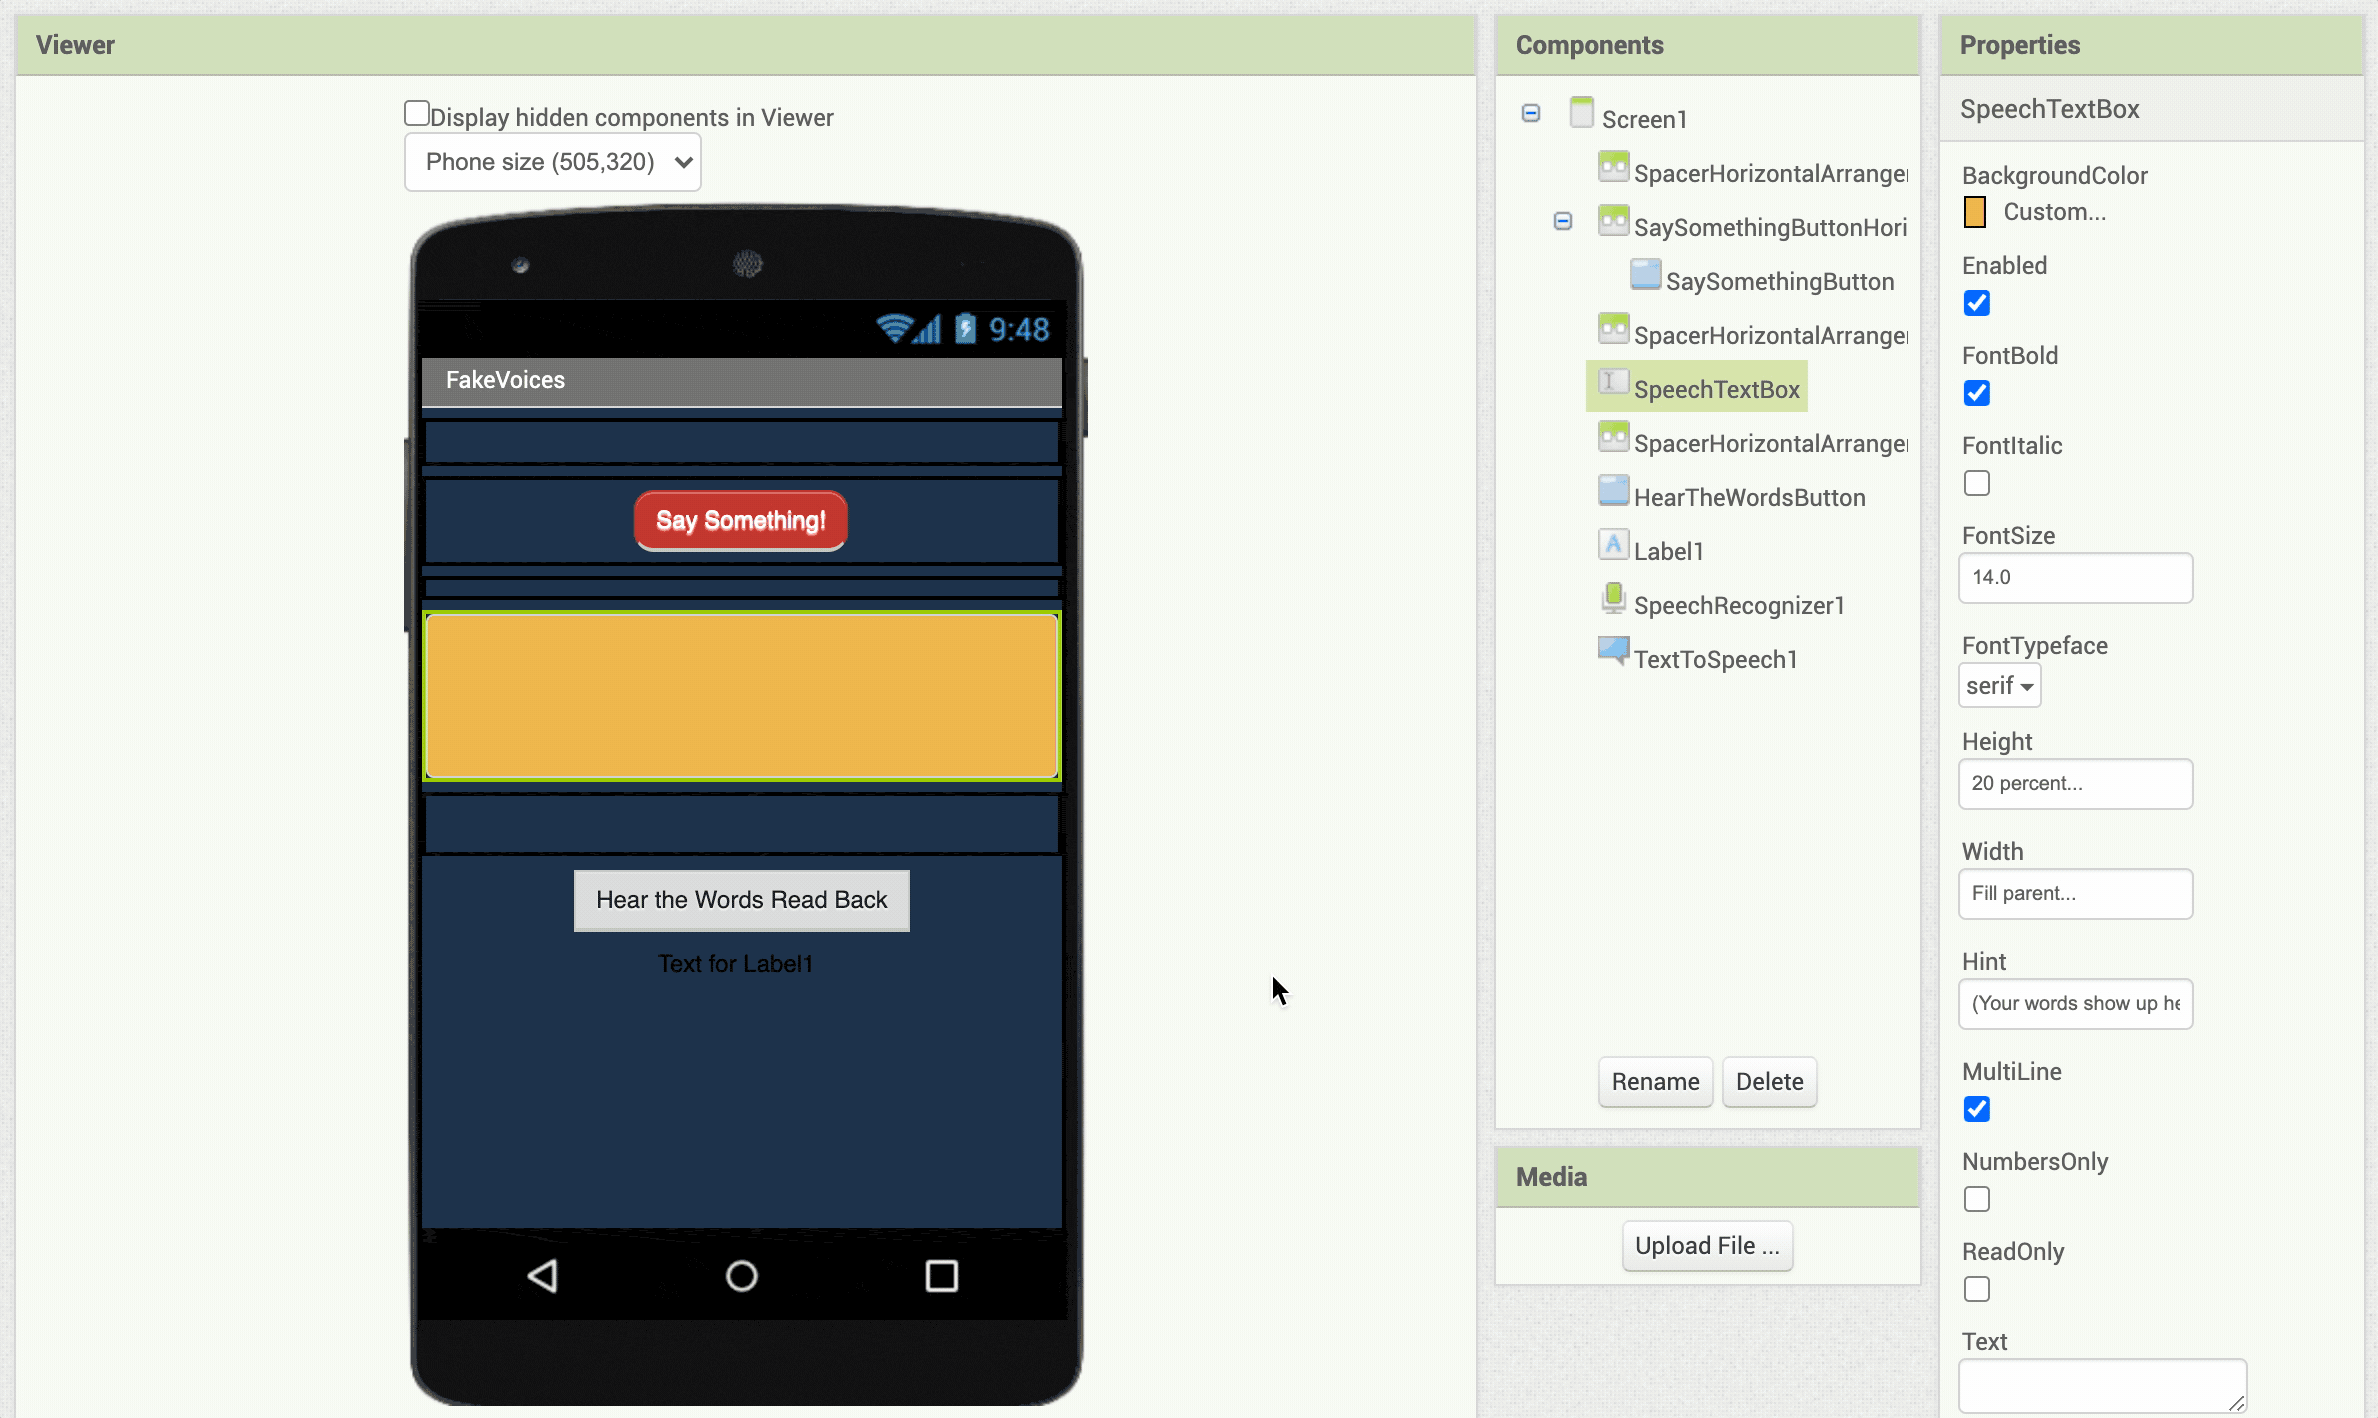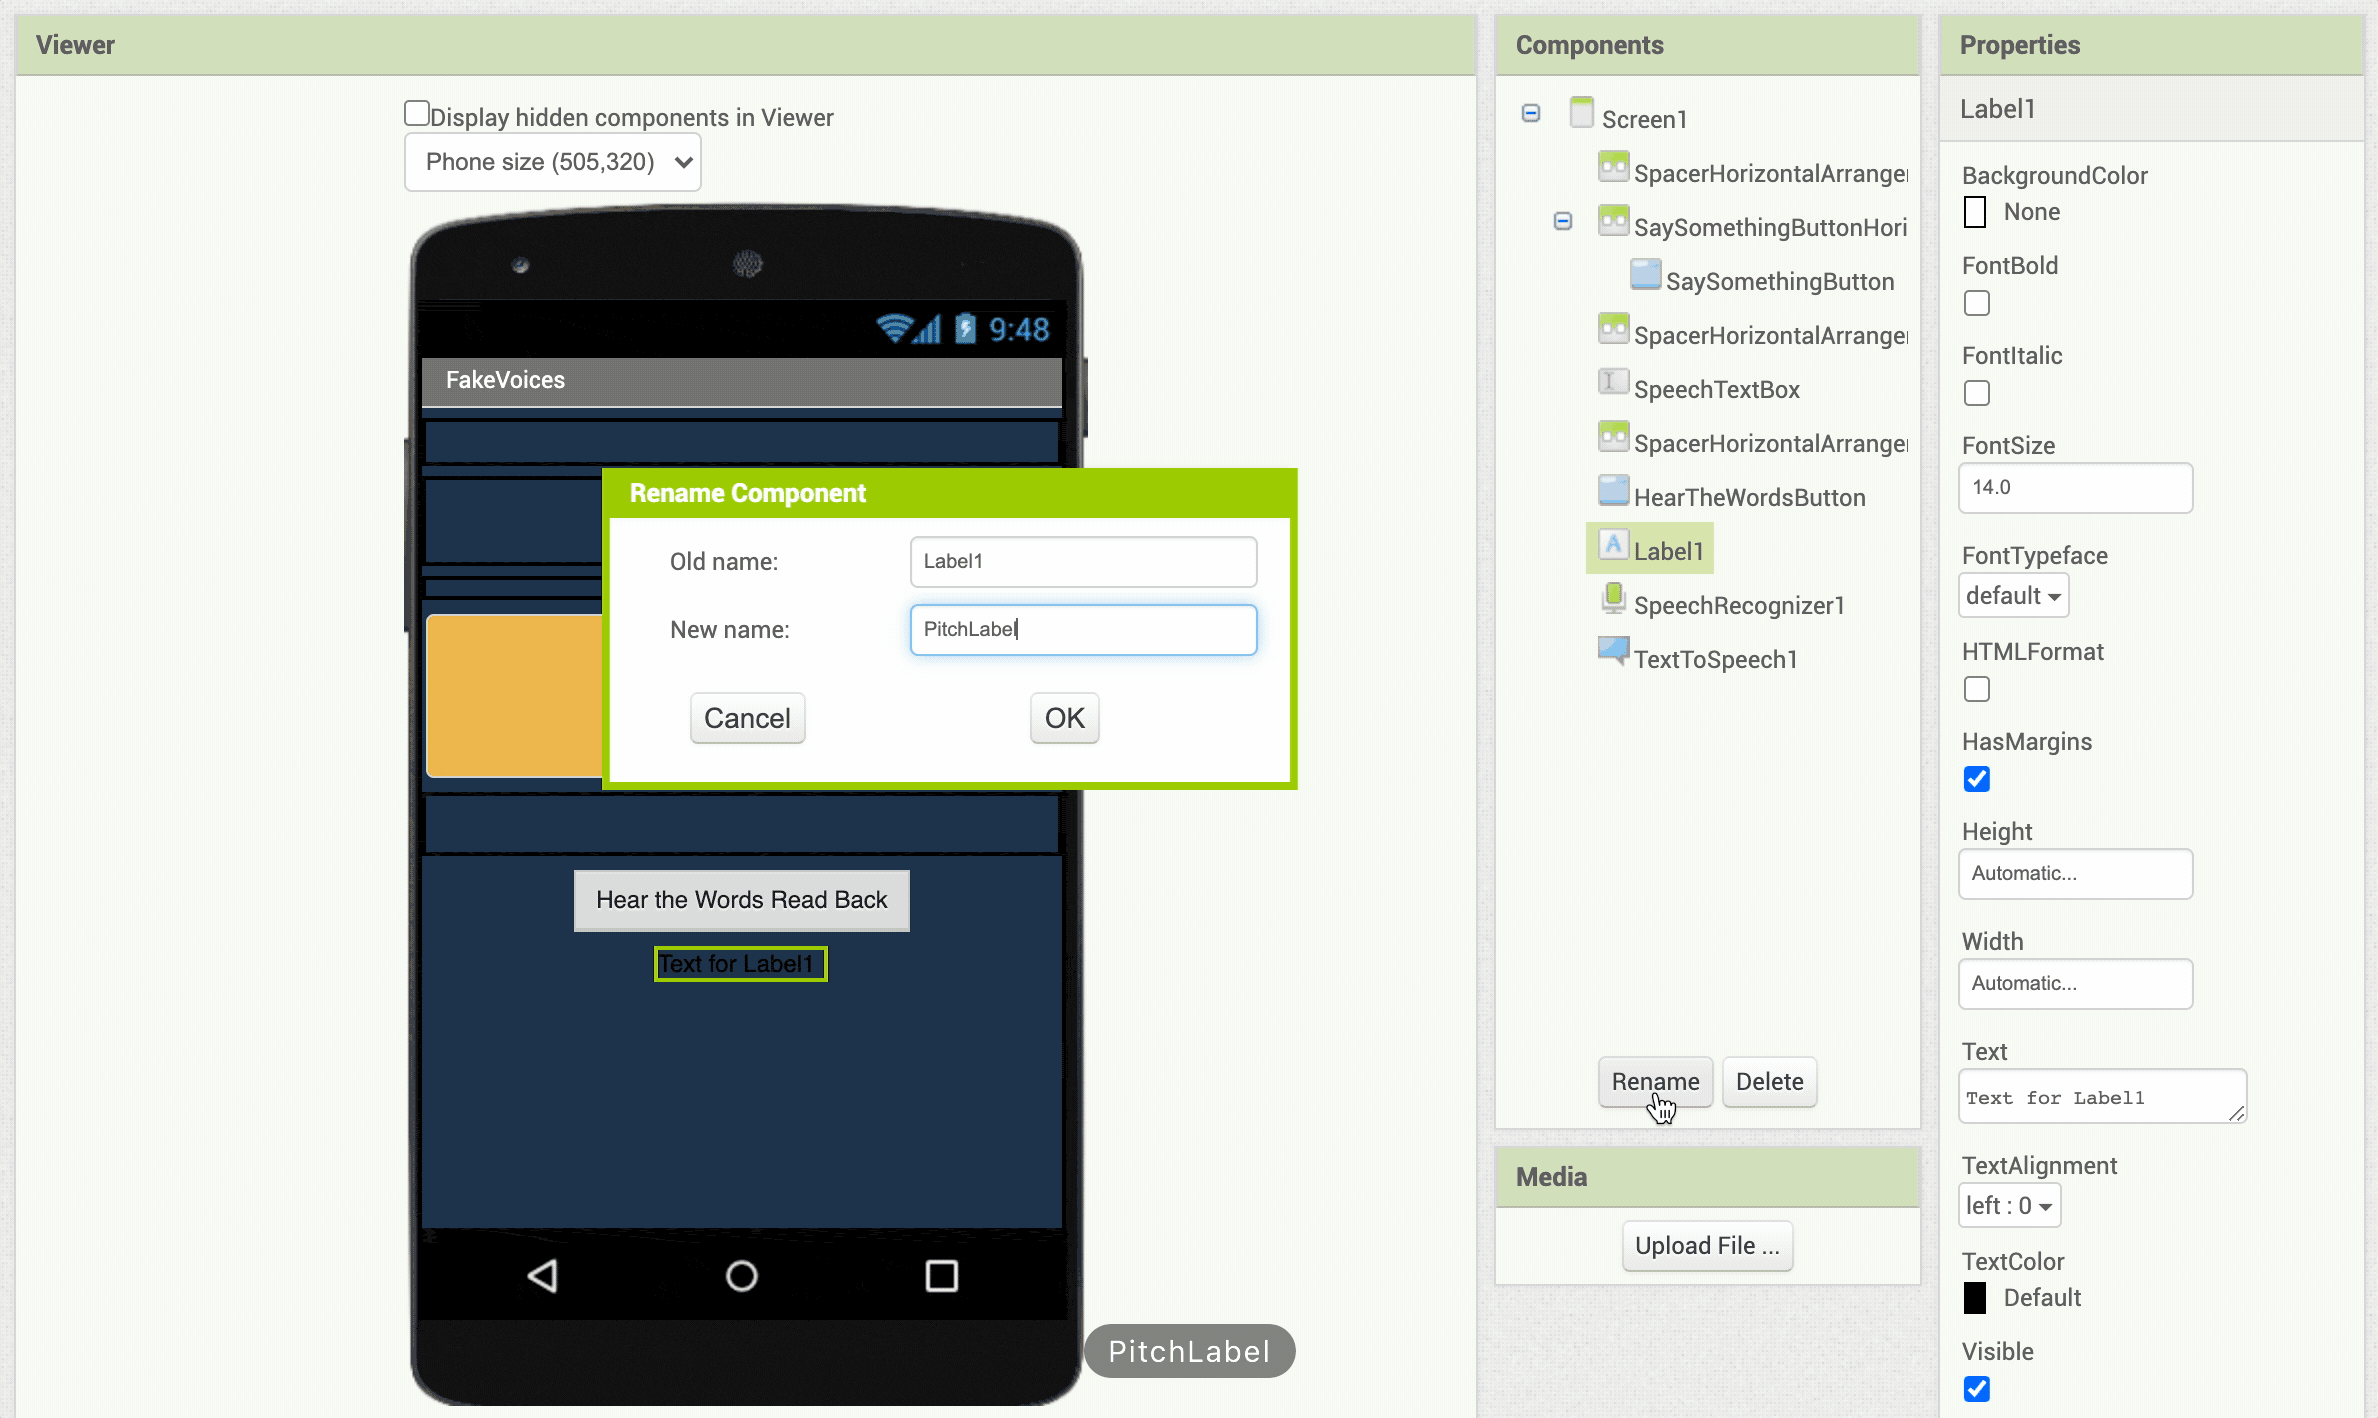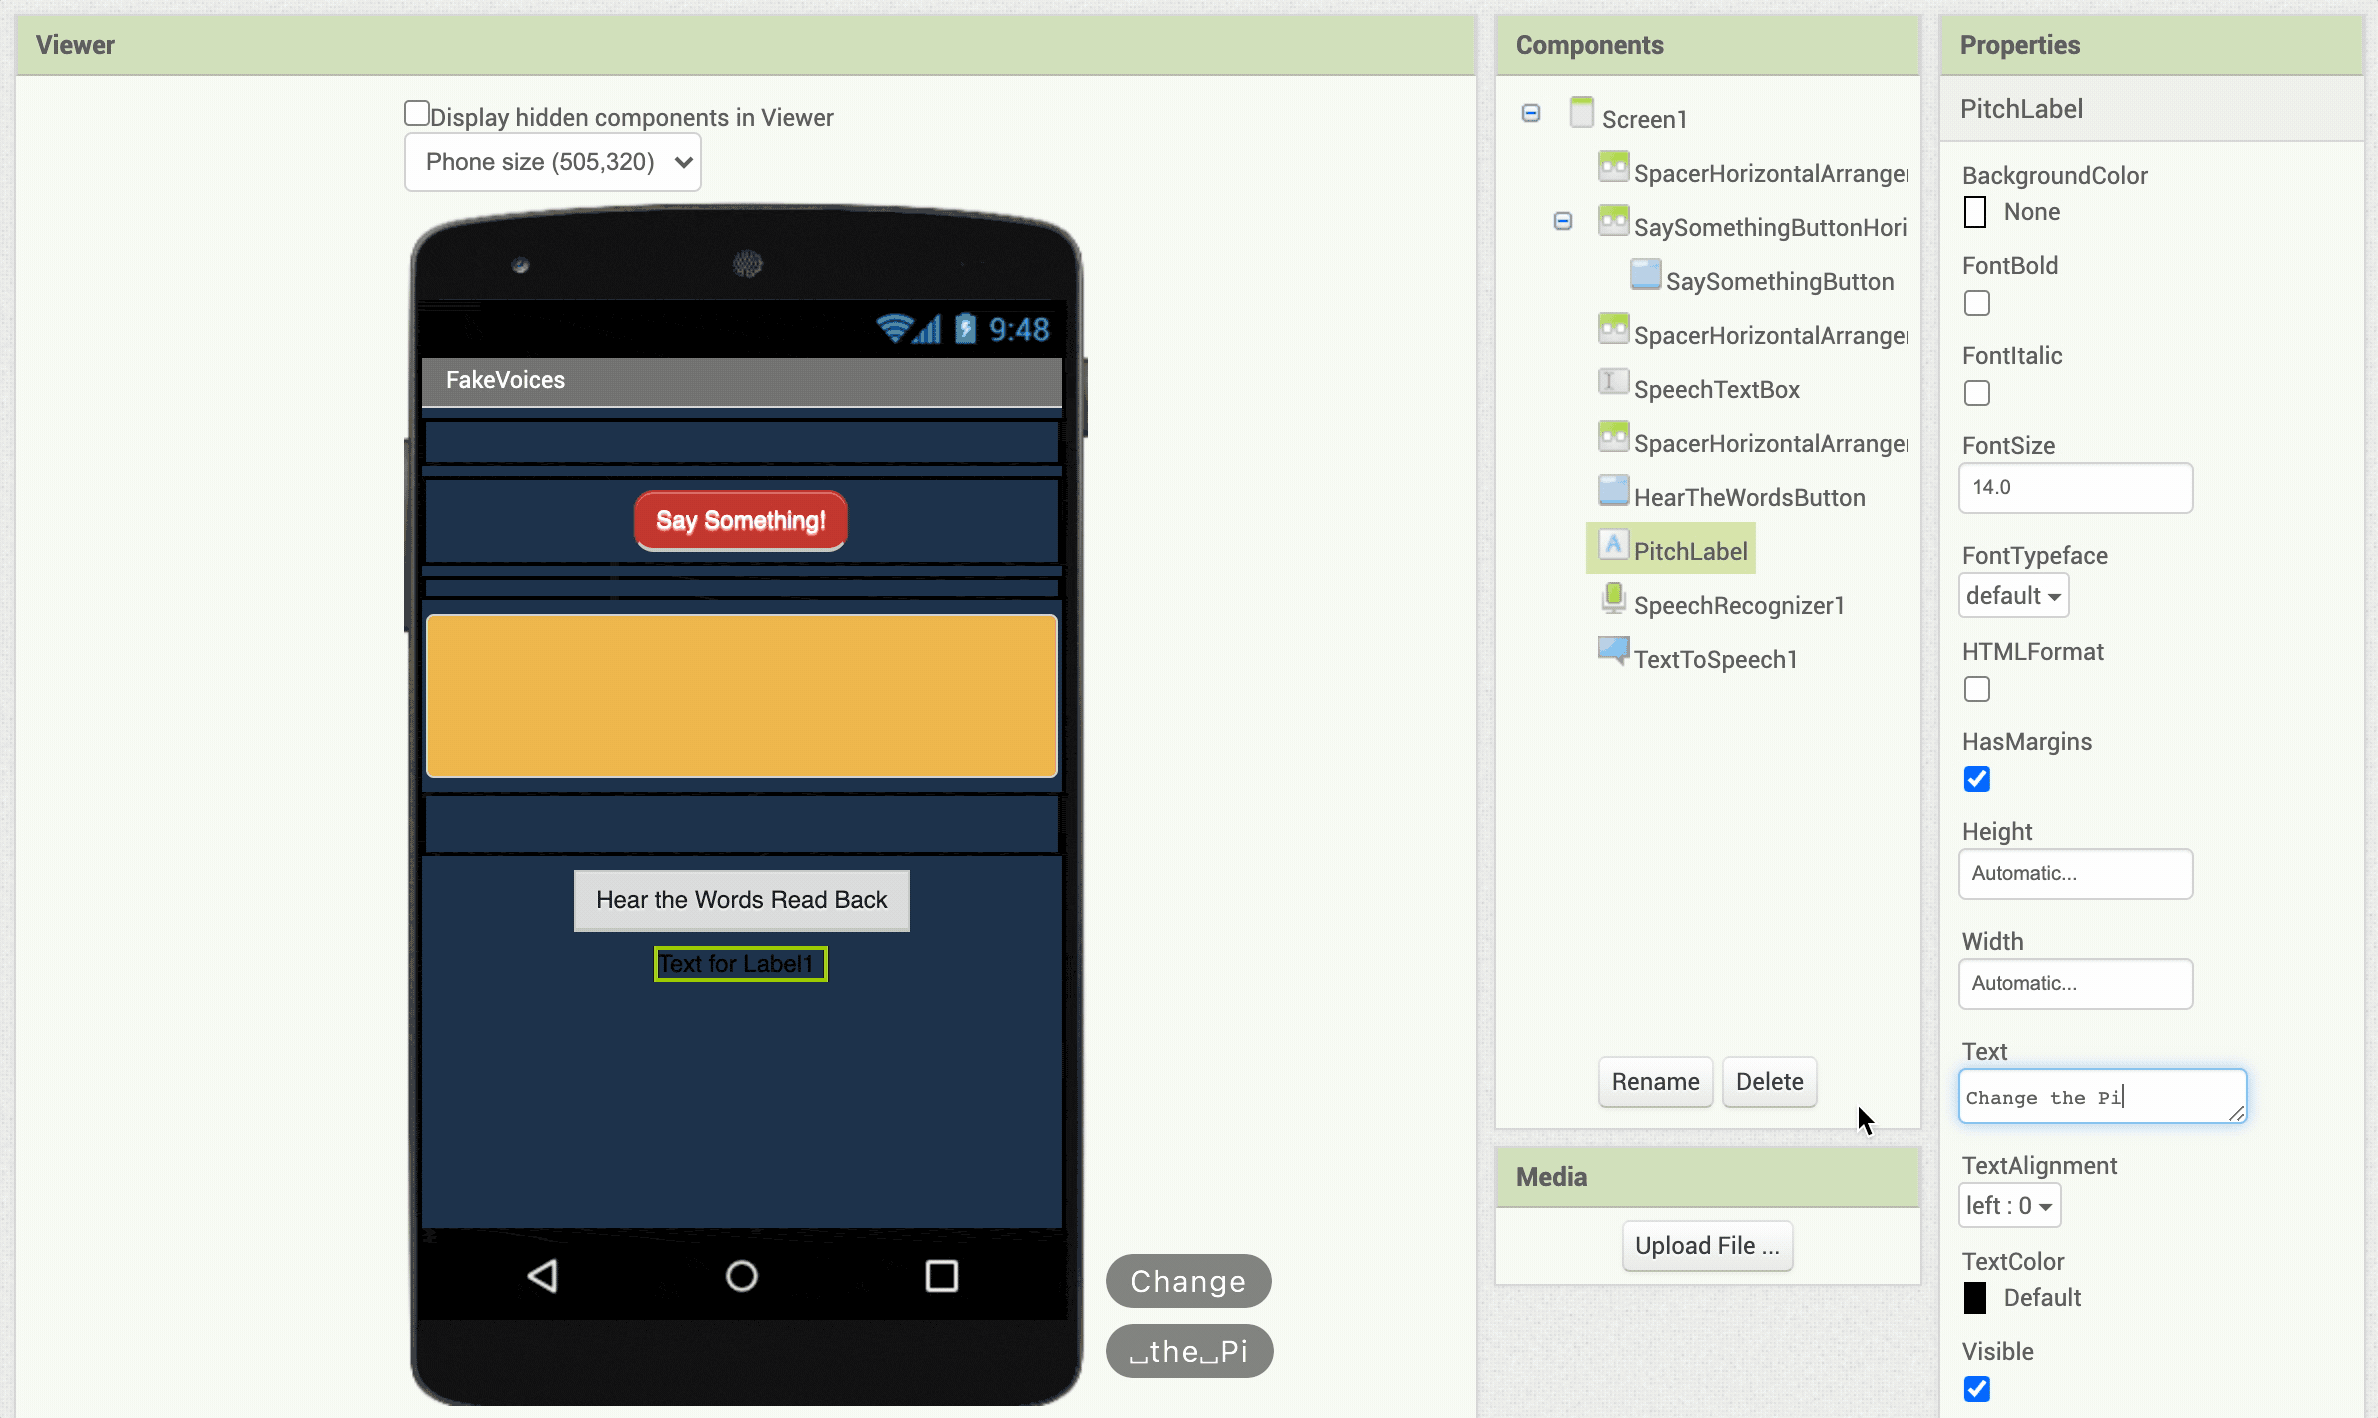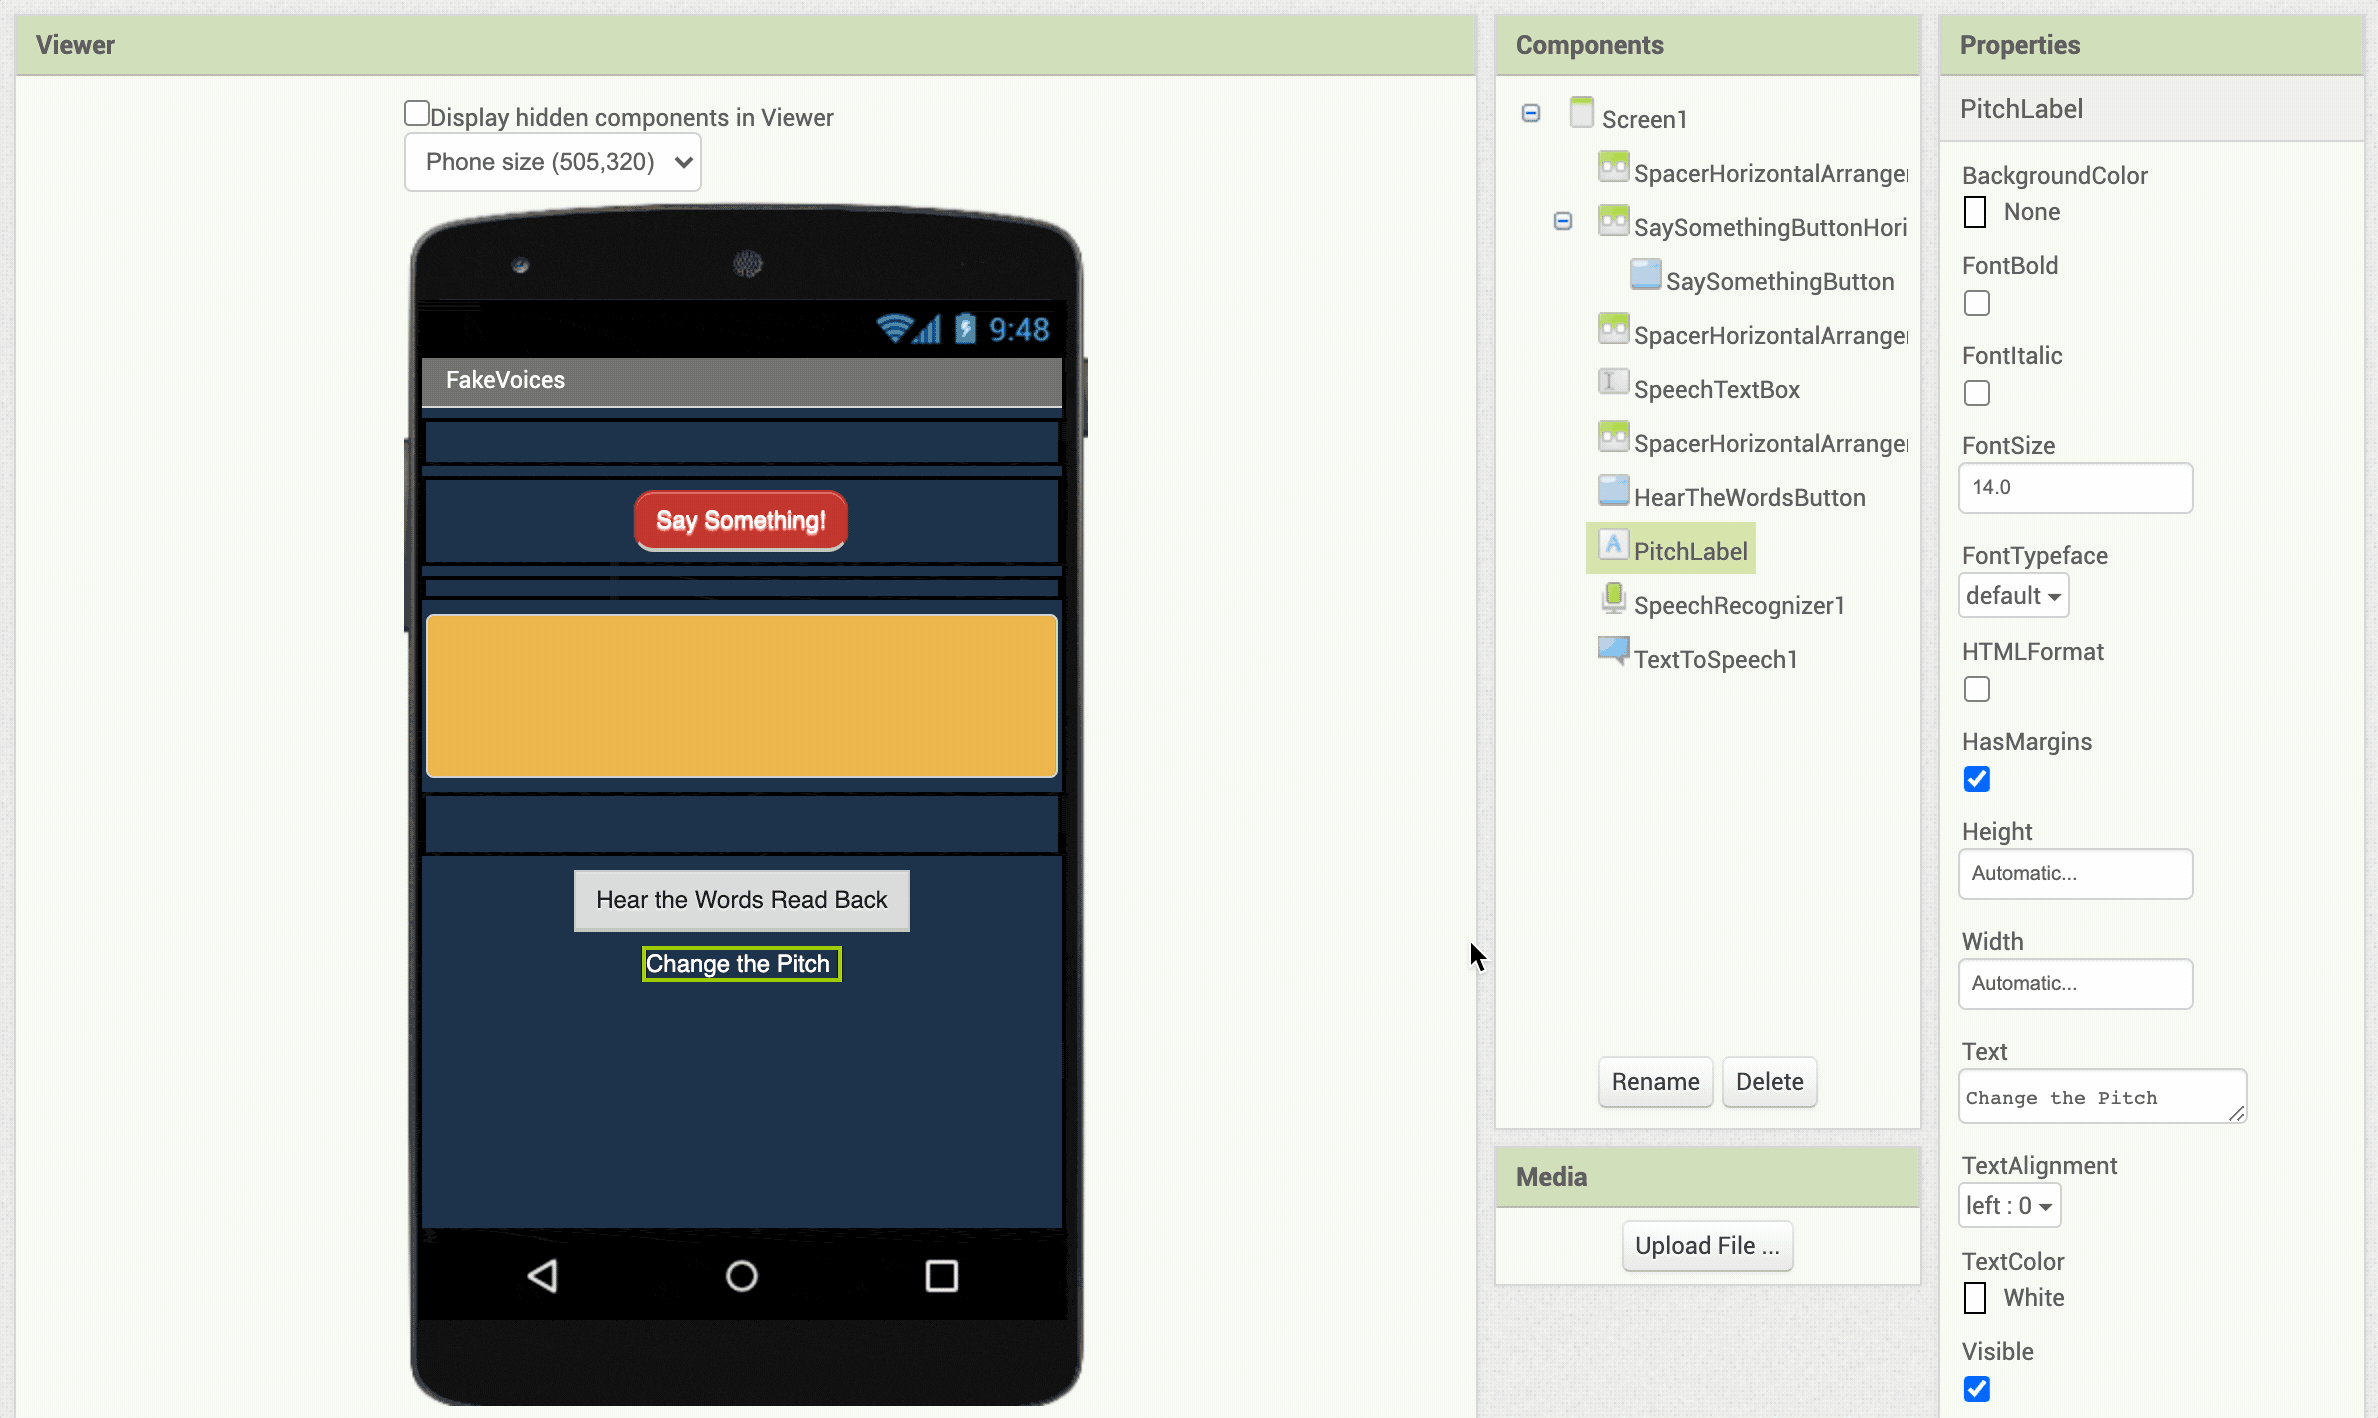
组件面板是组件抽屉,预览区显示手机界面,组件列表列出当前工程里的组件,媒体资源管理图片和声音,属性面板用来修改选中组件的属性。先熟悉这些区域,后面的步骤会反复使用它们。
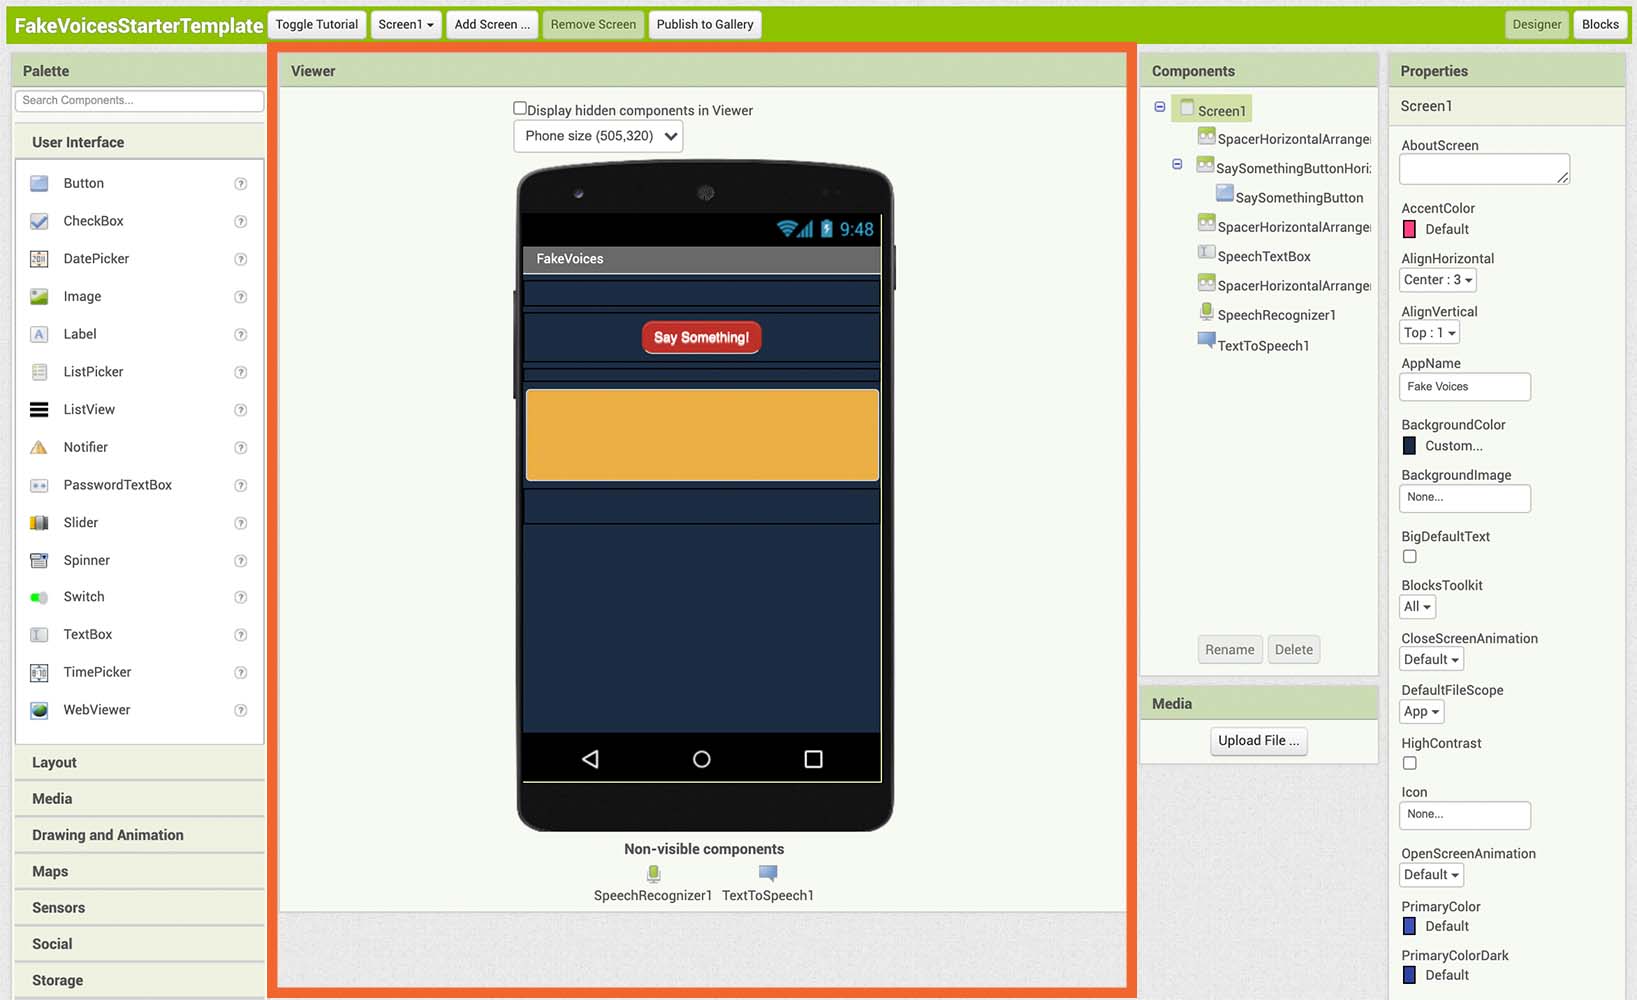
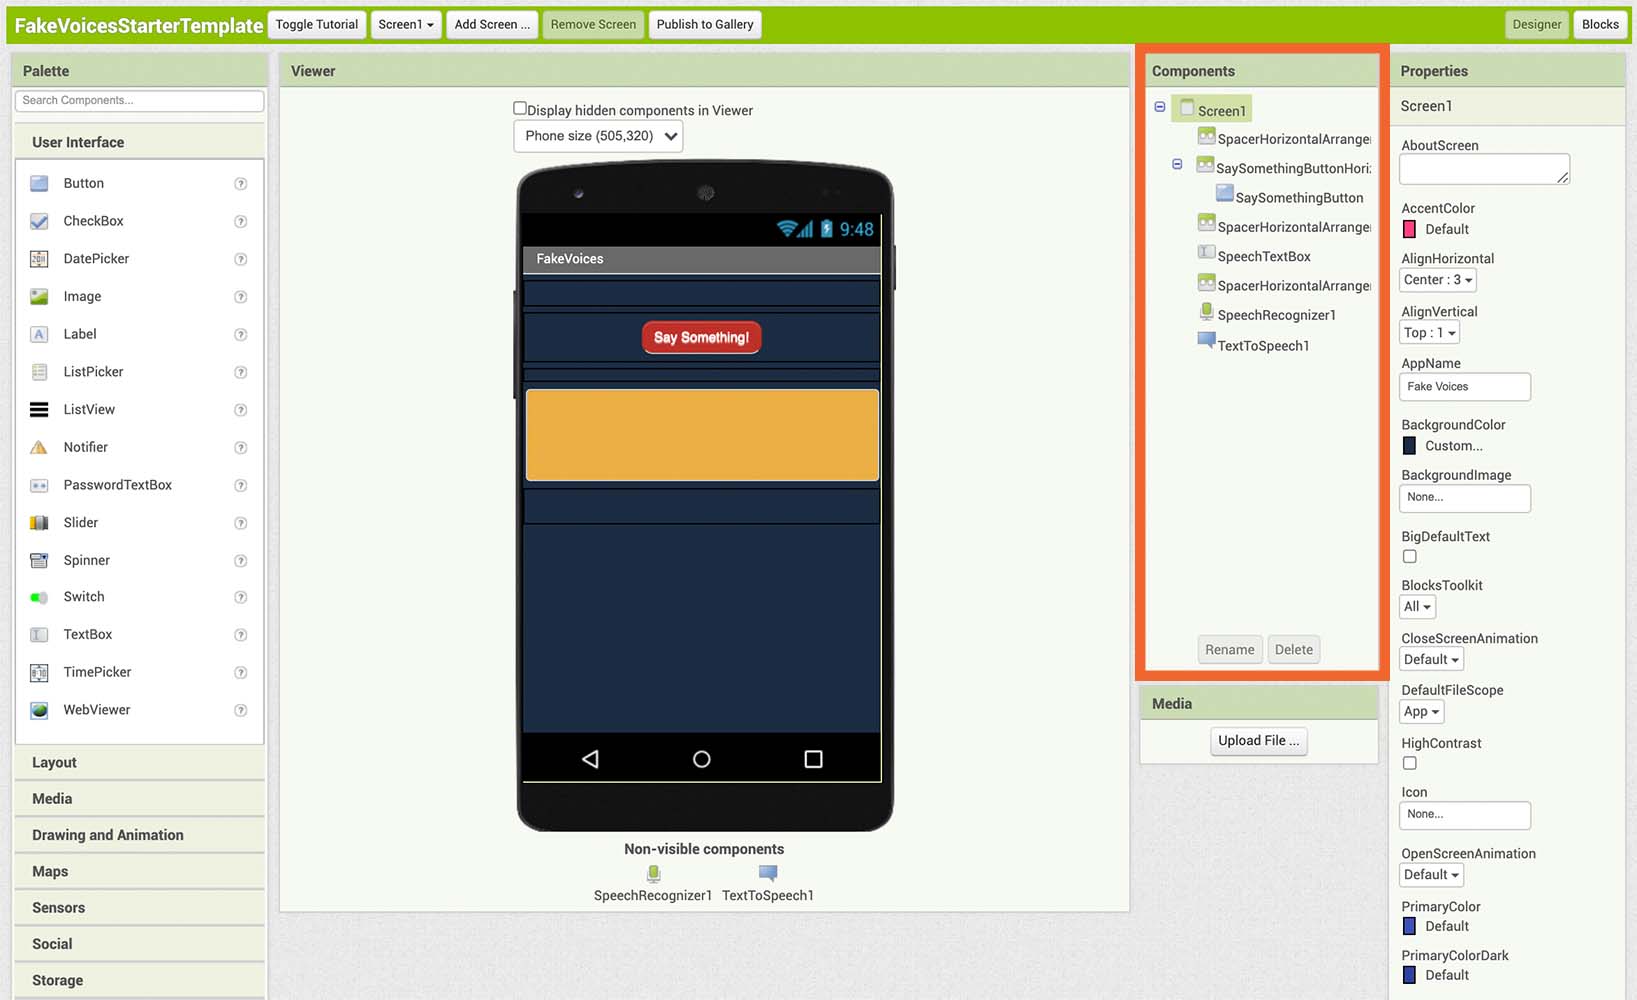
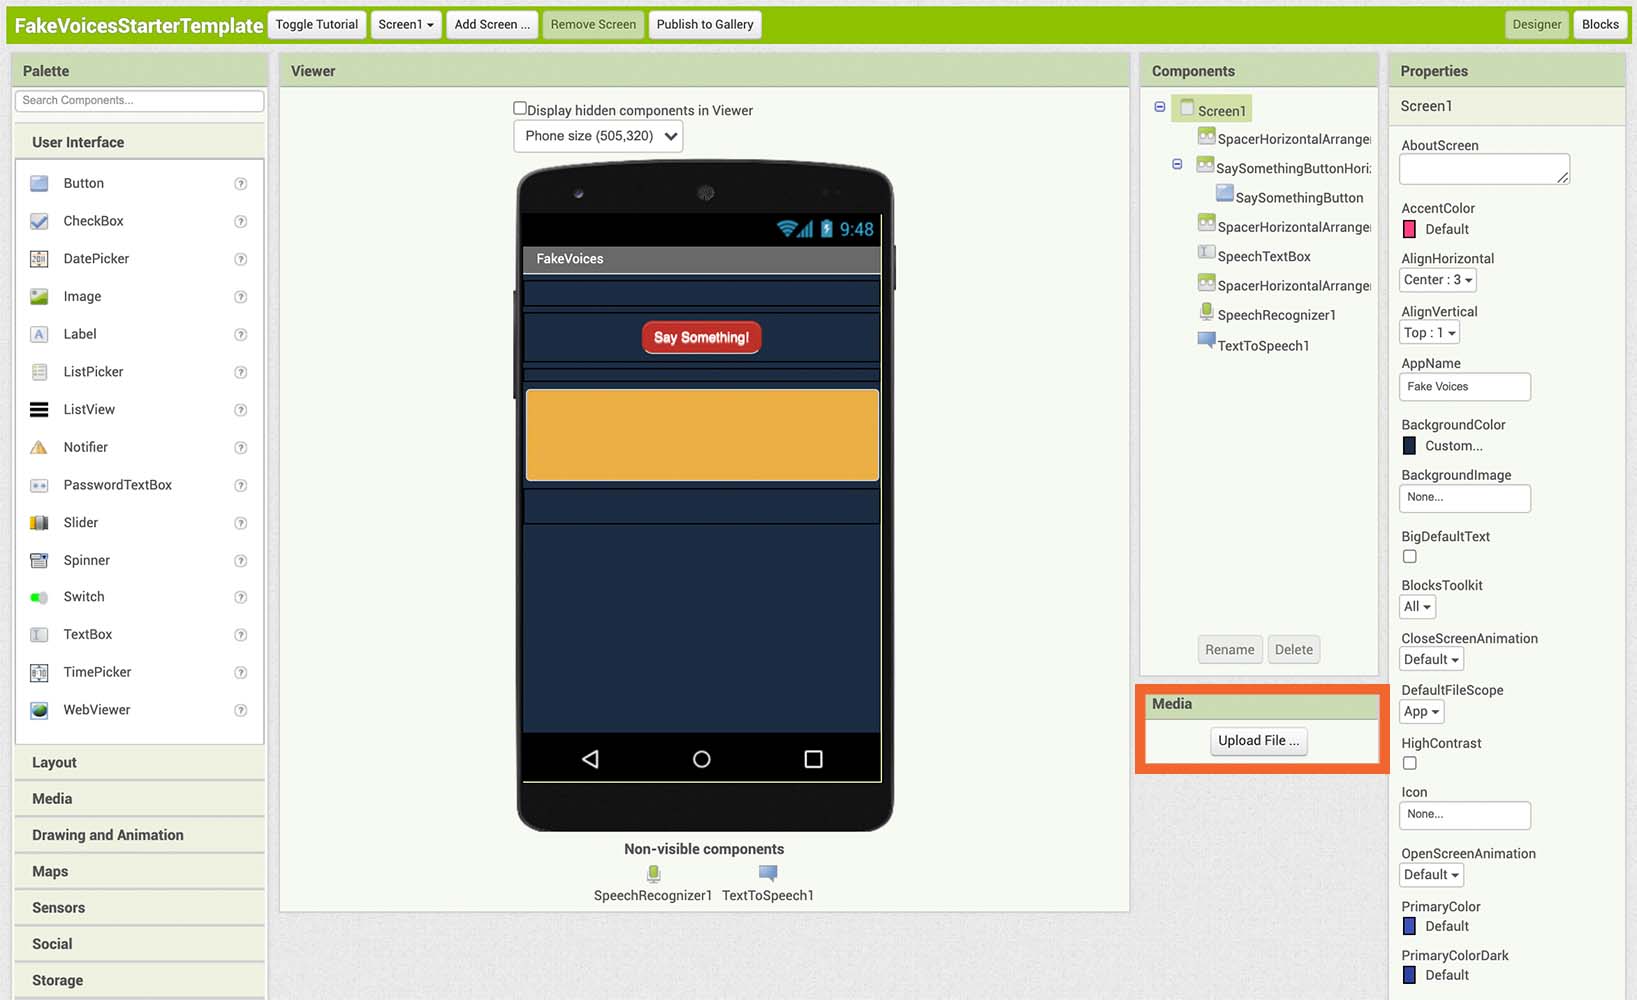
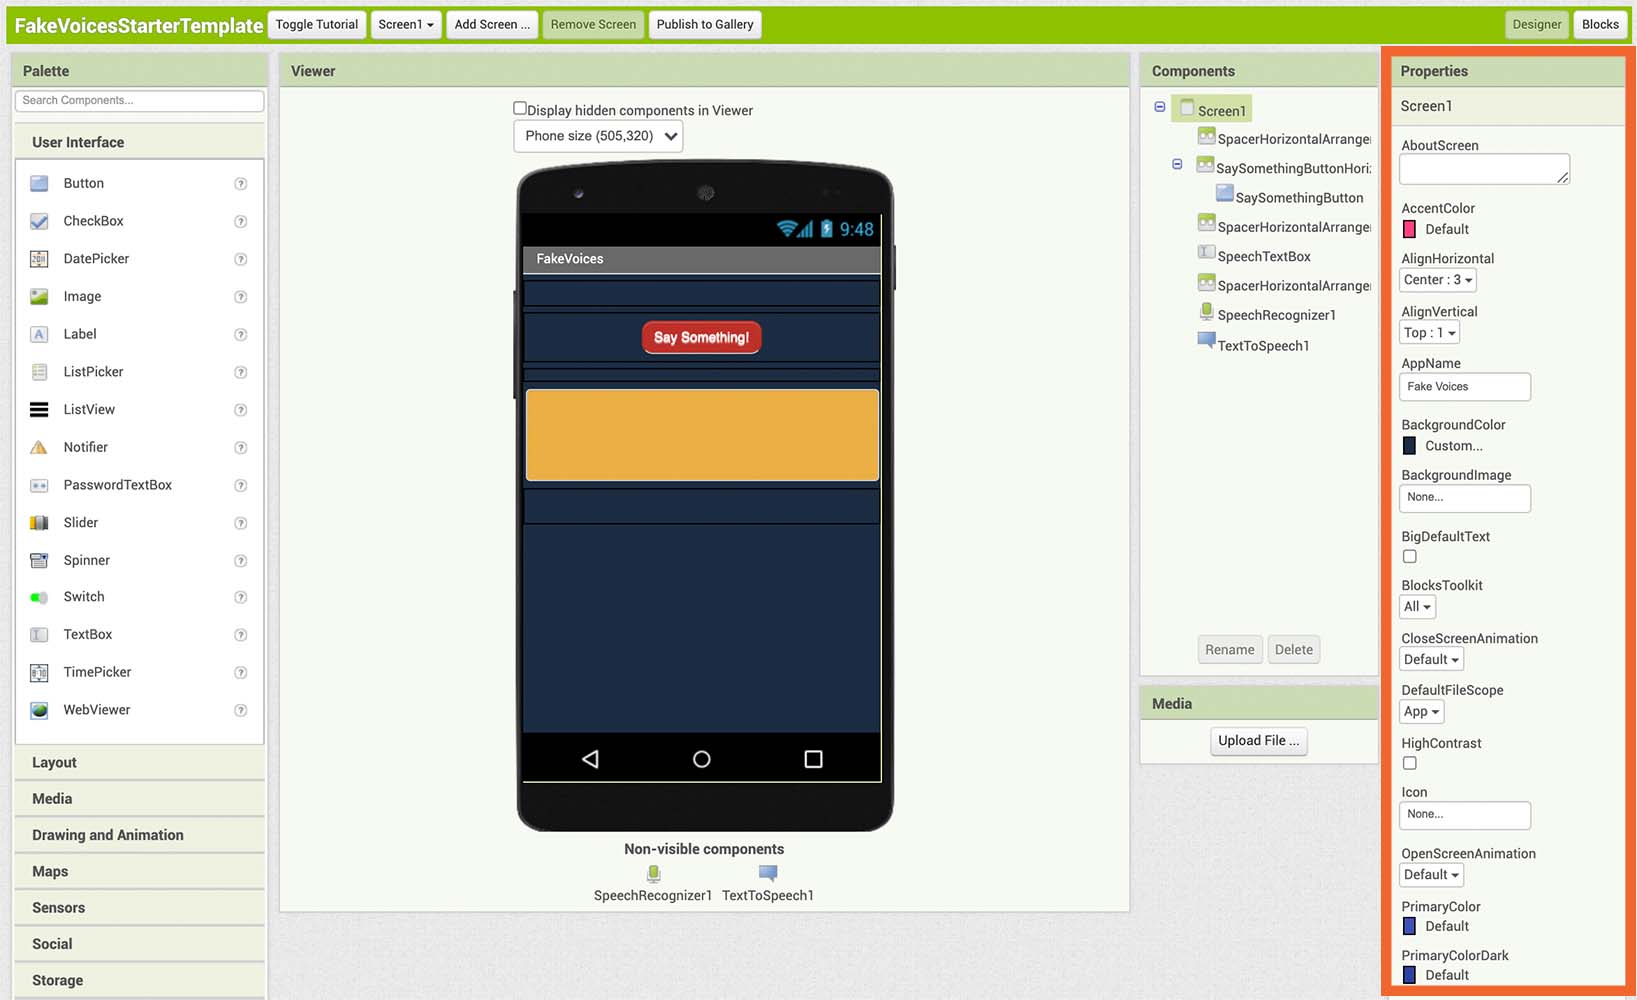
变声器教程
3. 了解最终效果
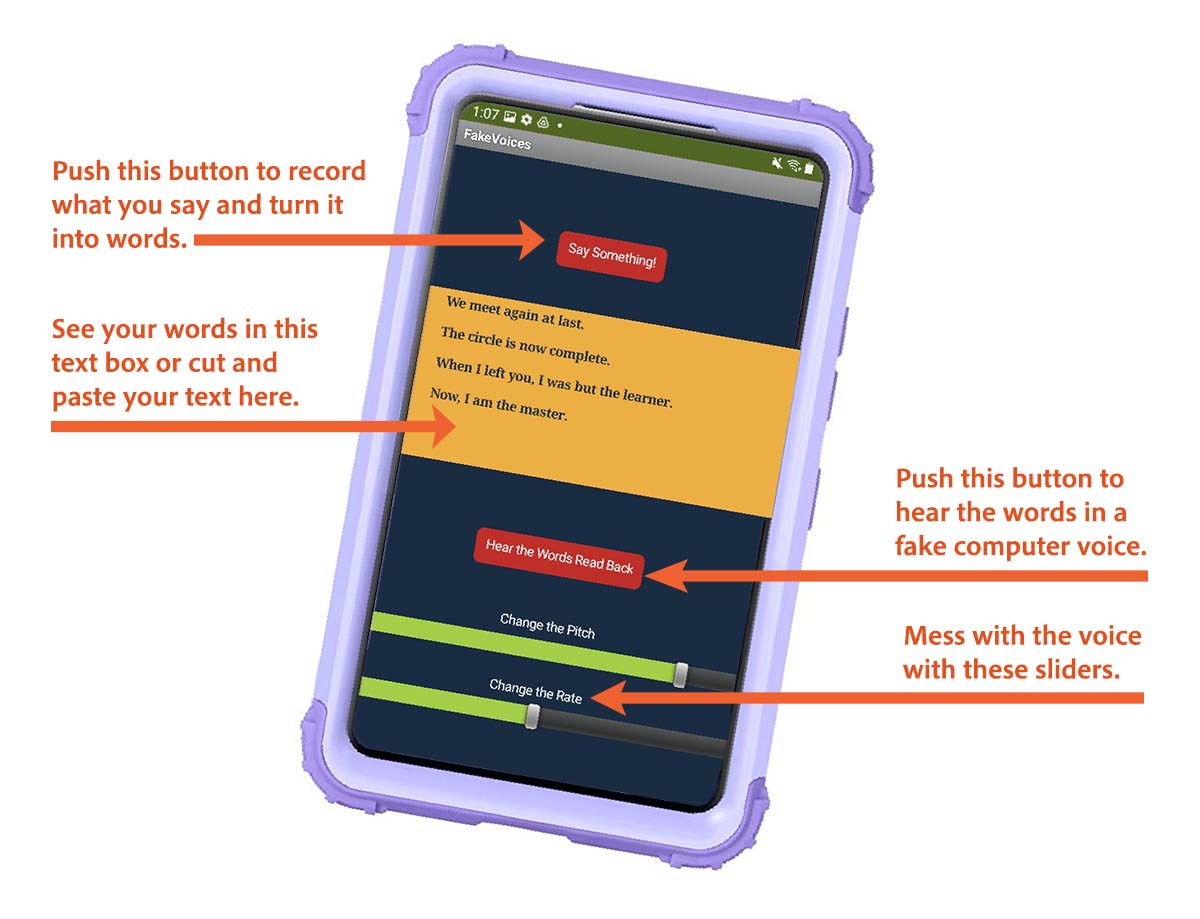
最终应用有一个语音识别按钮、文字输入框、朗读按钮和两个滑块。用户说话后,文字会出现在输入框;点击朗读按钮时,手机会按照滑块指定的音调和语速读出文字。
4. 查看起始设计
打开起始工程,在设计器中查看已经准备好的非可视组件。保持现有组件名称不变,因为积木会使用 SpeechRecognizer1、SpeechTextBox、TextToSpeech1 等名称。
5. 添加朗读按钮
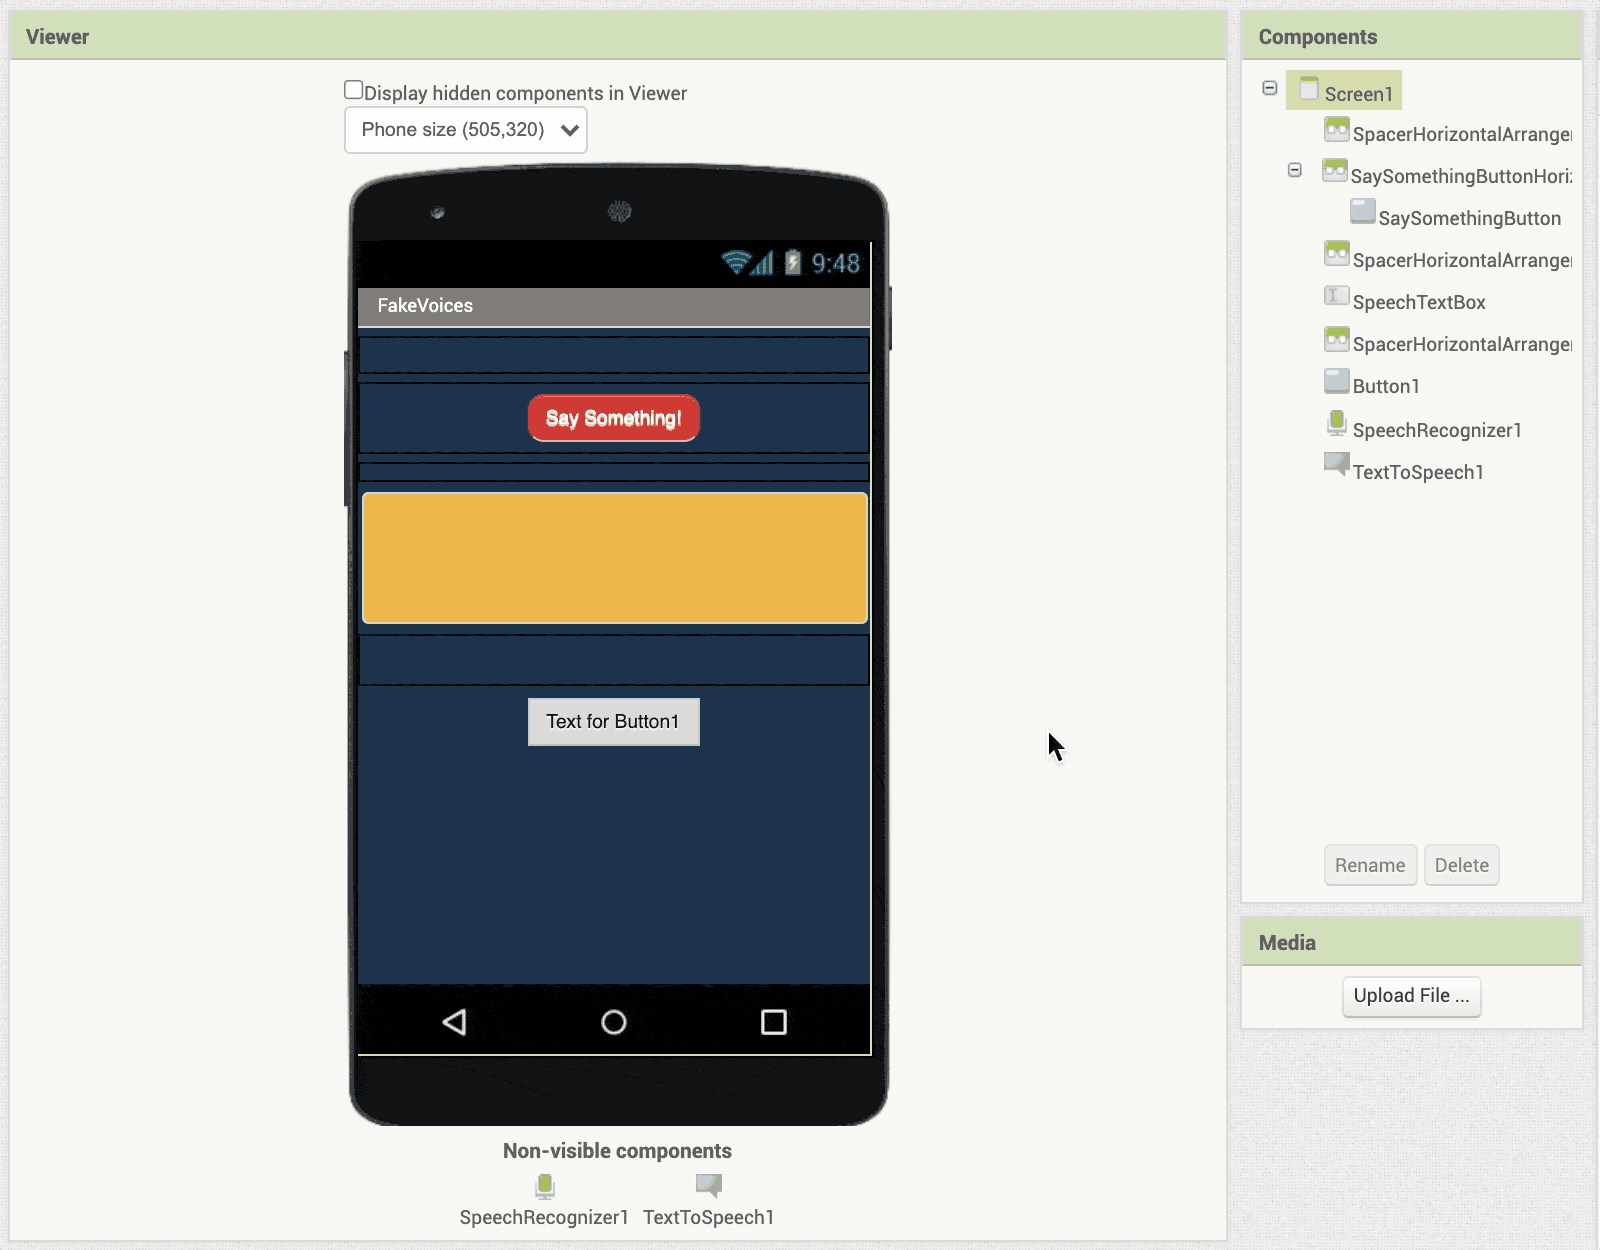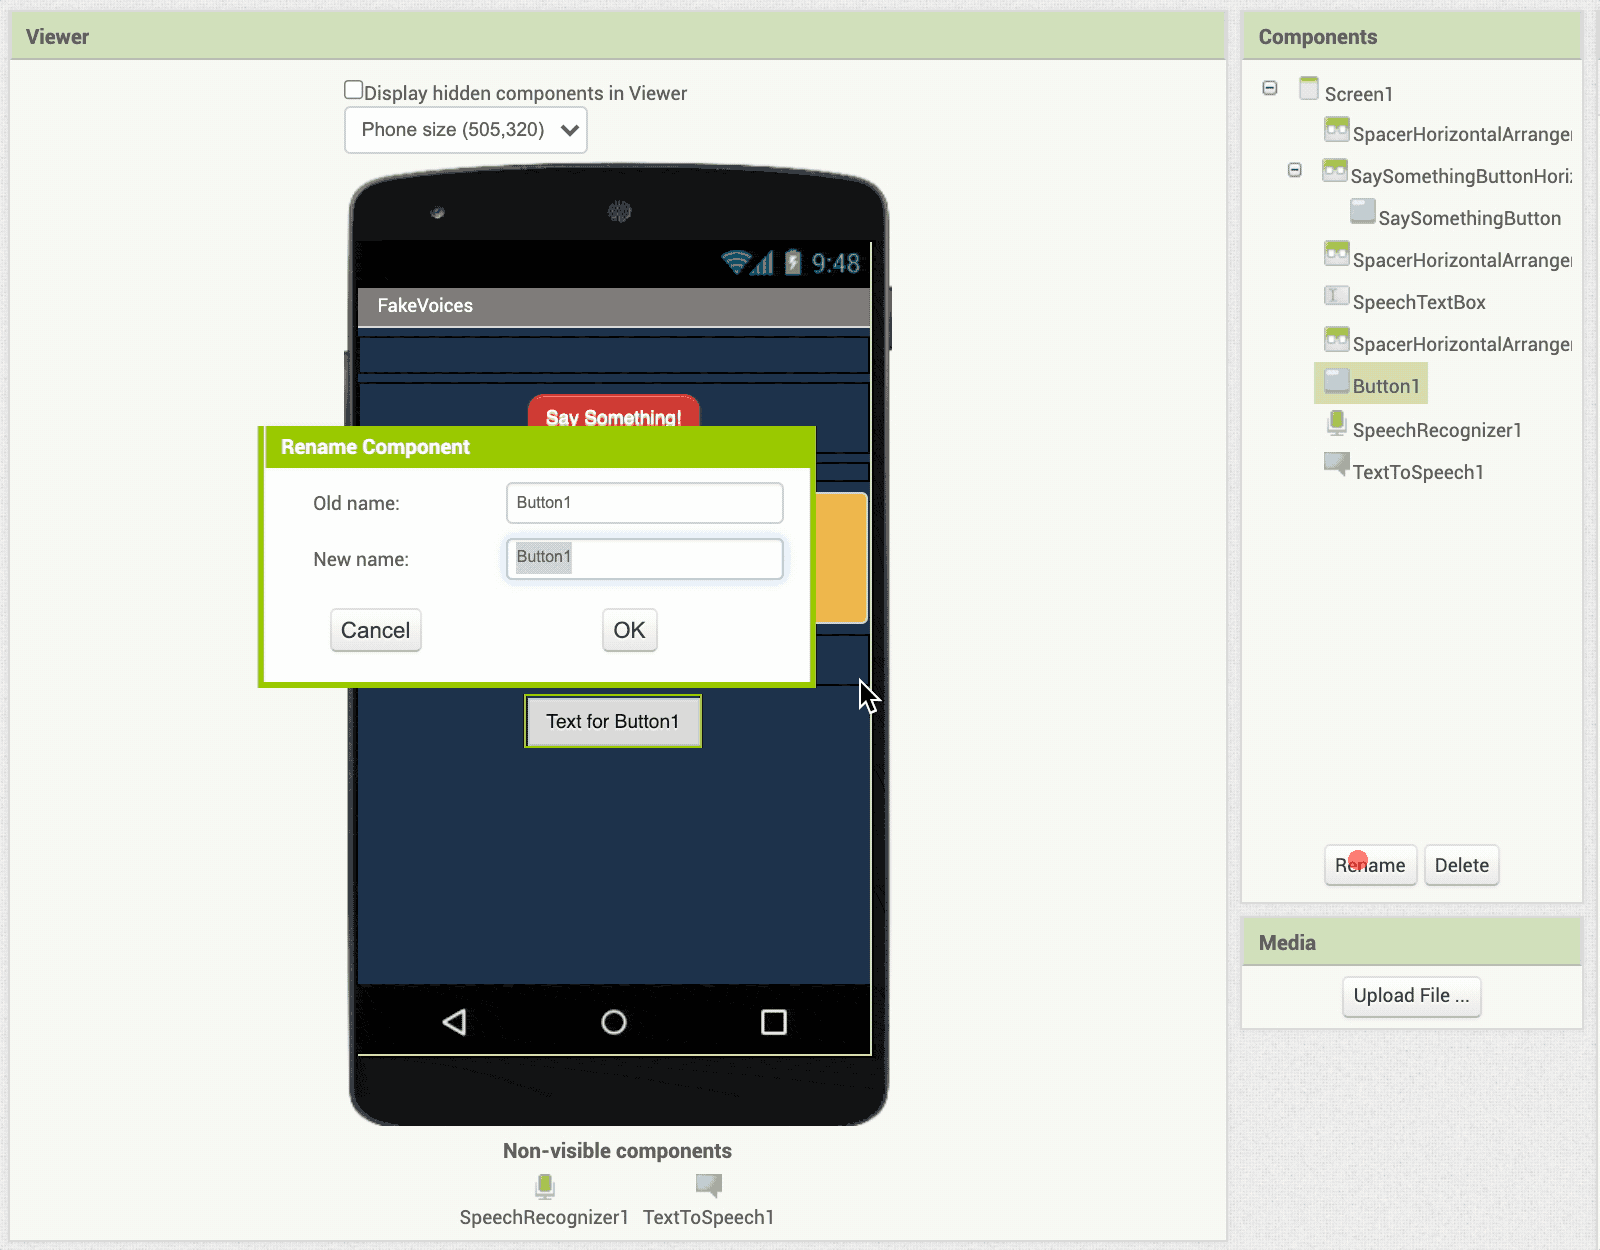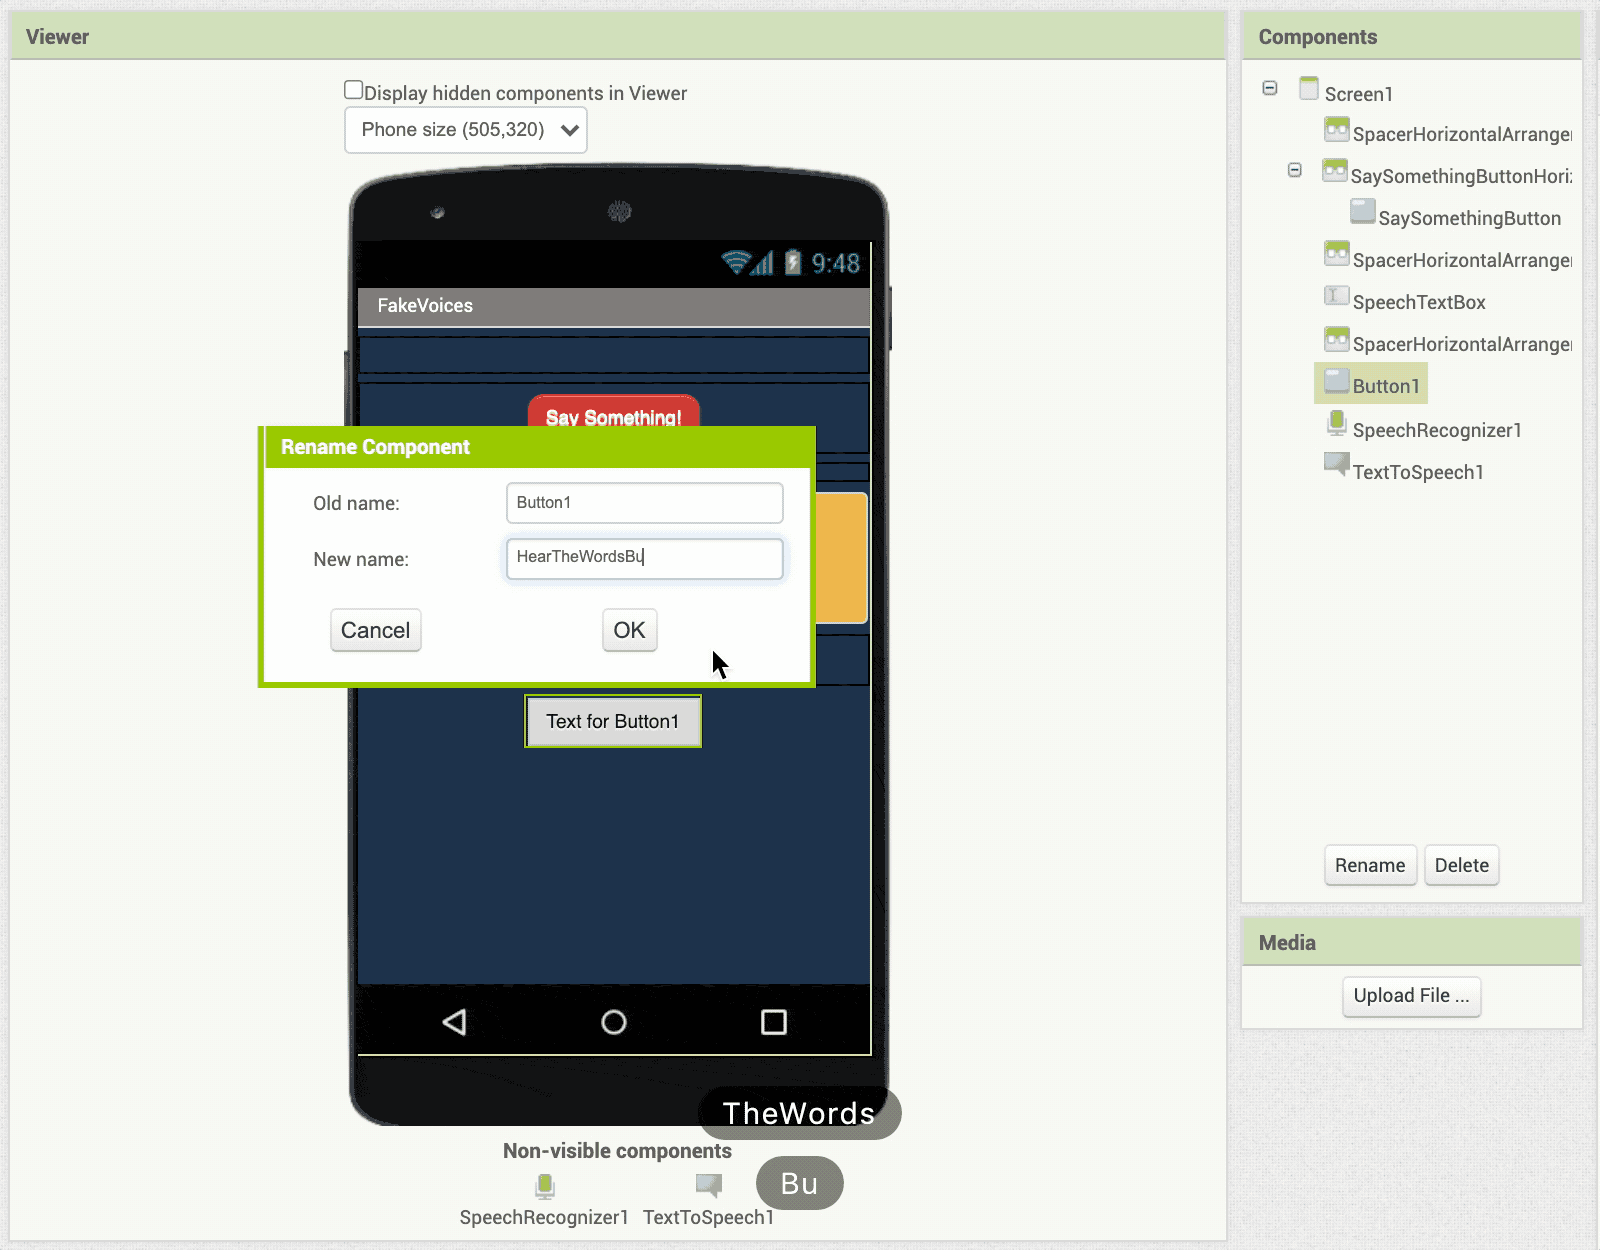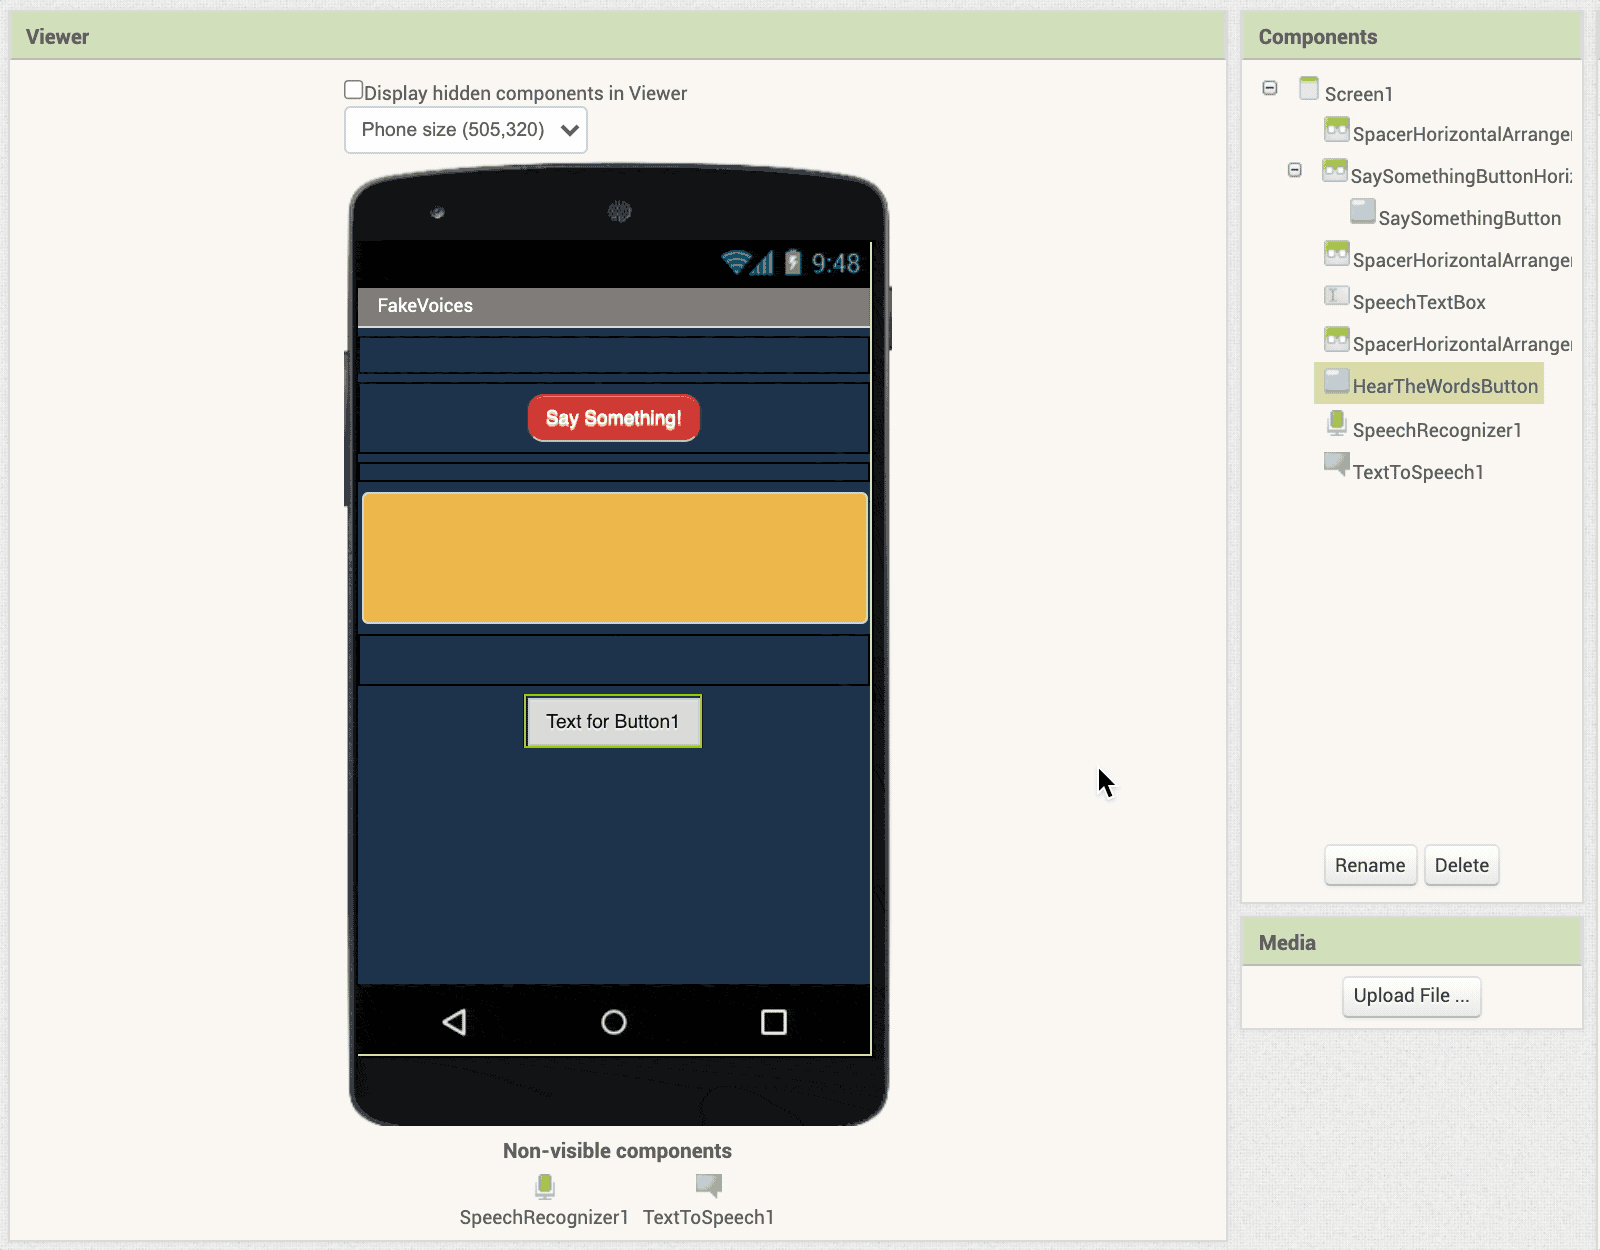
拖入一个按钮,把它重命名为 HearTheWordsButton,并将文本改为“朗读文字”。按钮只是界面入口,尚未连接程序时点击不会产生动作。
6. 创建音调滑块
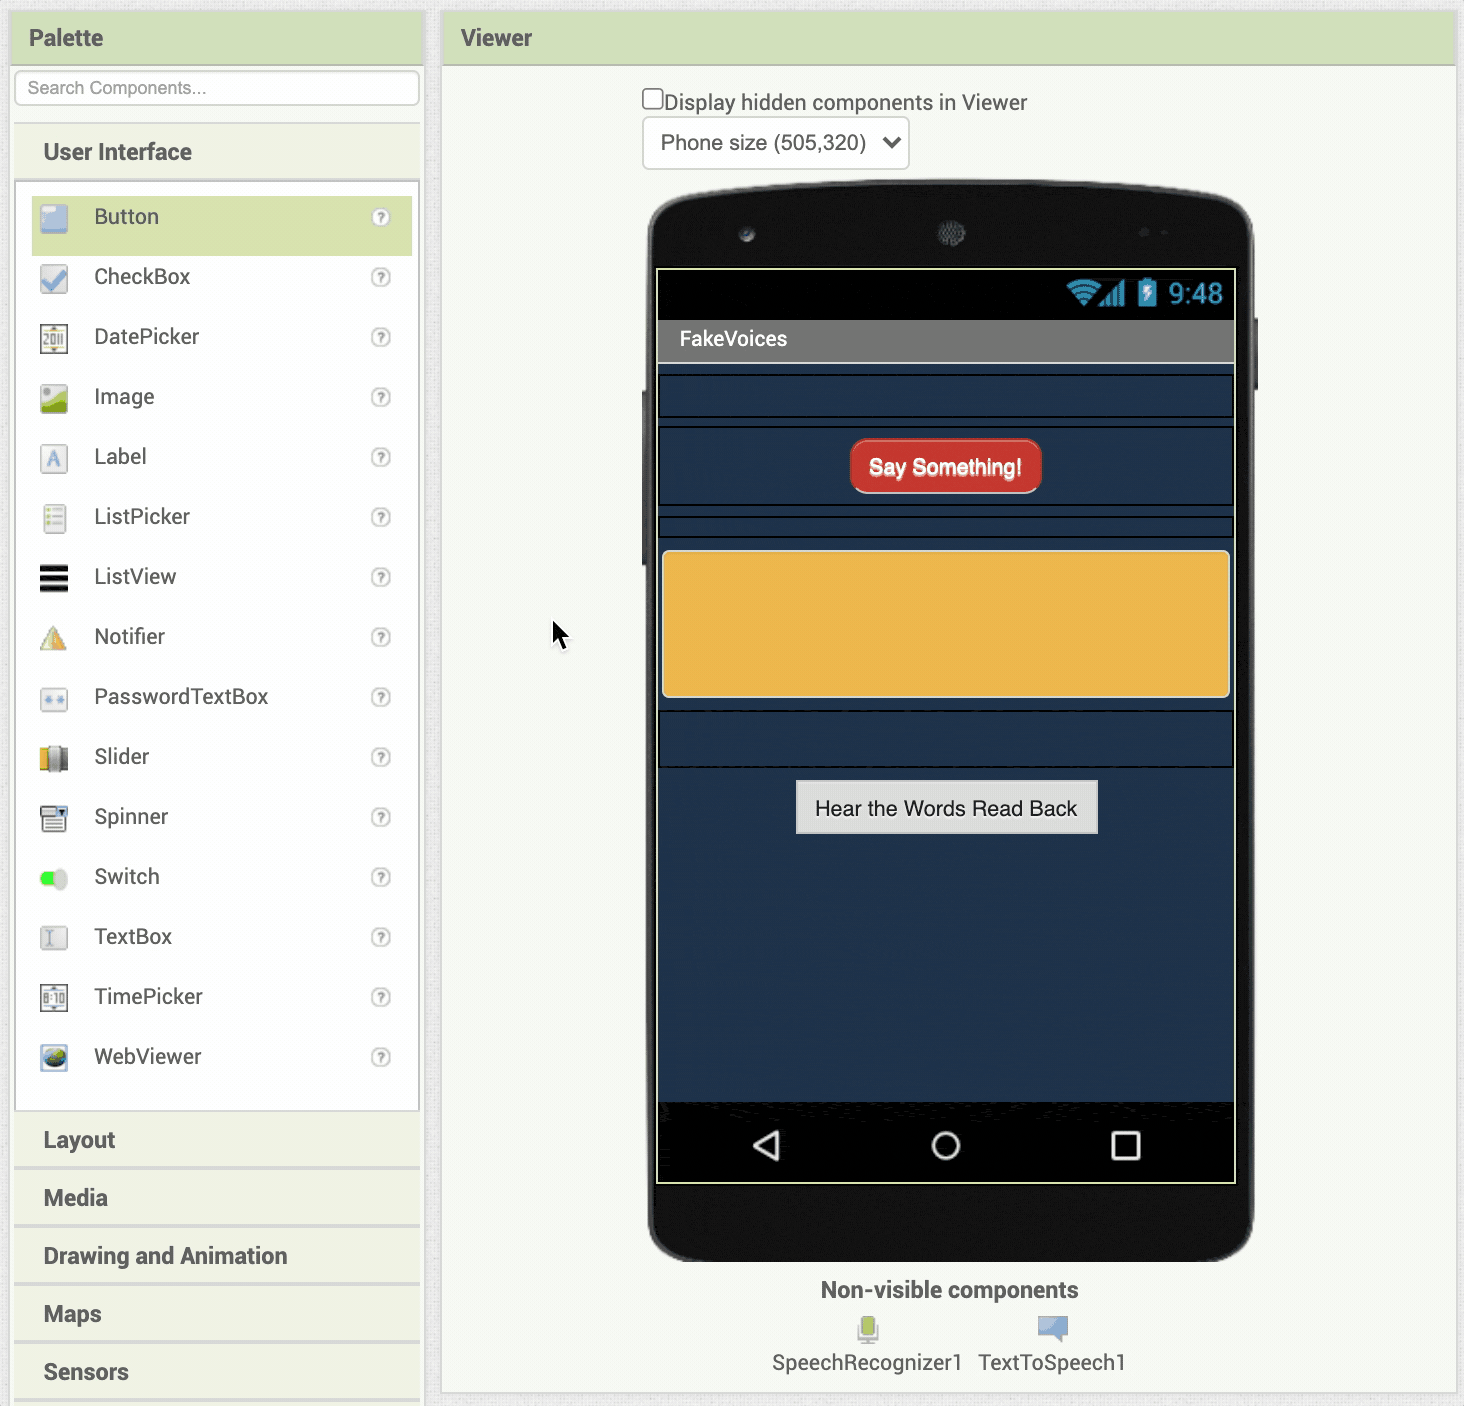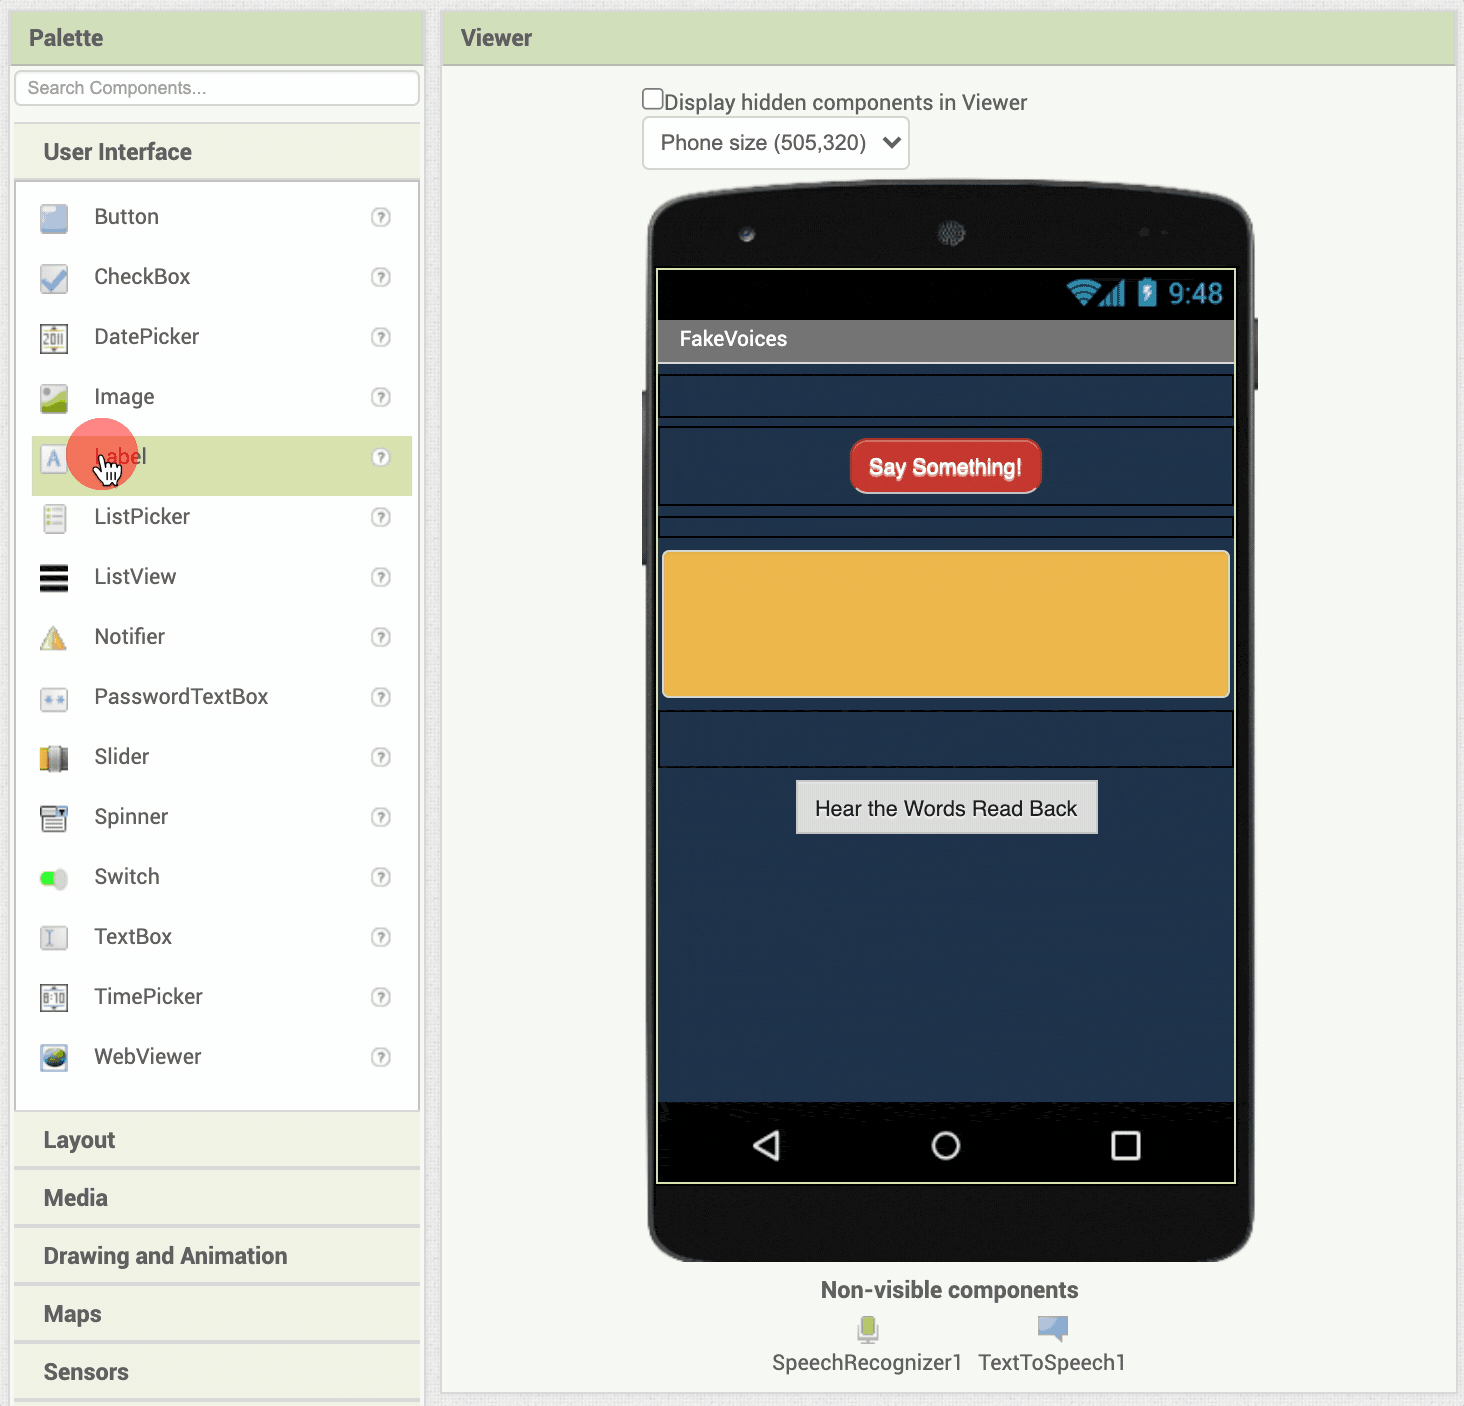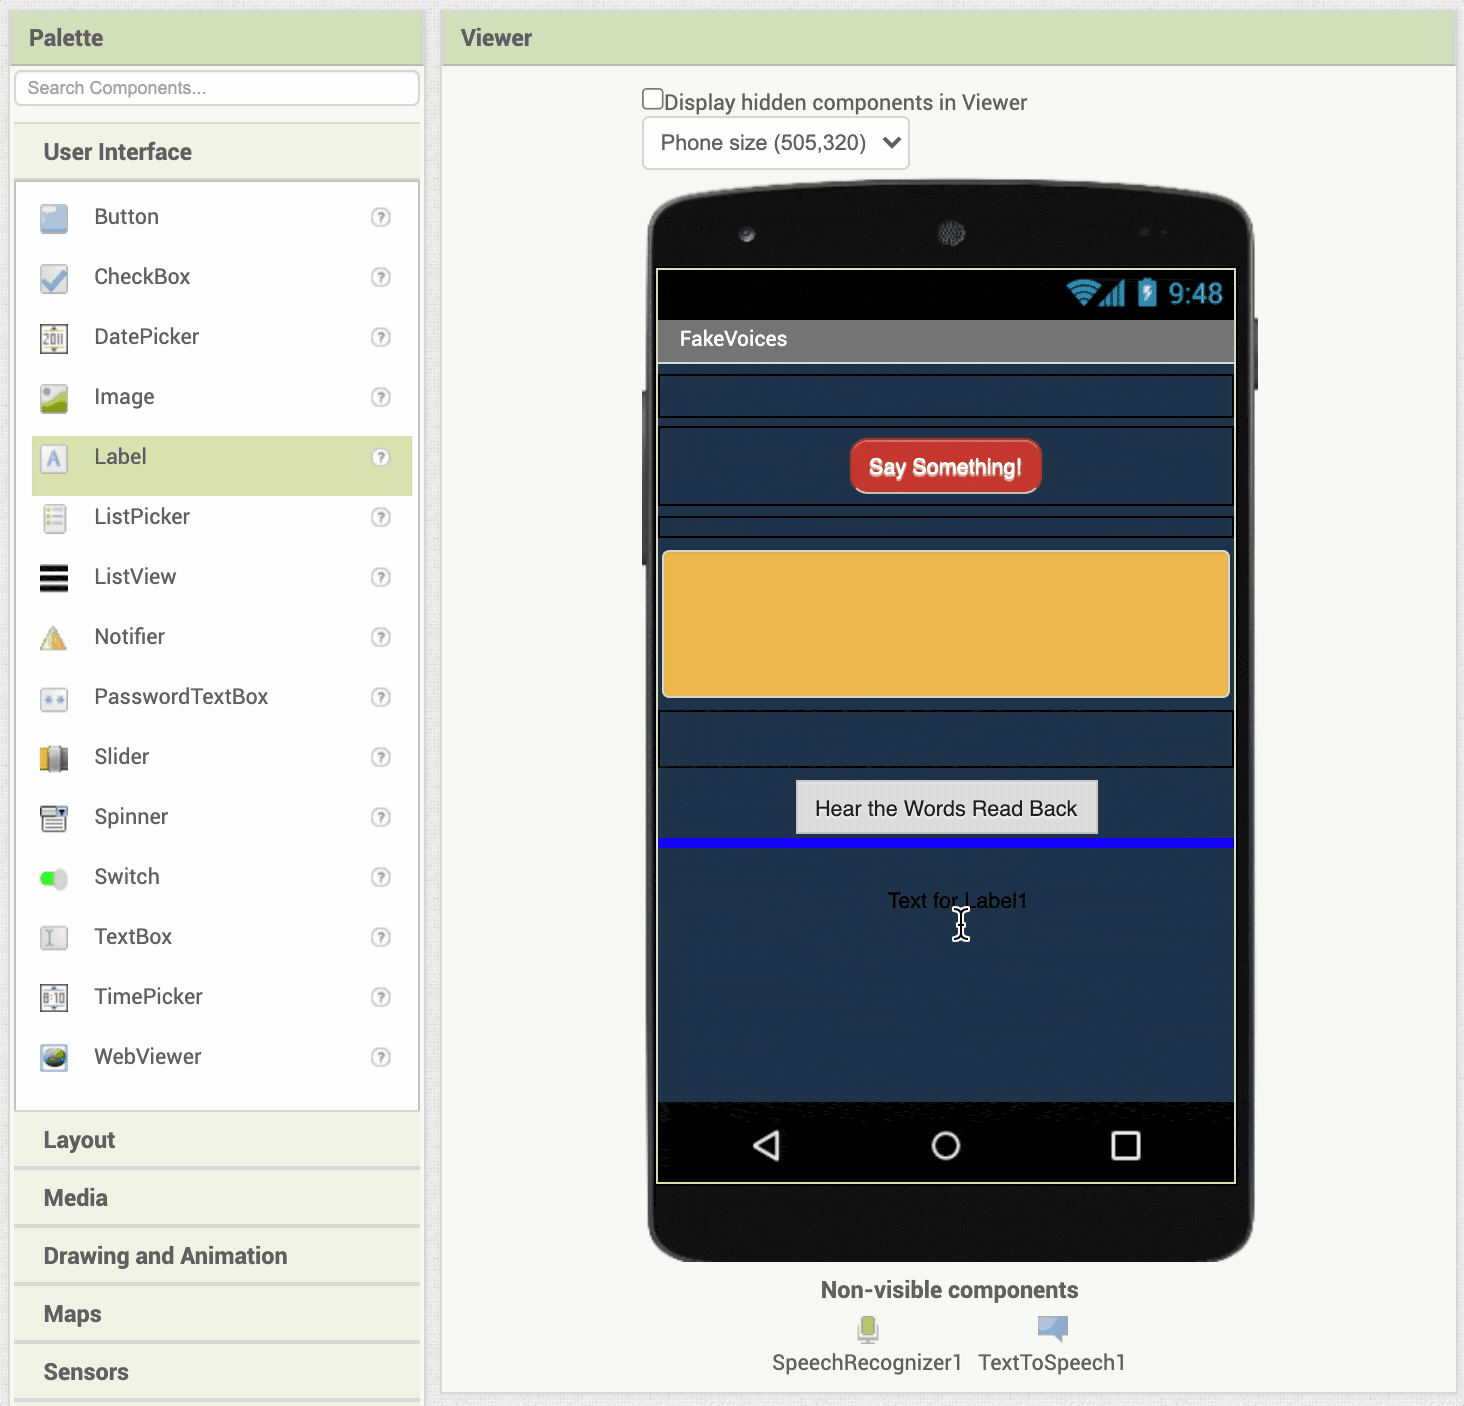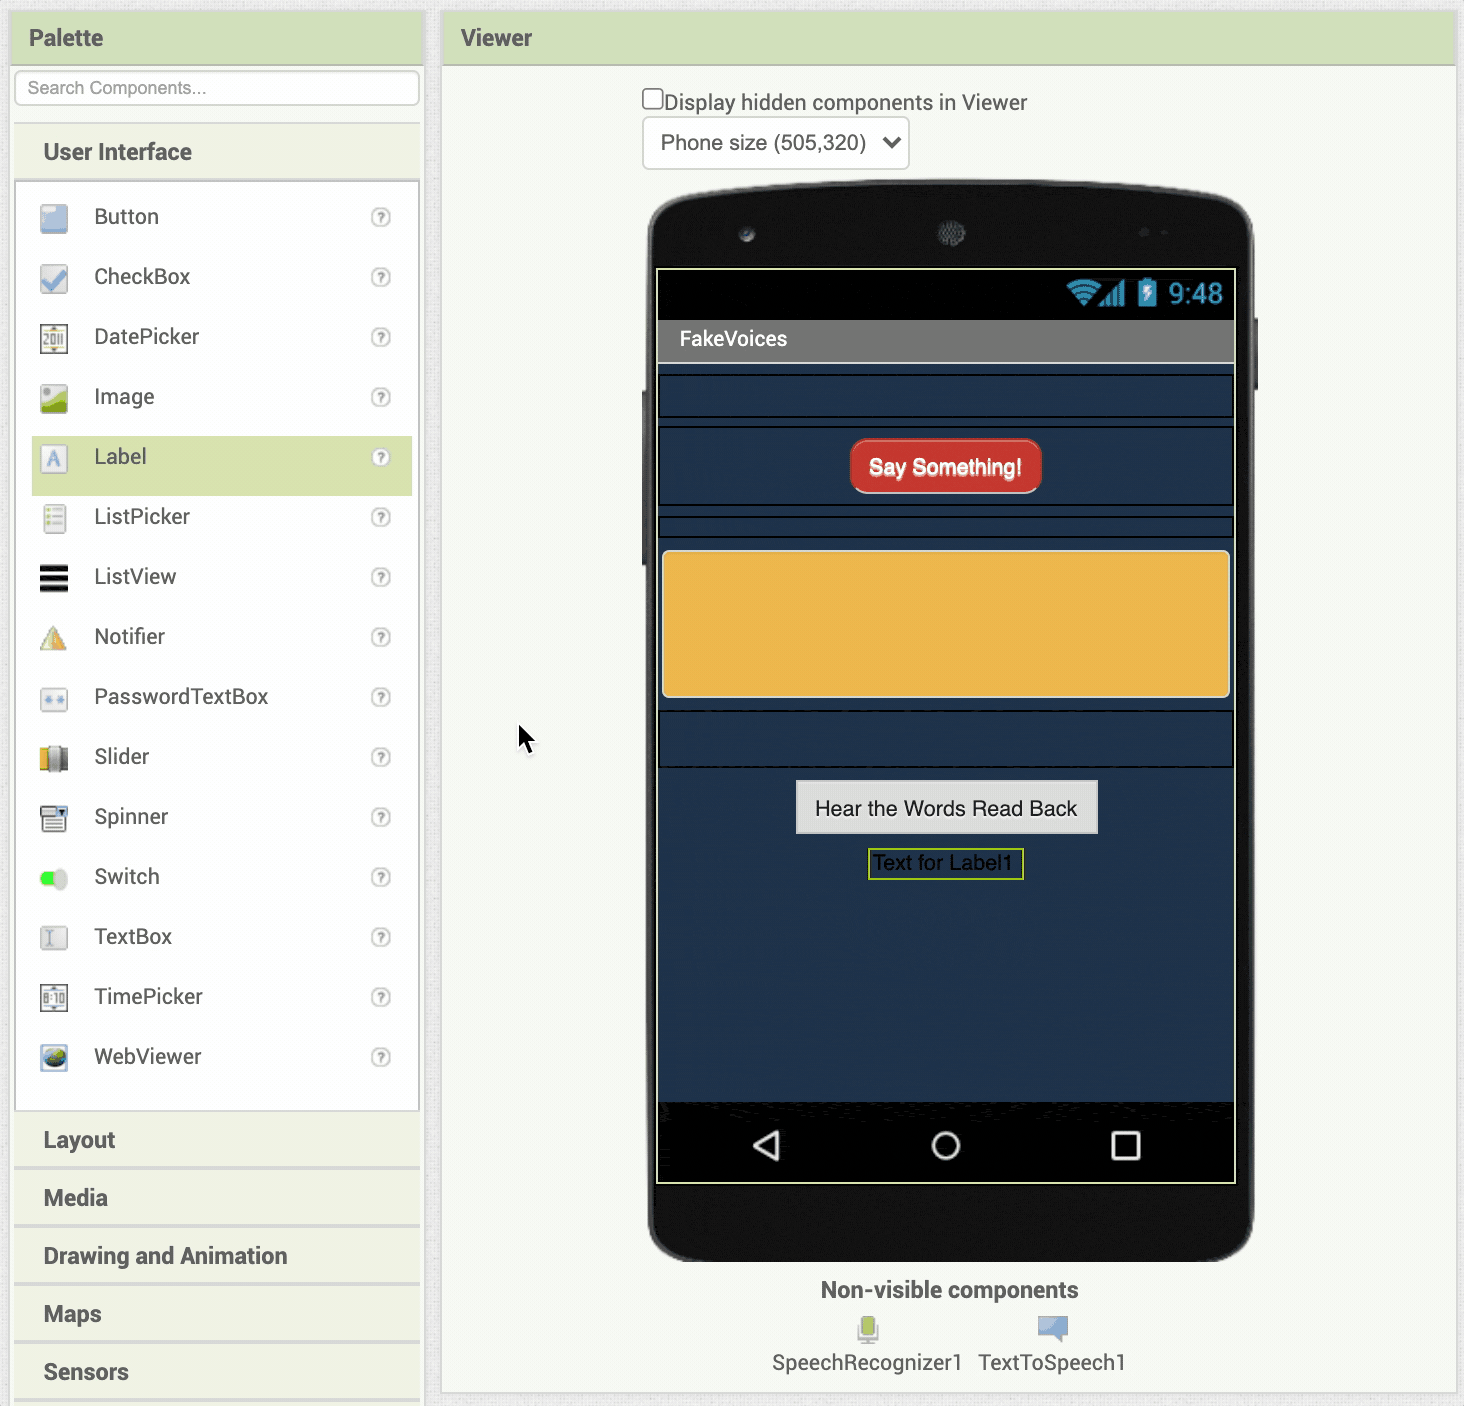
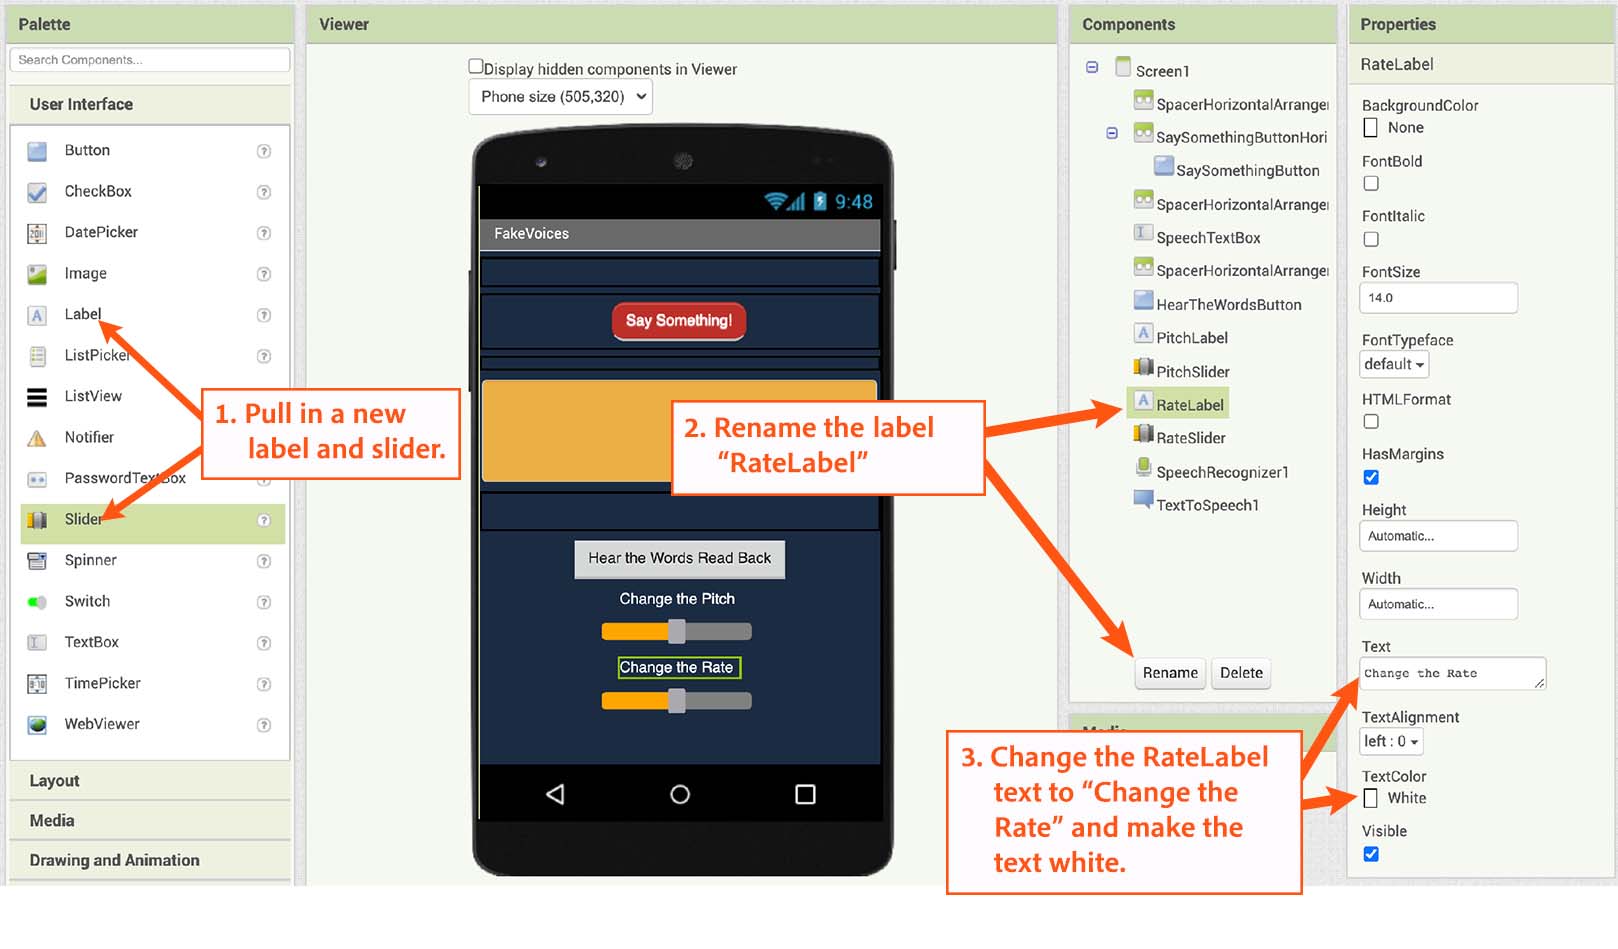
添加一个标签,命名为 PitchLabel,文字设为“调整音调”,并把文字颜色改成白色。再添加一个滑块,命名为 PitchSlider。
7. 设置音调滑块属性
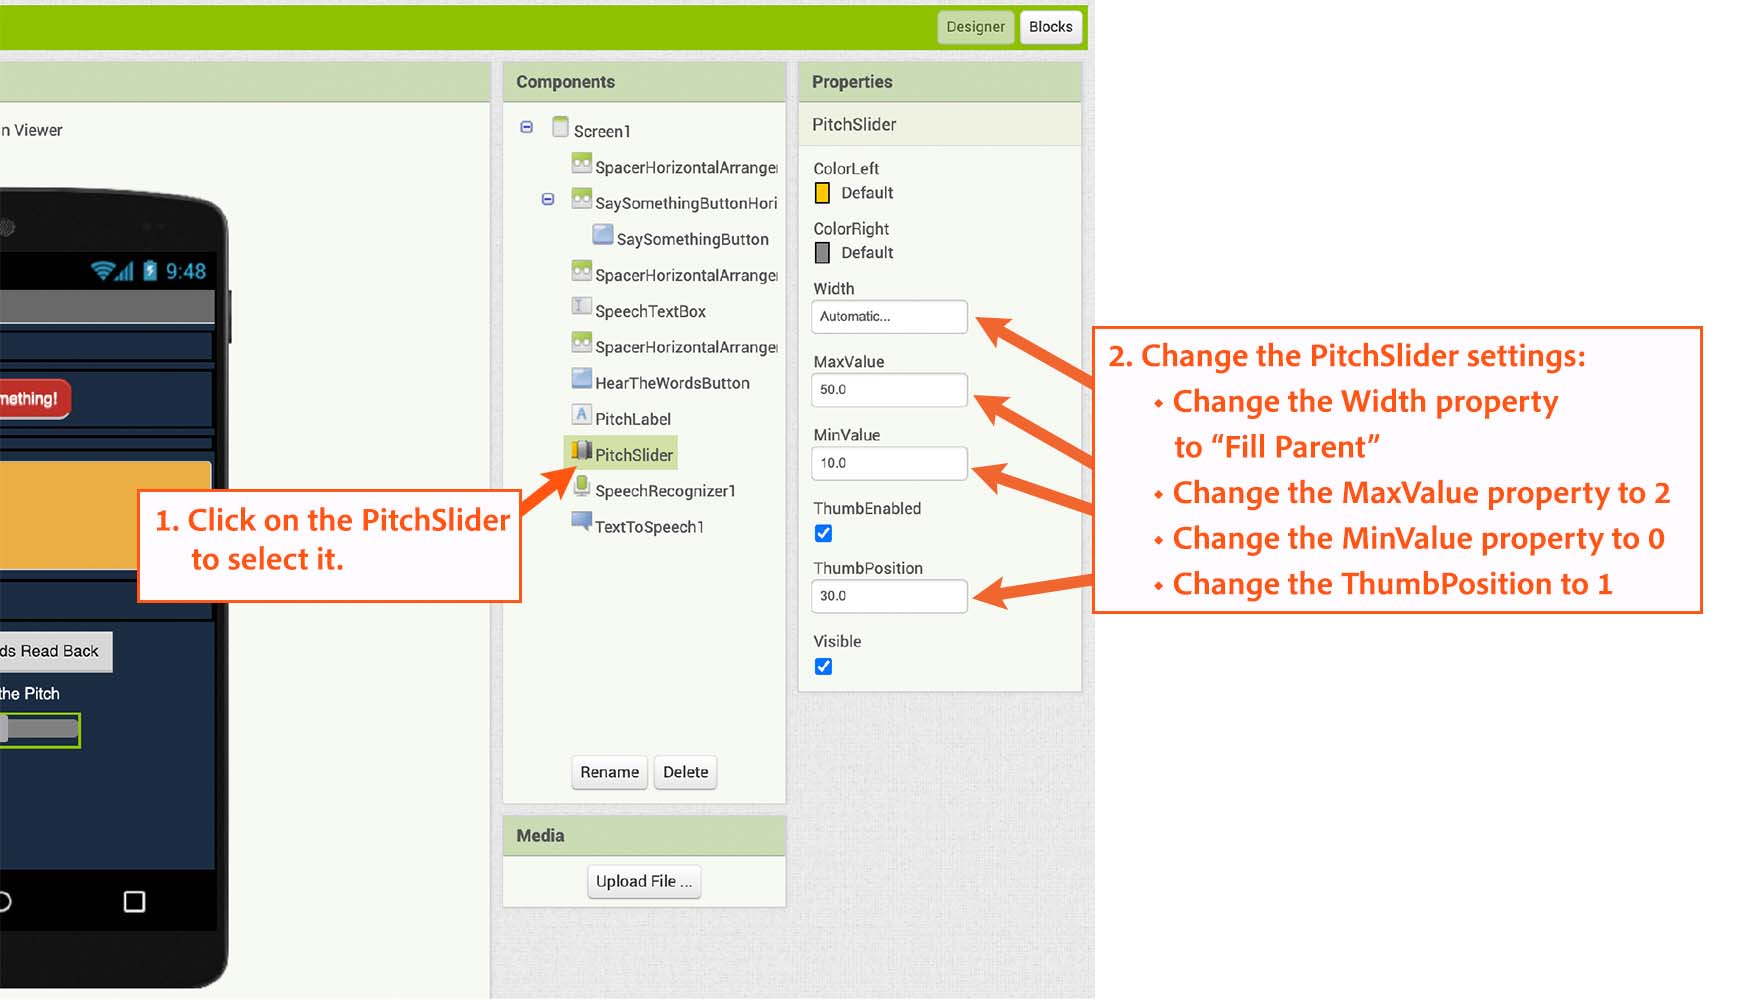
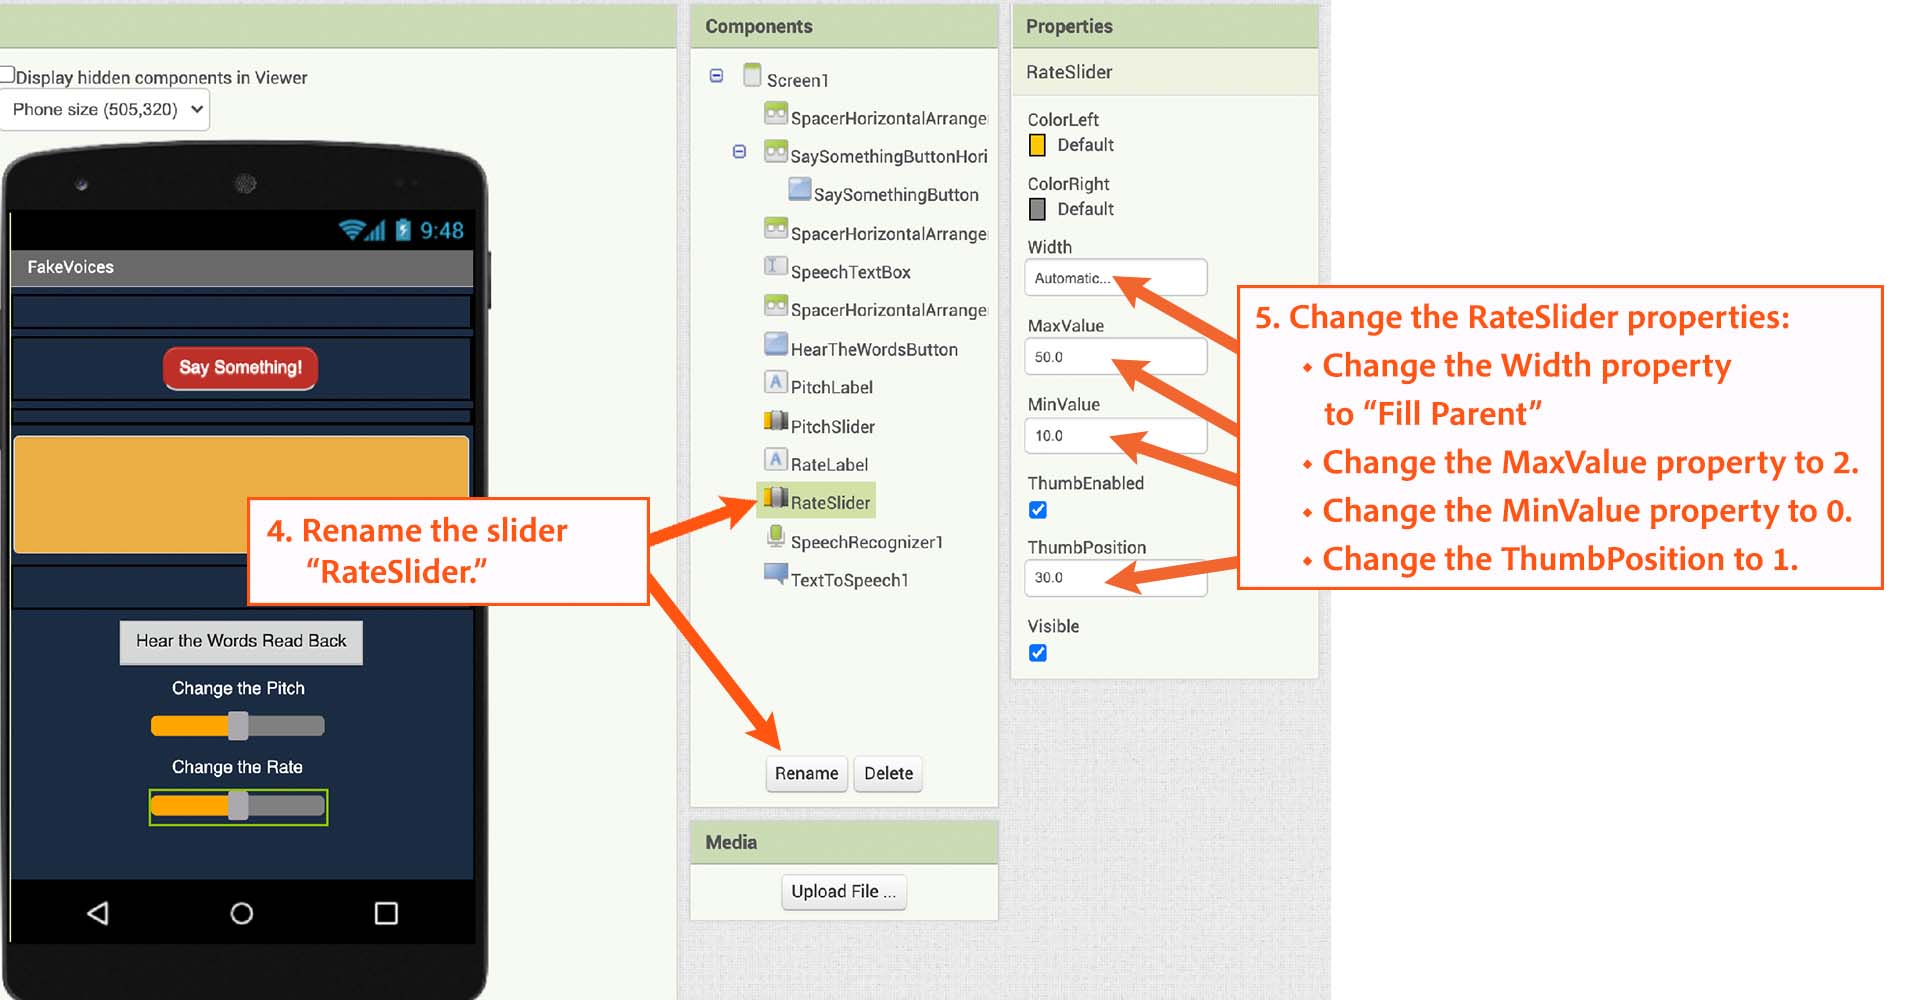
让 PitchSlider 的宽度设为“充满父容器”,并根据起始工程设置 MaxValue、MinValue 和 ThumbPosition。滑块位置最终会传给 TextToSpeech1.音调。
8. 创建语速滑块
再添加一个标签和滑块。把标签命名为 RateLabel,文字设为“调整语速”;把滑块命名为 RateSlider,并按照起始工程设置它的宽度、最大值、最小值和初始位置。
9. 查看起始积木
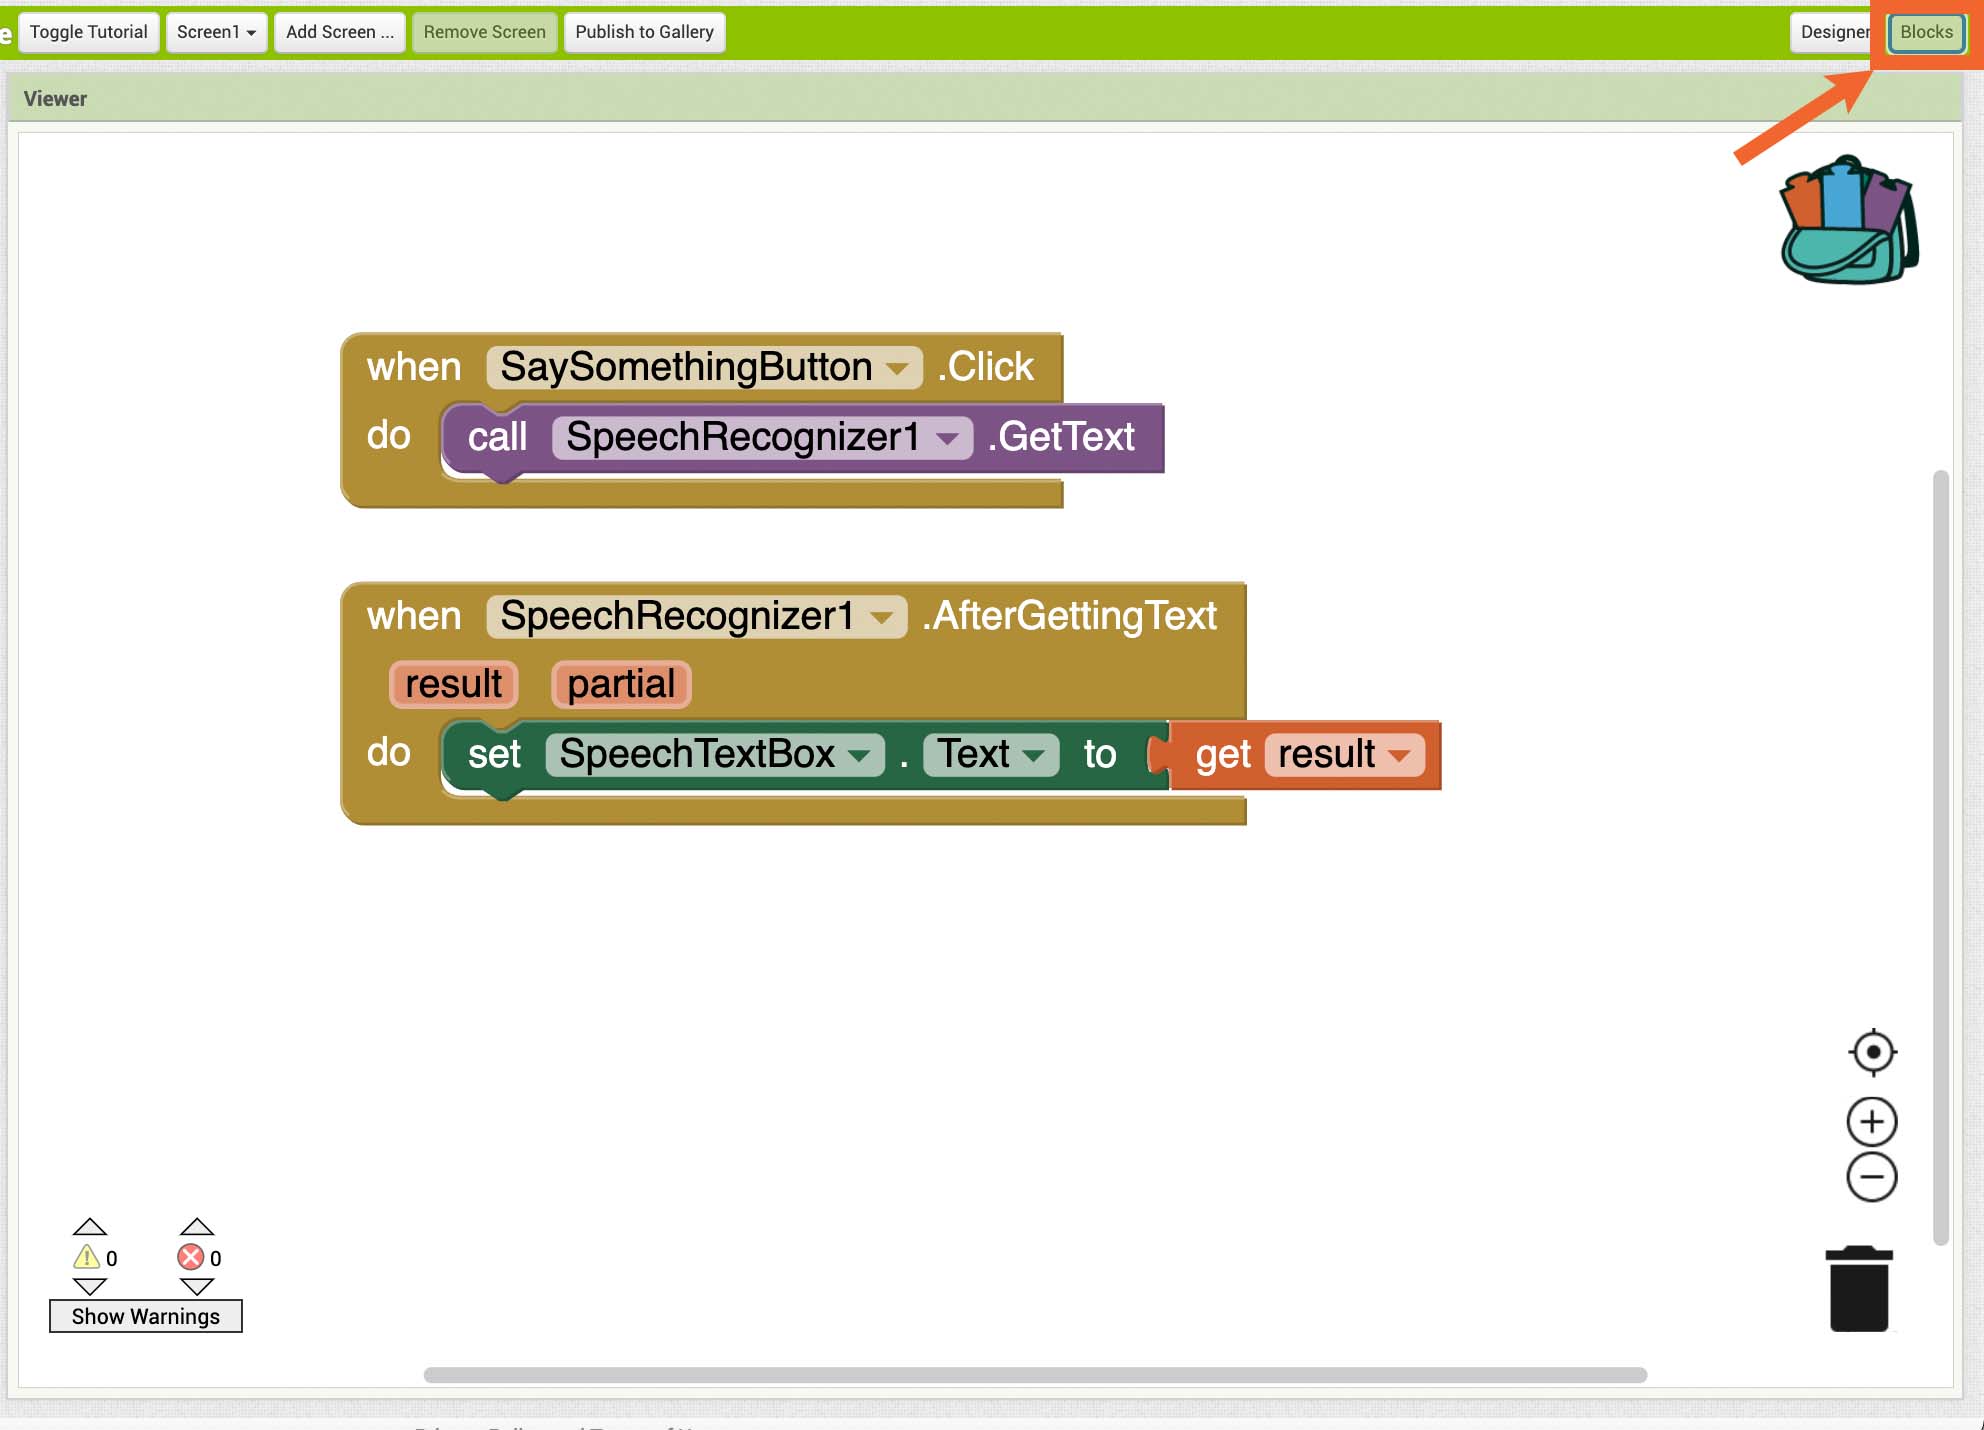
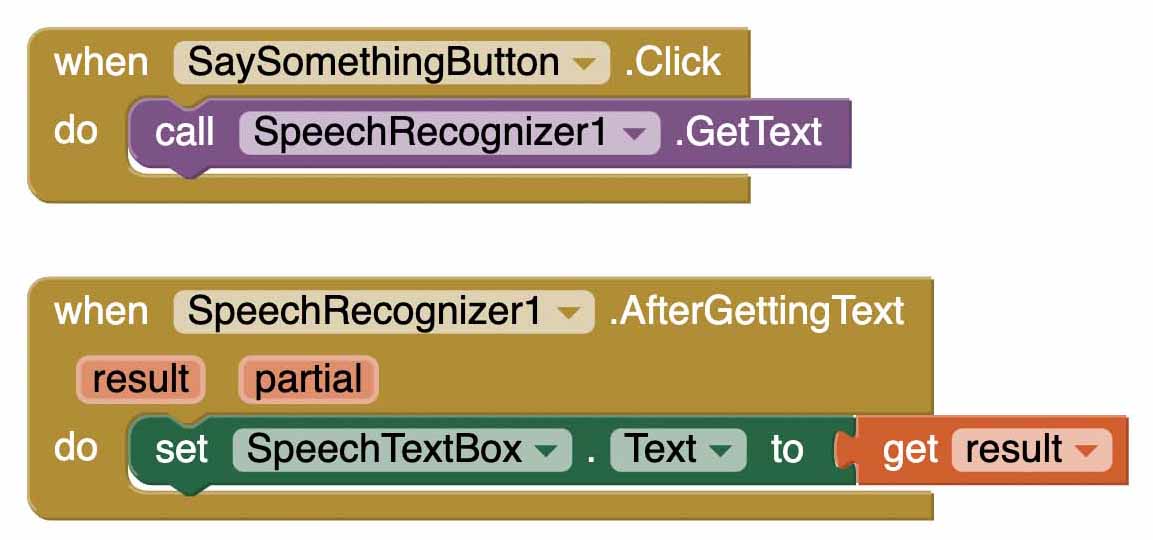
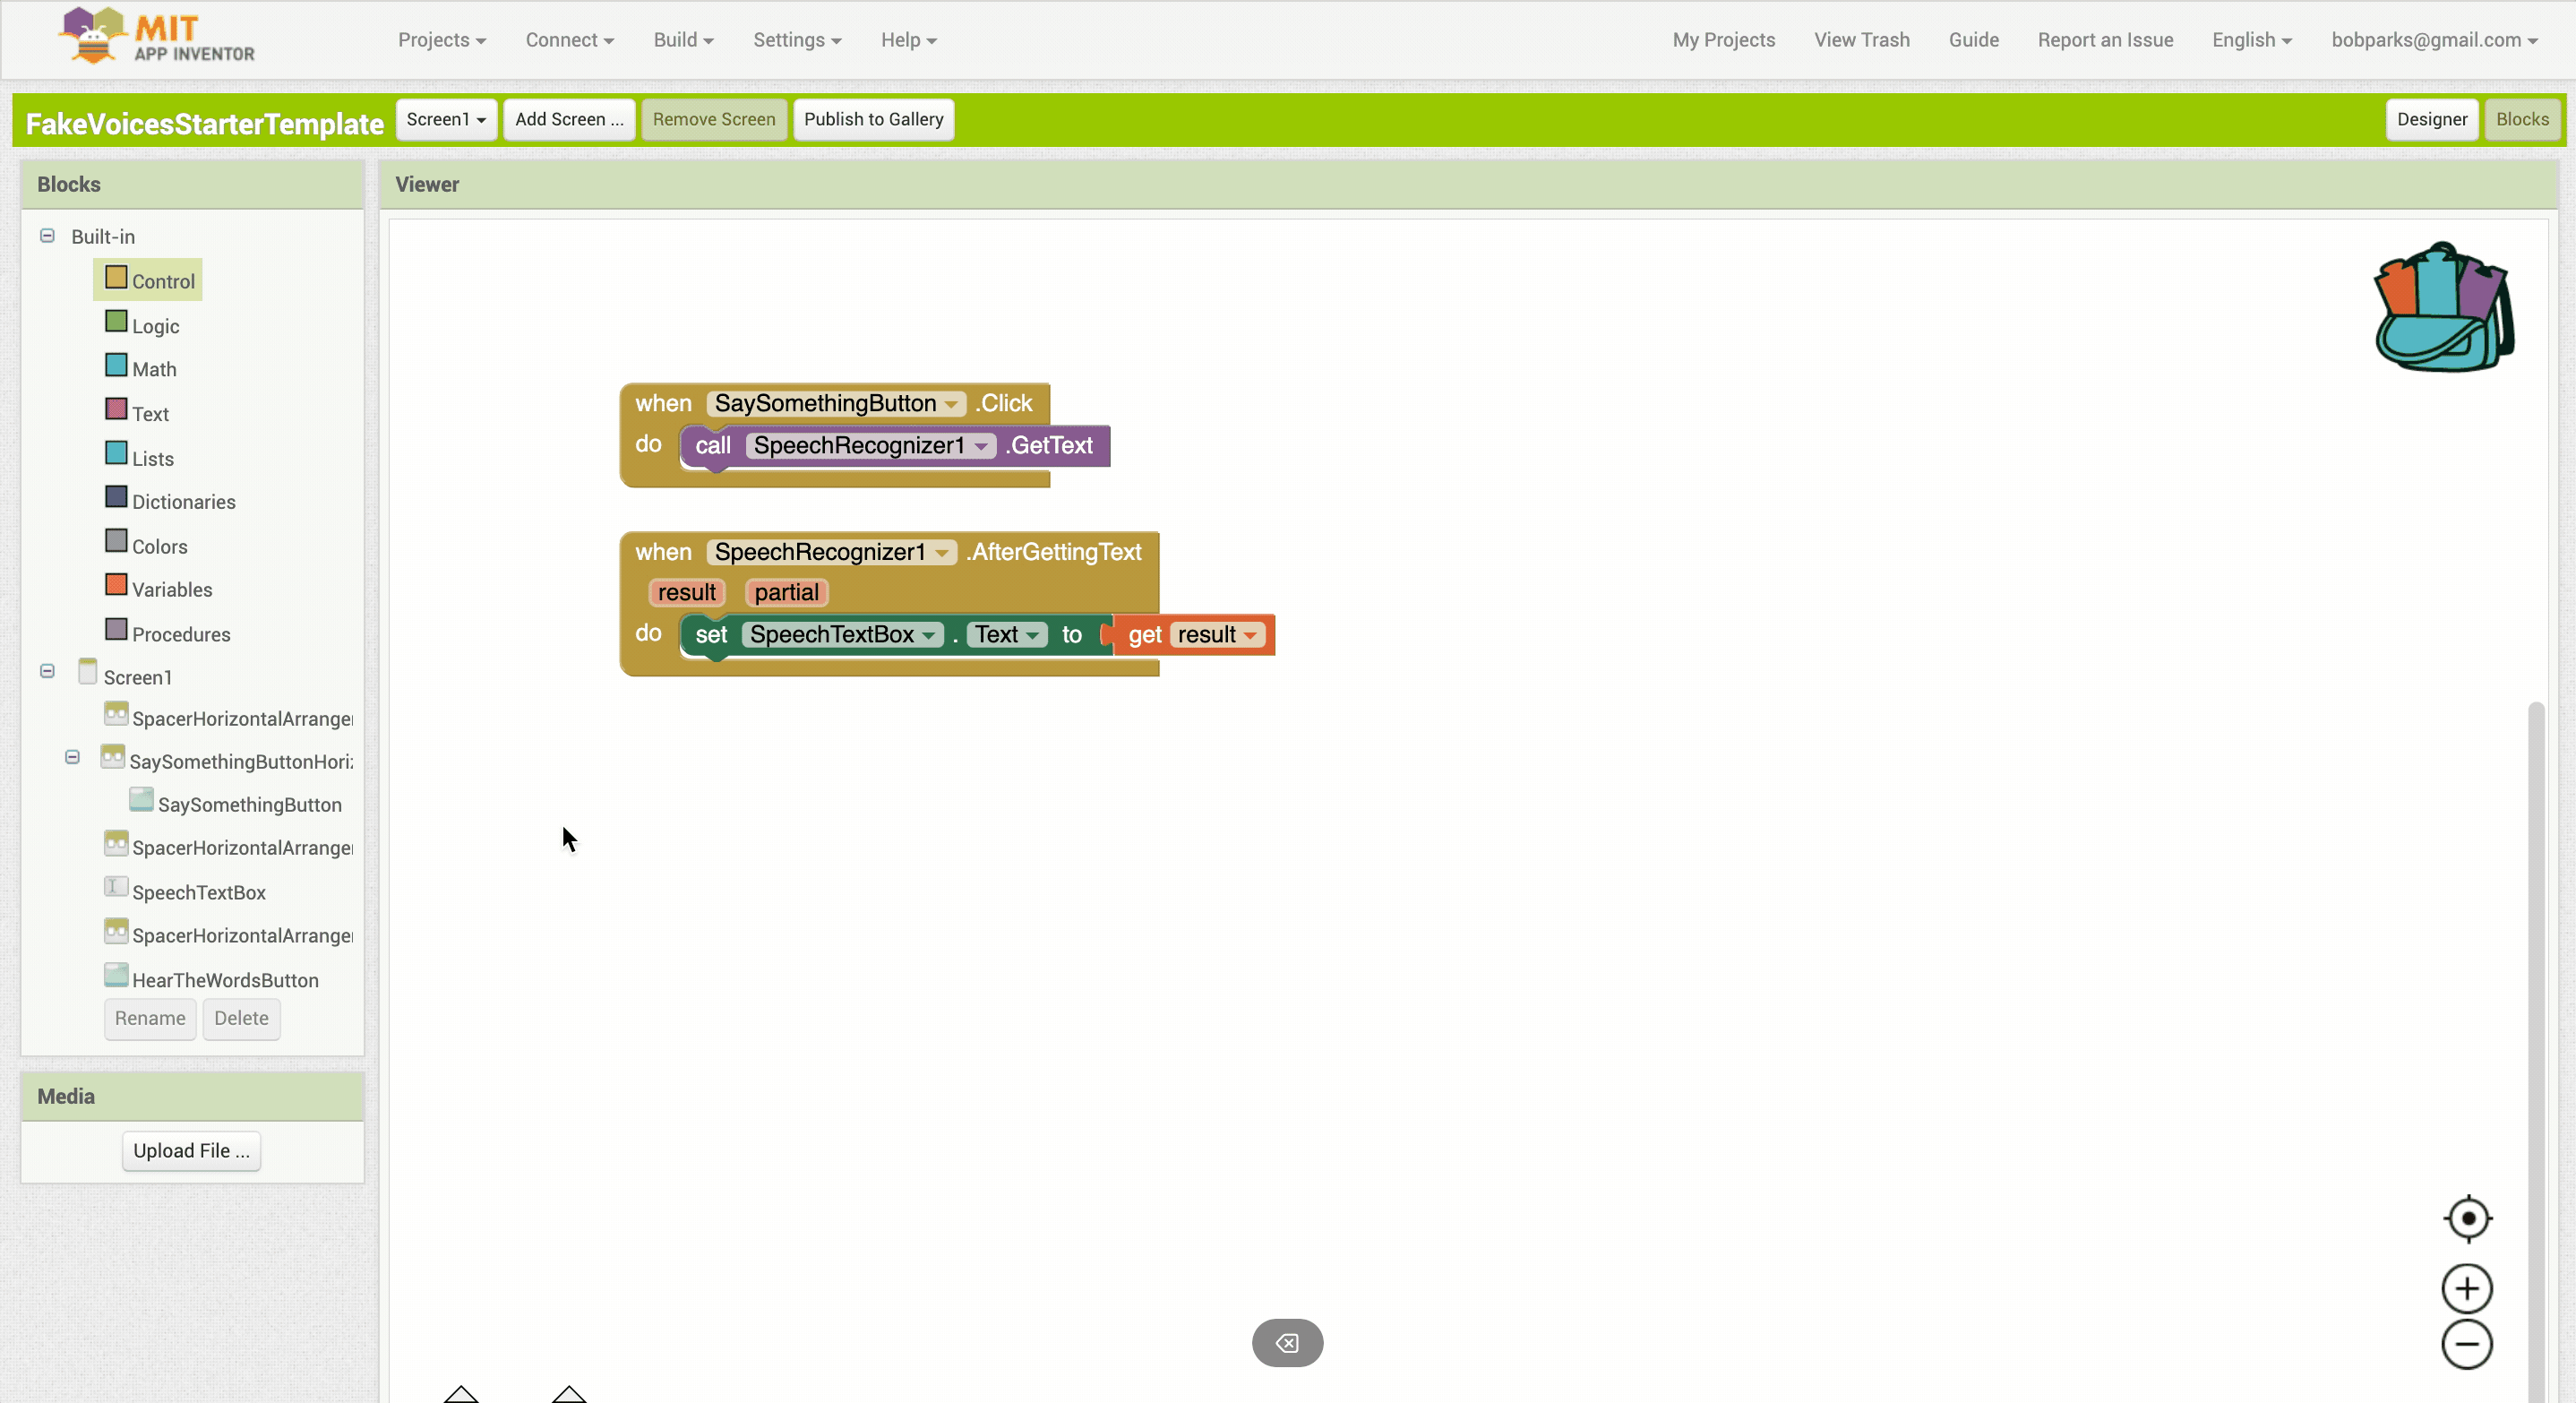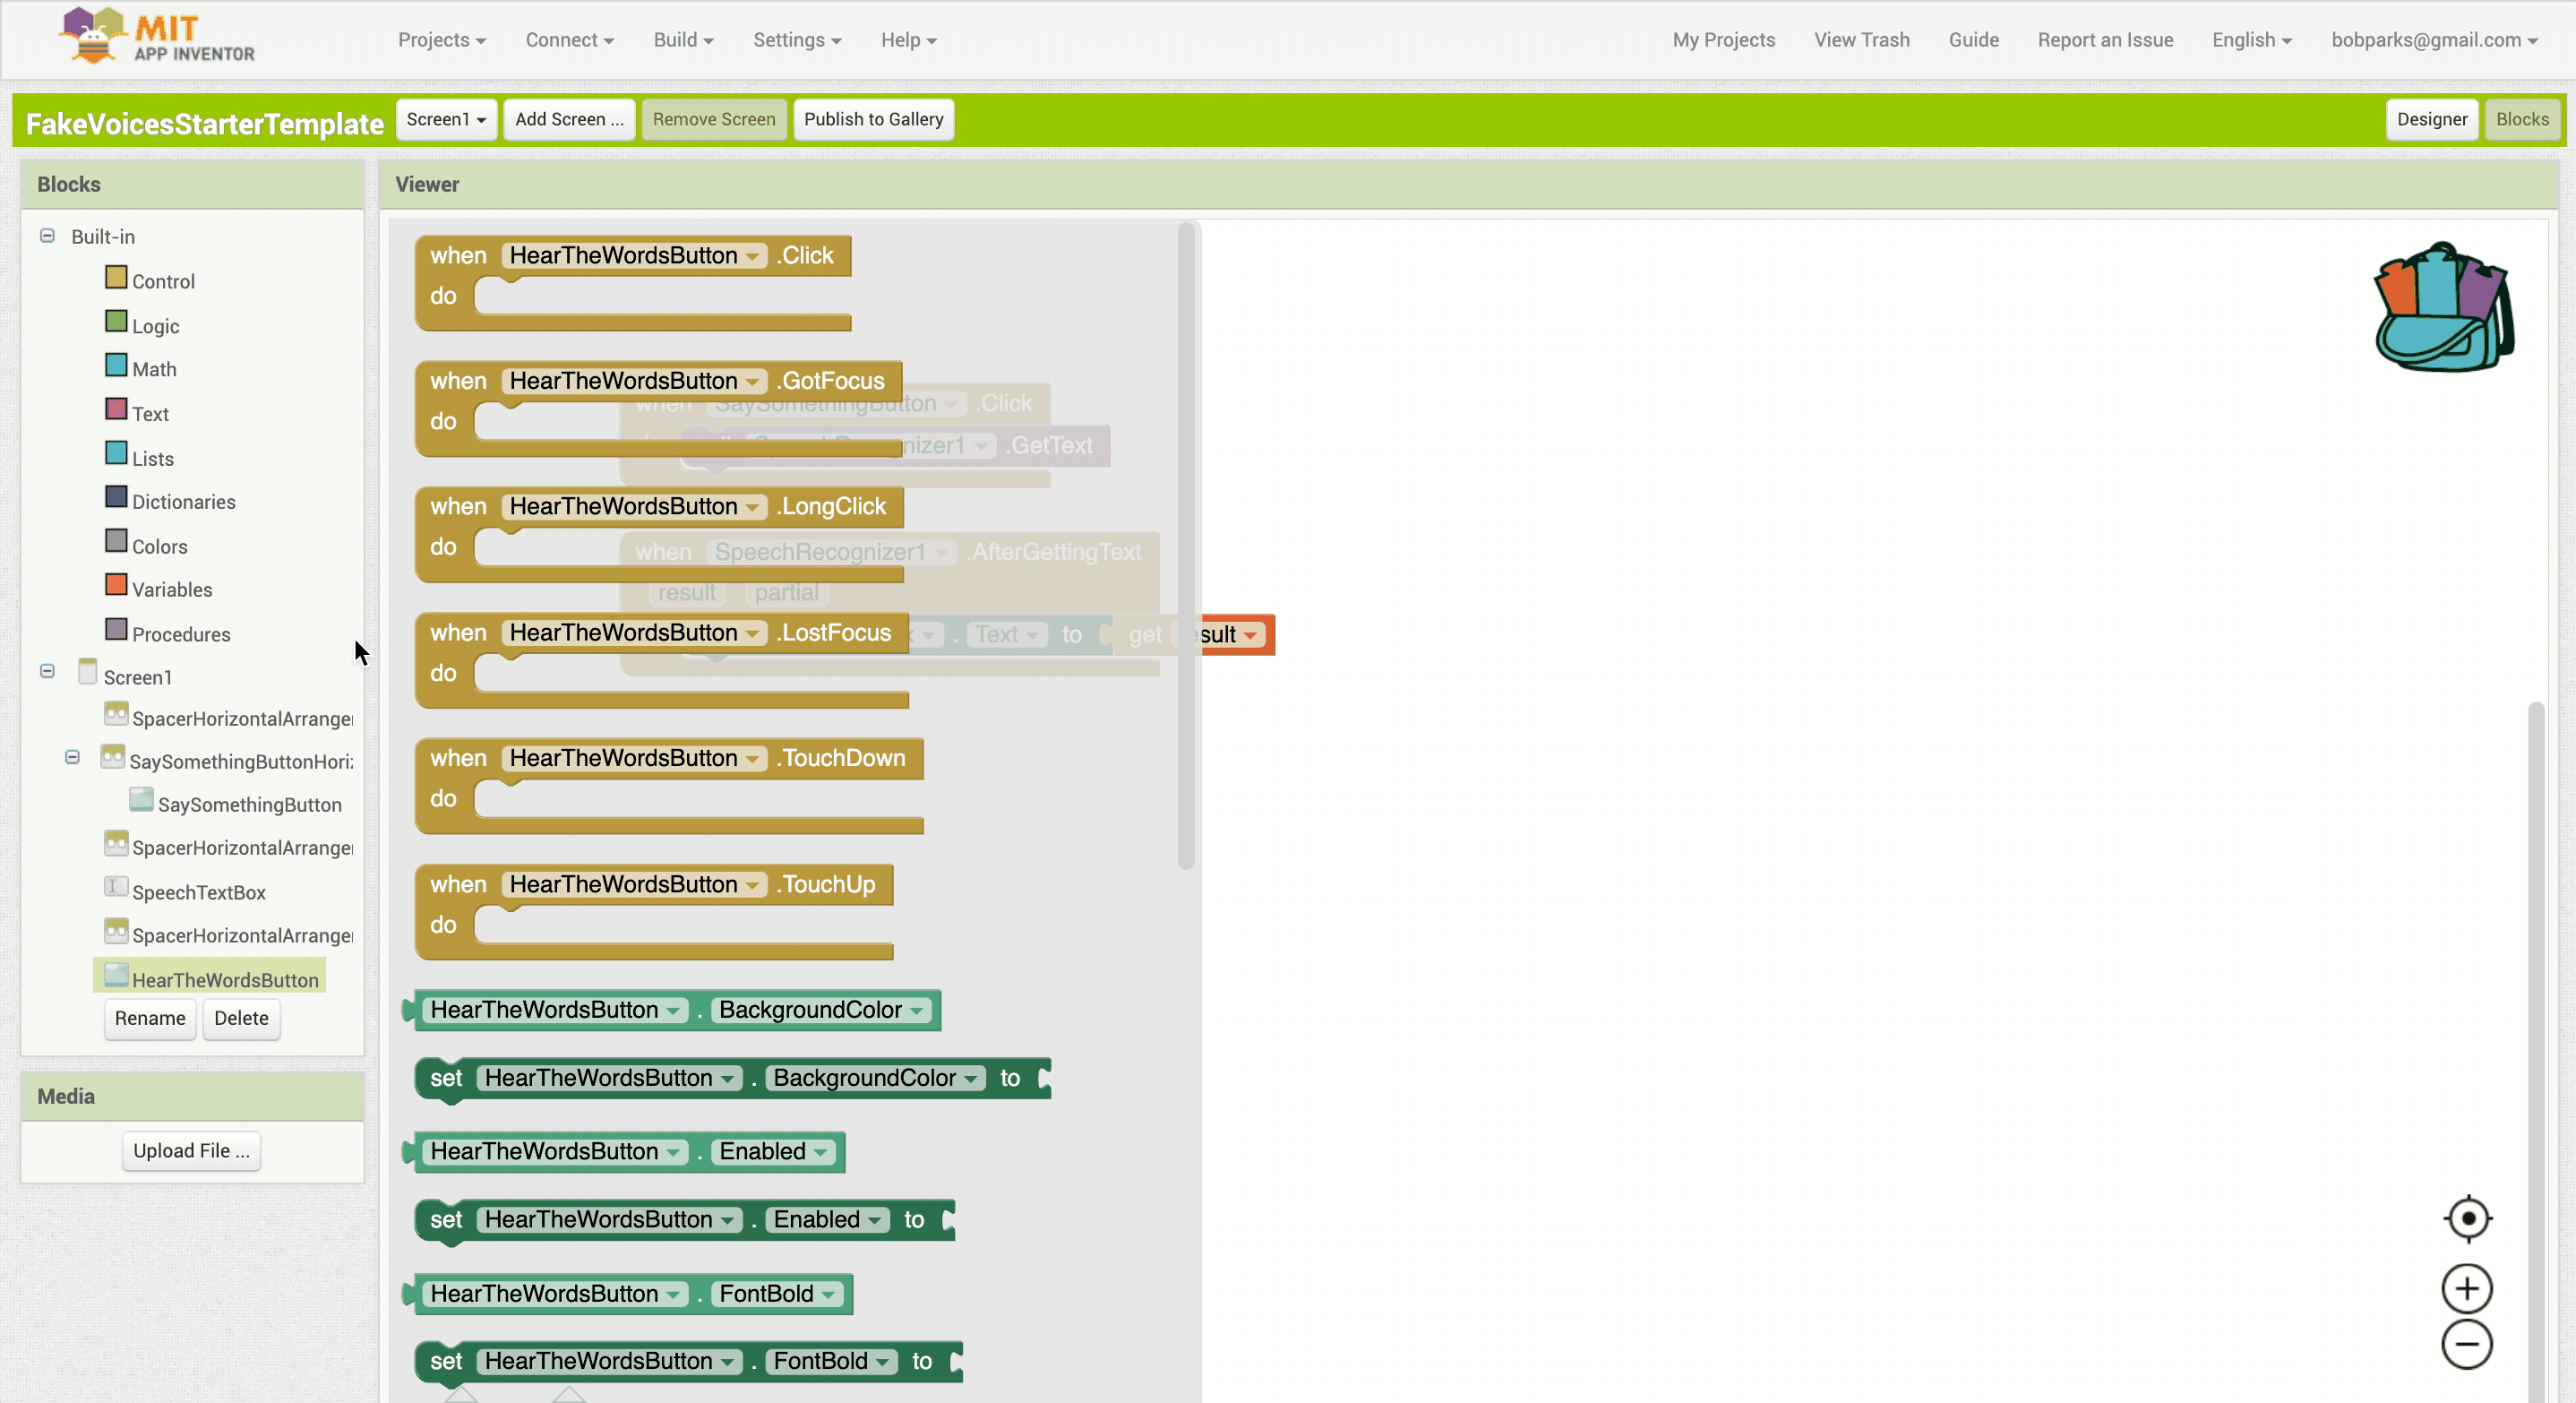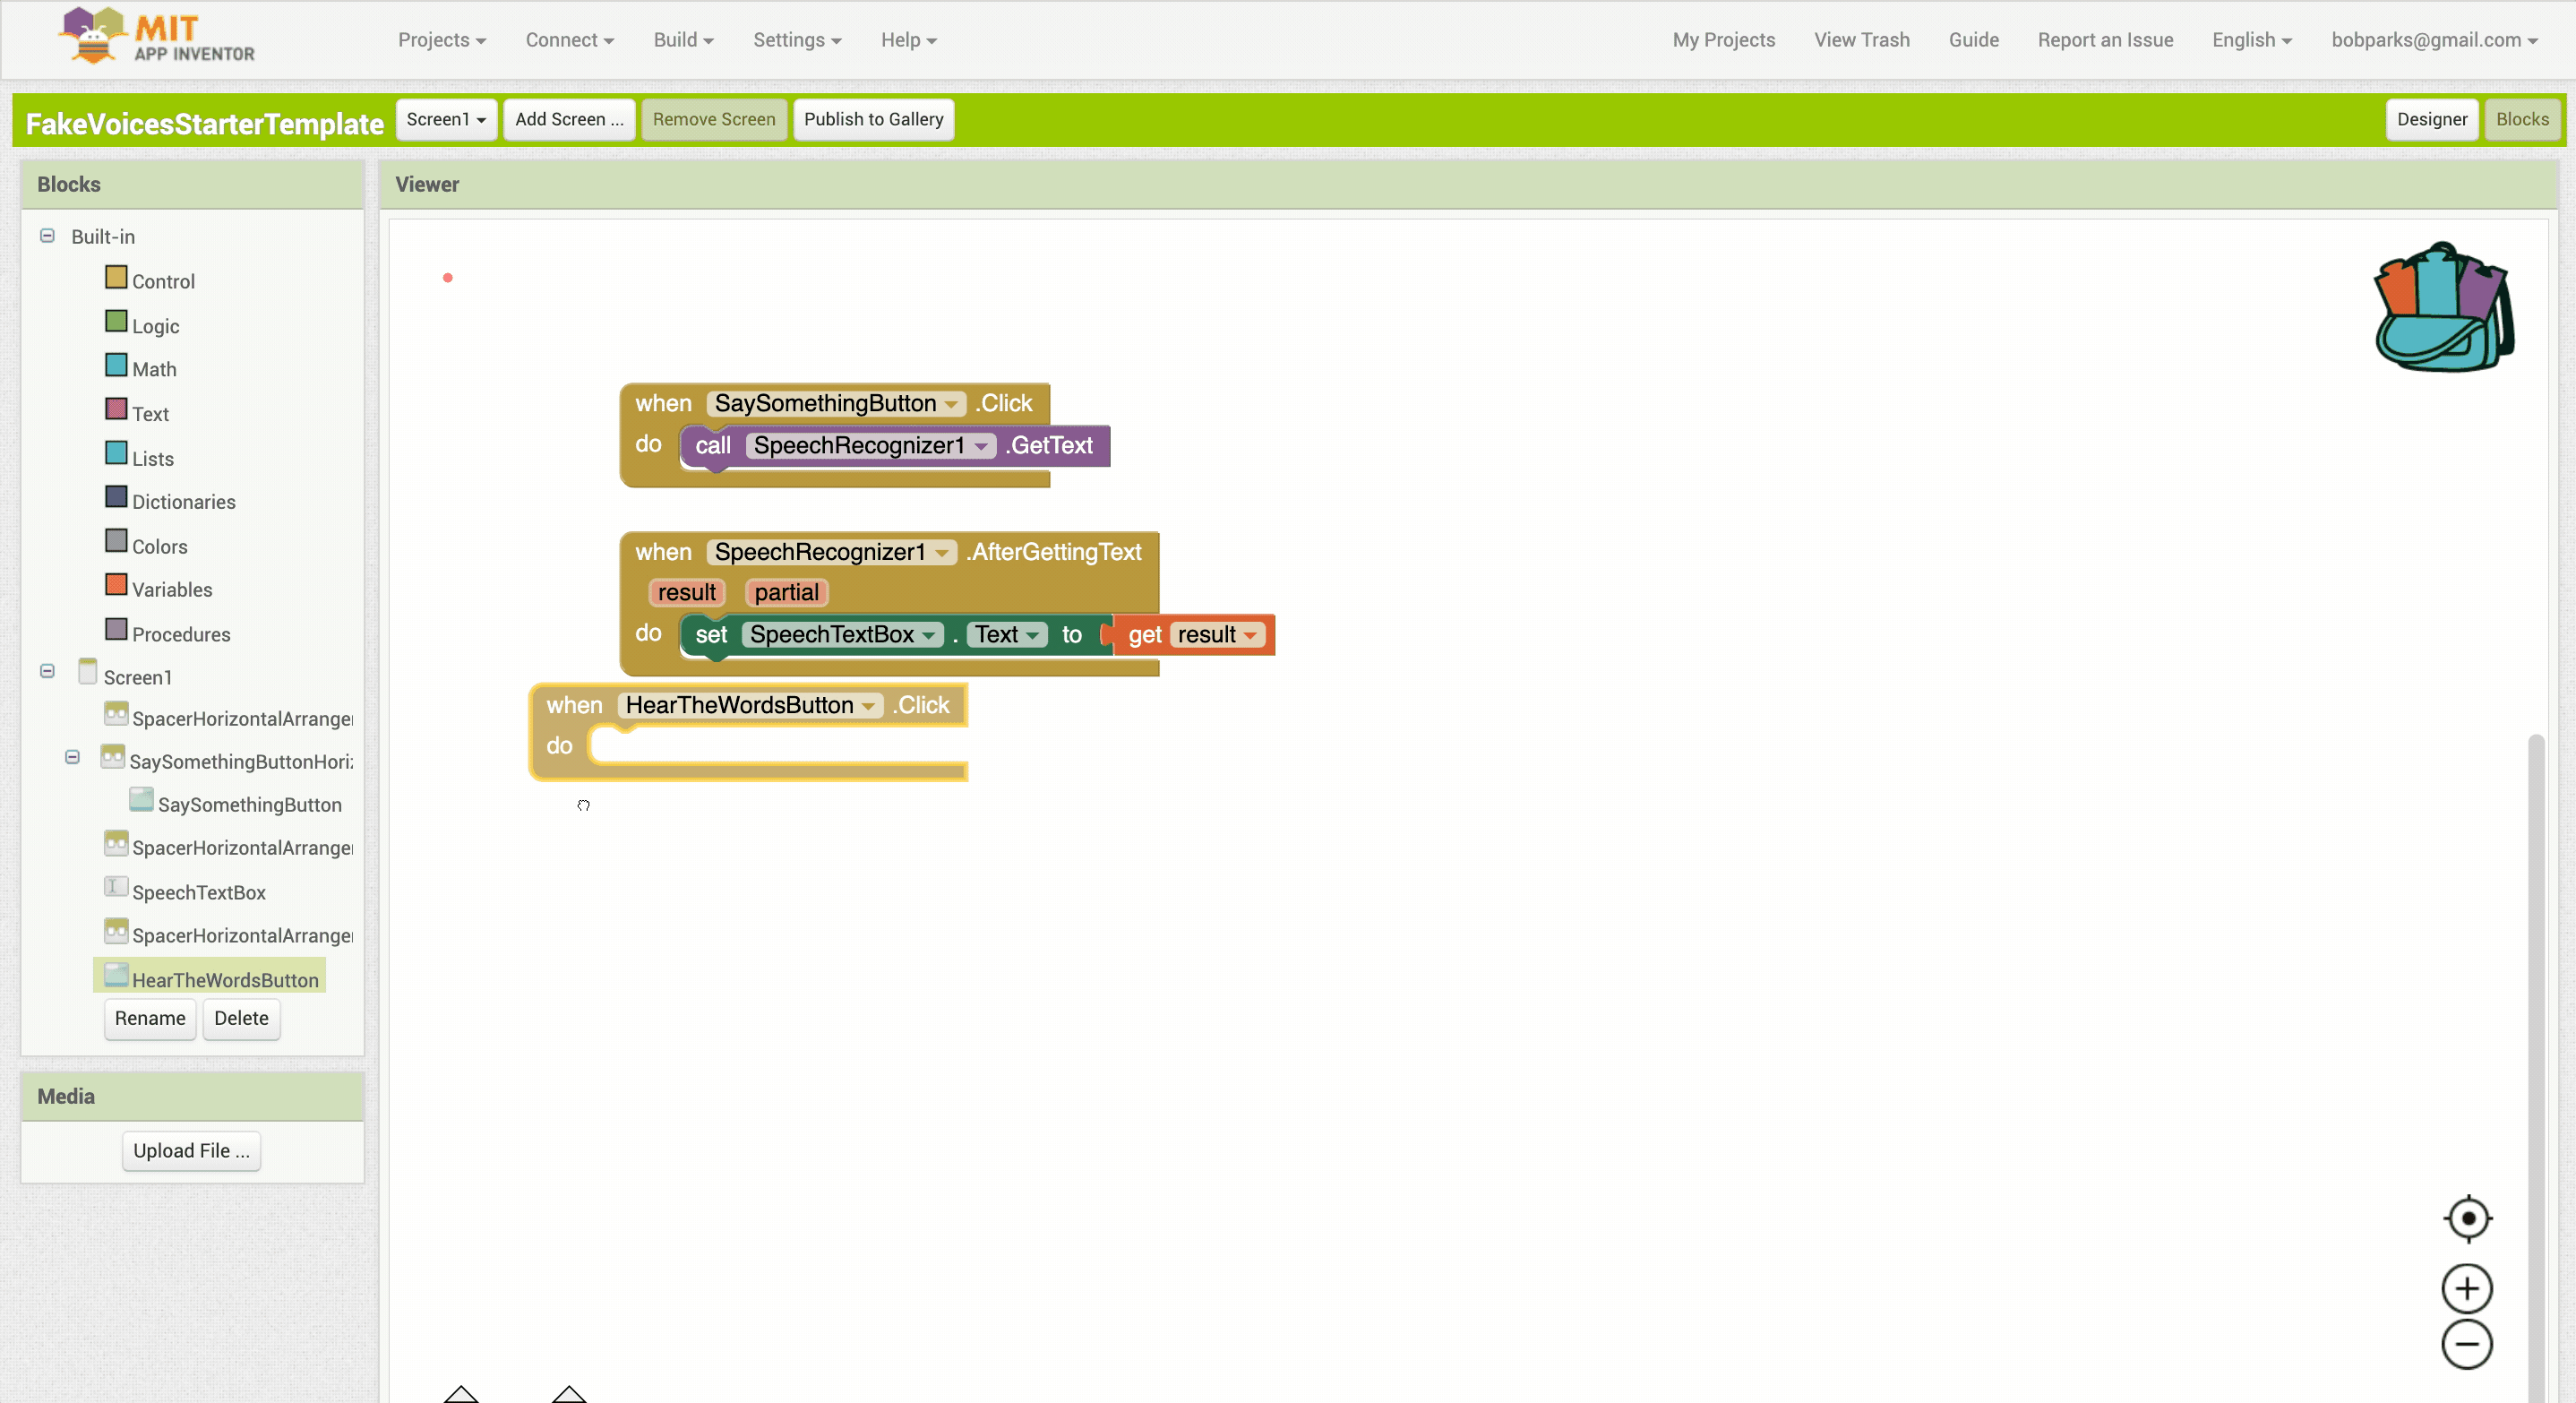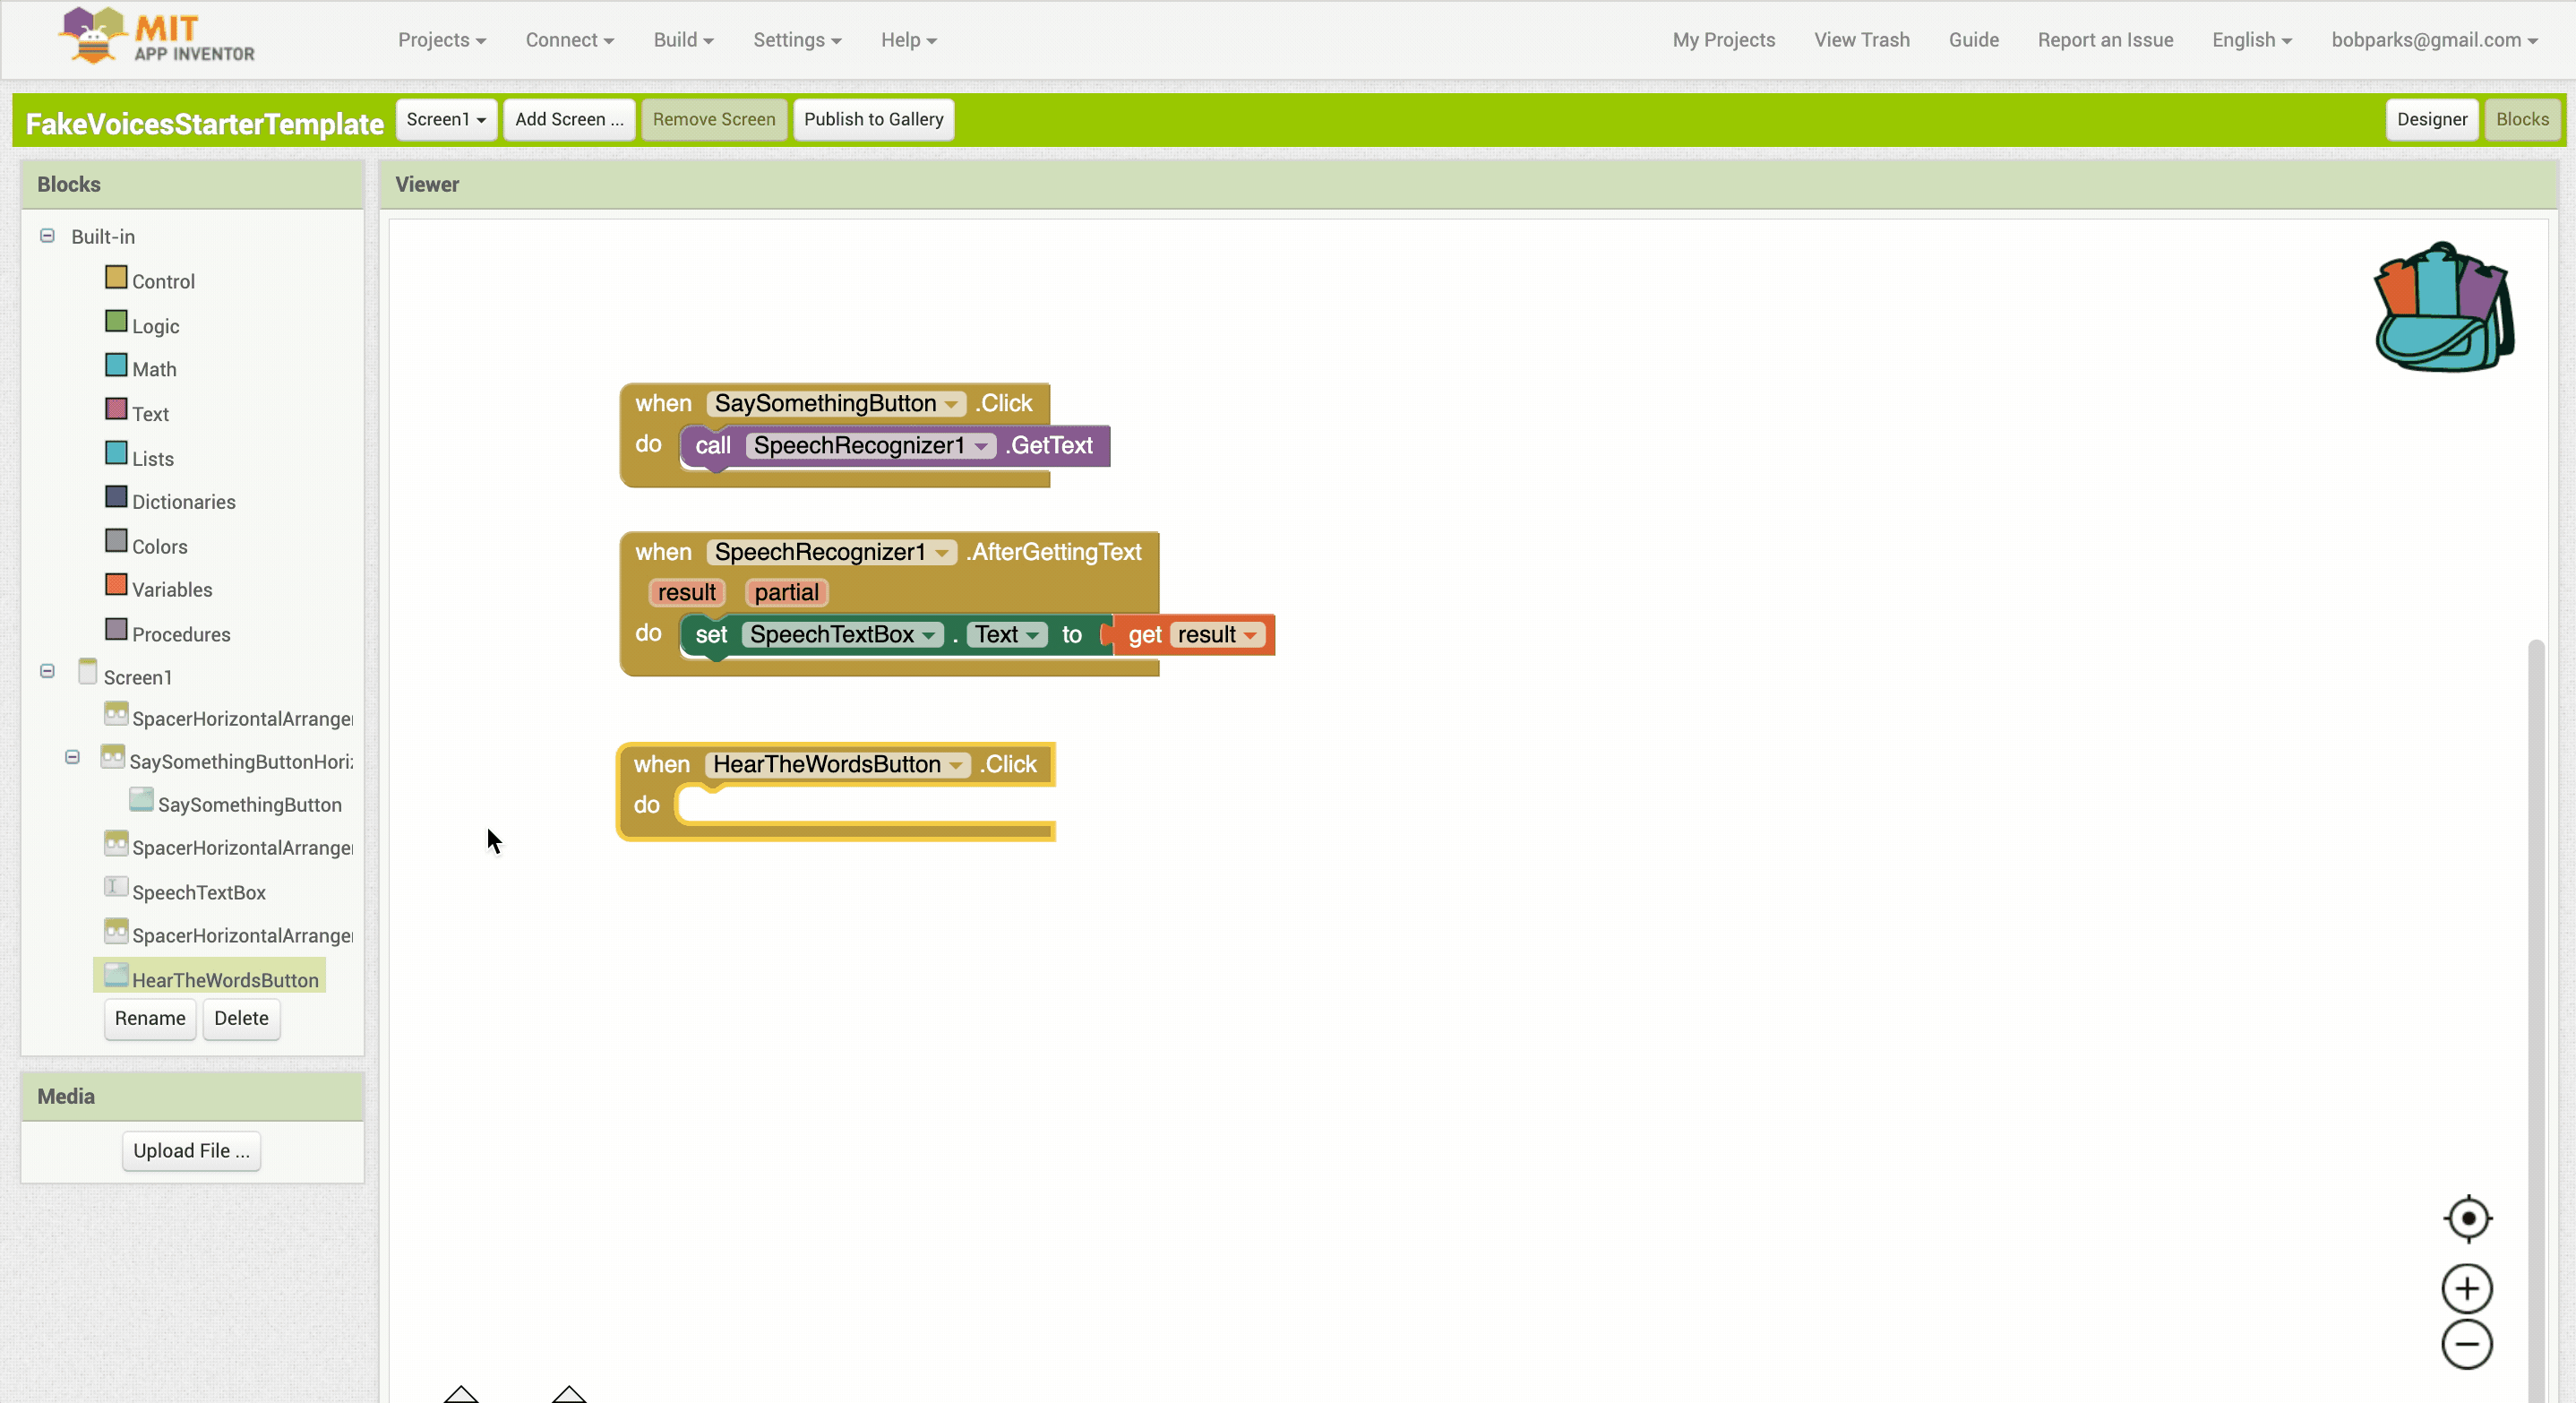
切换到积木编辑器,先观察工程中已有的程序。不要急着删除它们:它们已经处理了“点击开始说话”和“语音识别返回文字”两个基础动作。
10. 逐块理解语音识别
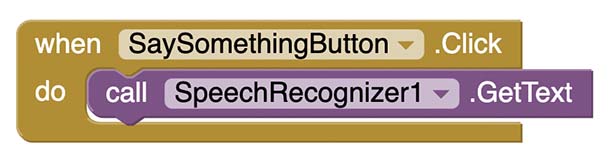
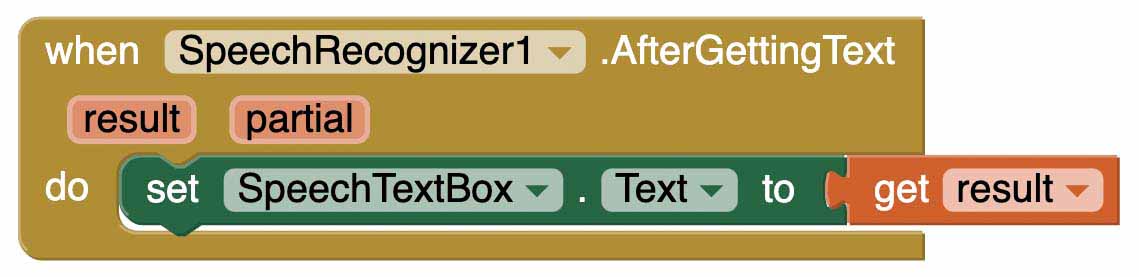
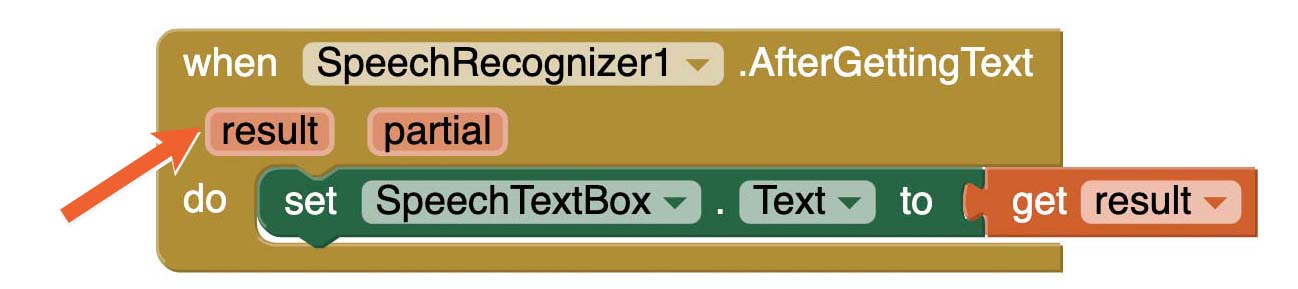
当 SaySomethingButton.被点击时 中调用 SpeechRecognizer1.识别语音,手机会打开语音识别界面。识别完成后,SpeechRecognizer1.识别完成时 事件把 result 写入 SpeechTextBox.文本。
11. 测试语音识别
先连接 AI2 Companion,点击“开始说话”按钮并对着手机说一句话。识别结果应该自动显示在文字框中。可以尝试专有名词、奇怪短语或不同语速,观察识别是否准确。
12. 让应用开始朗读
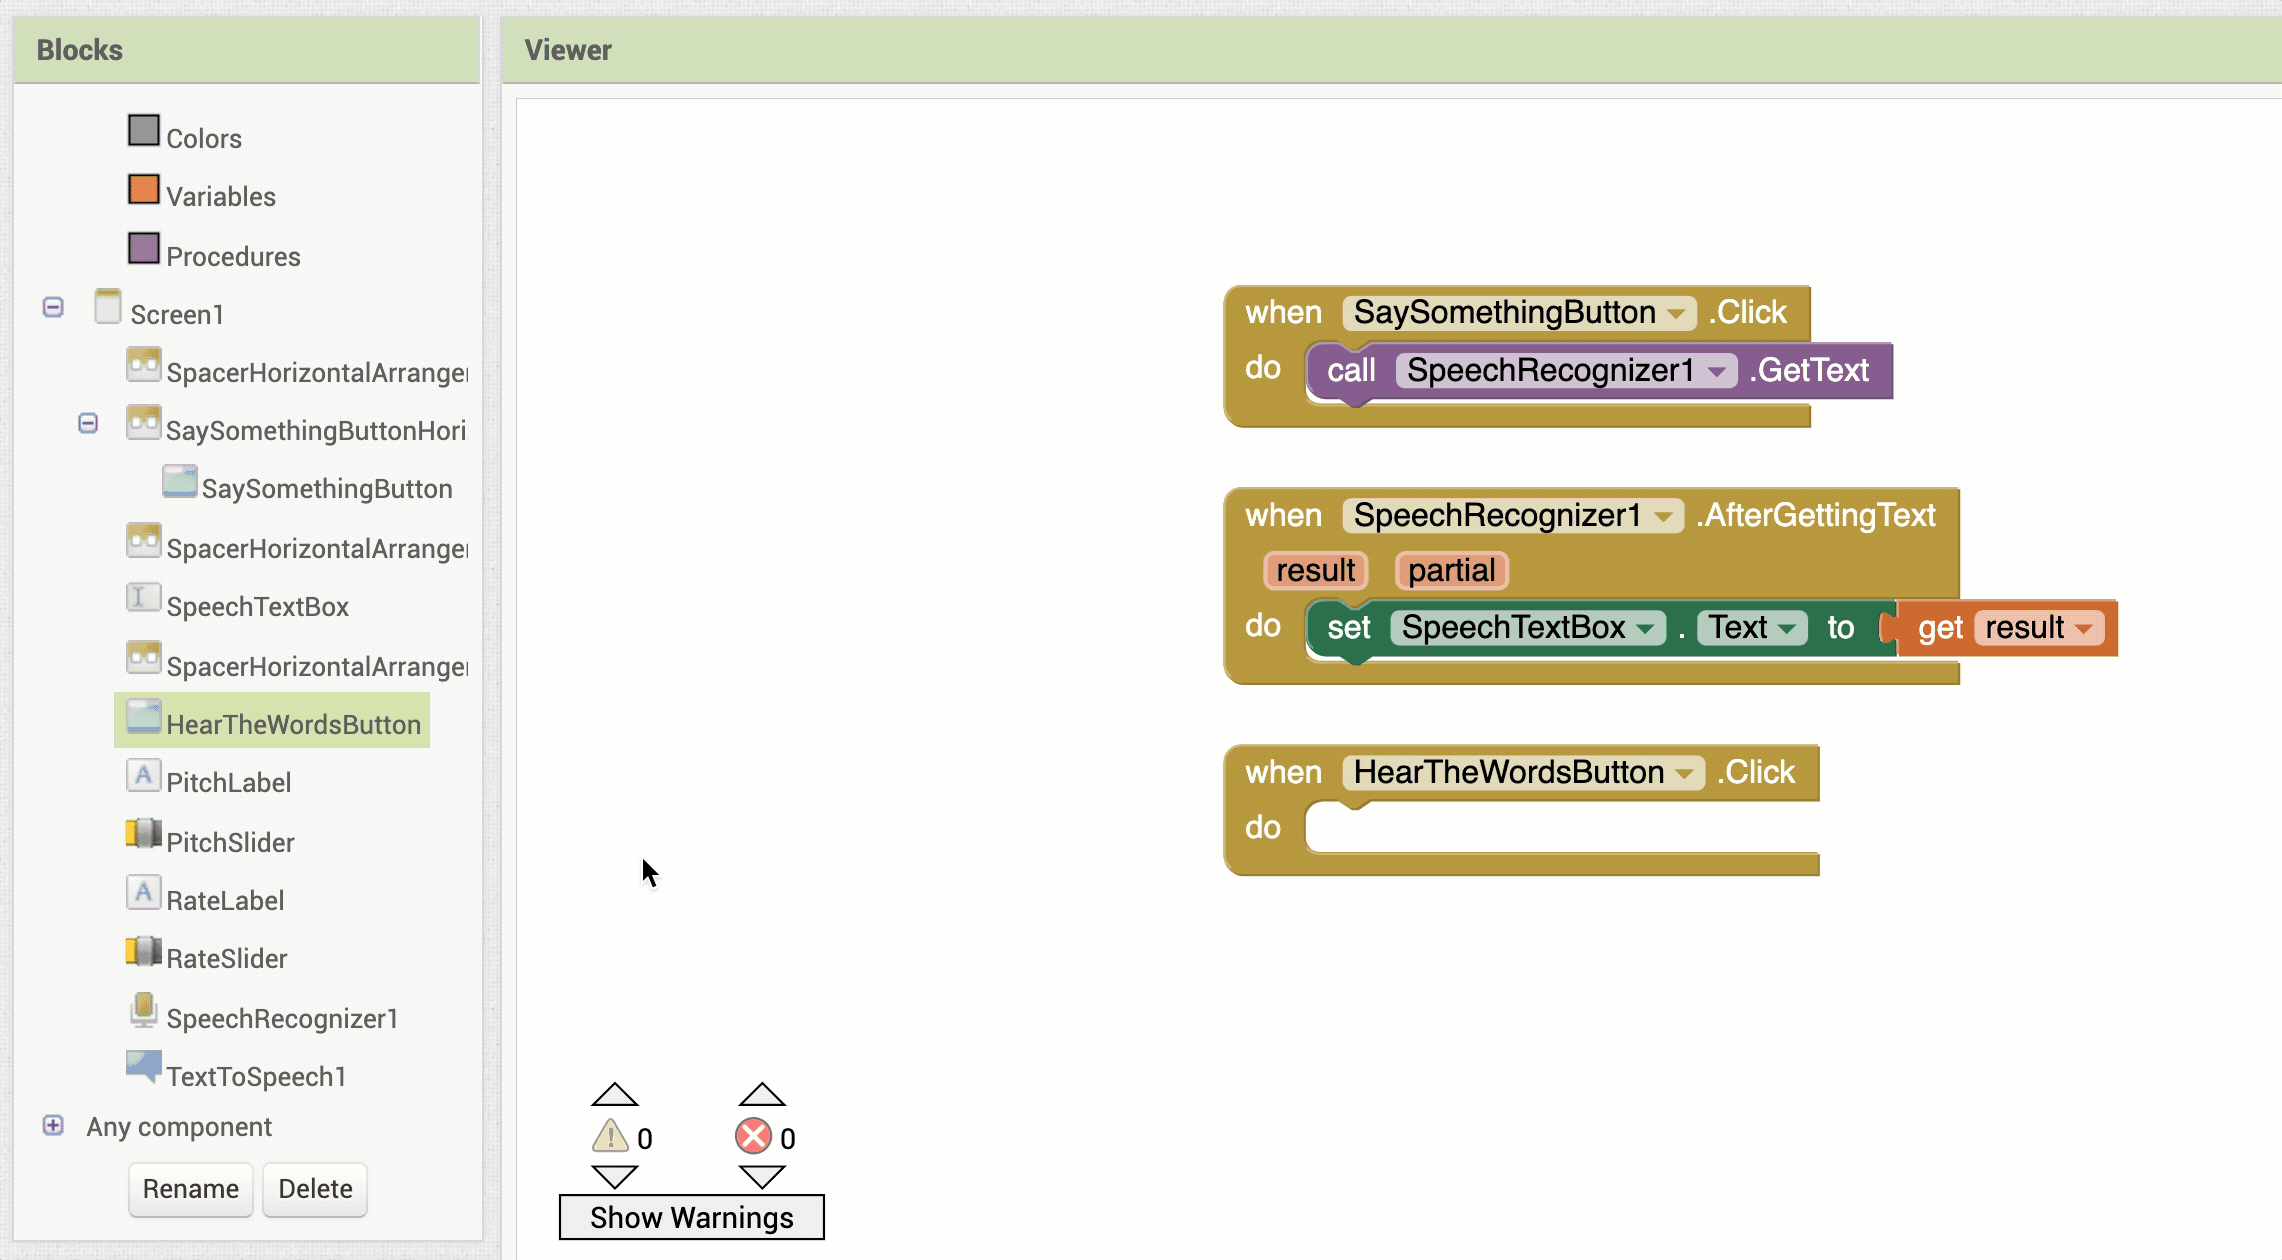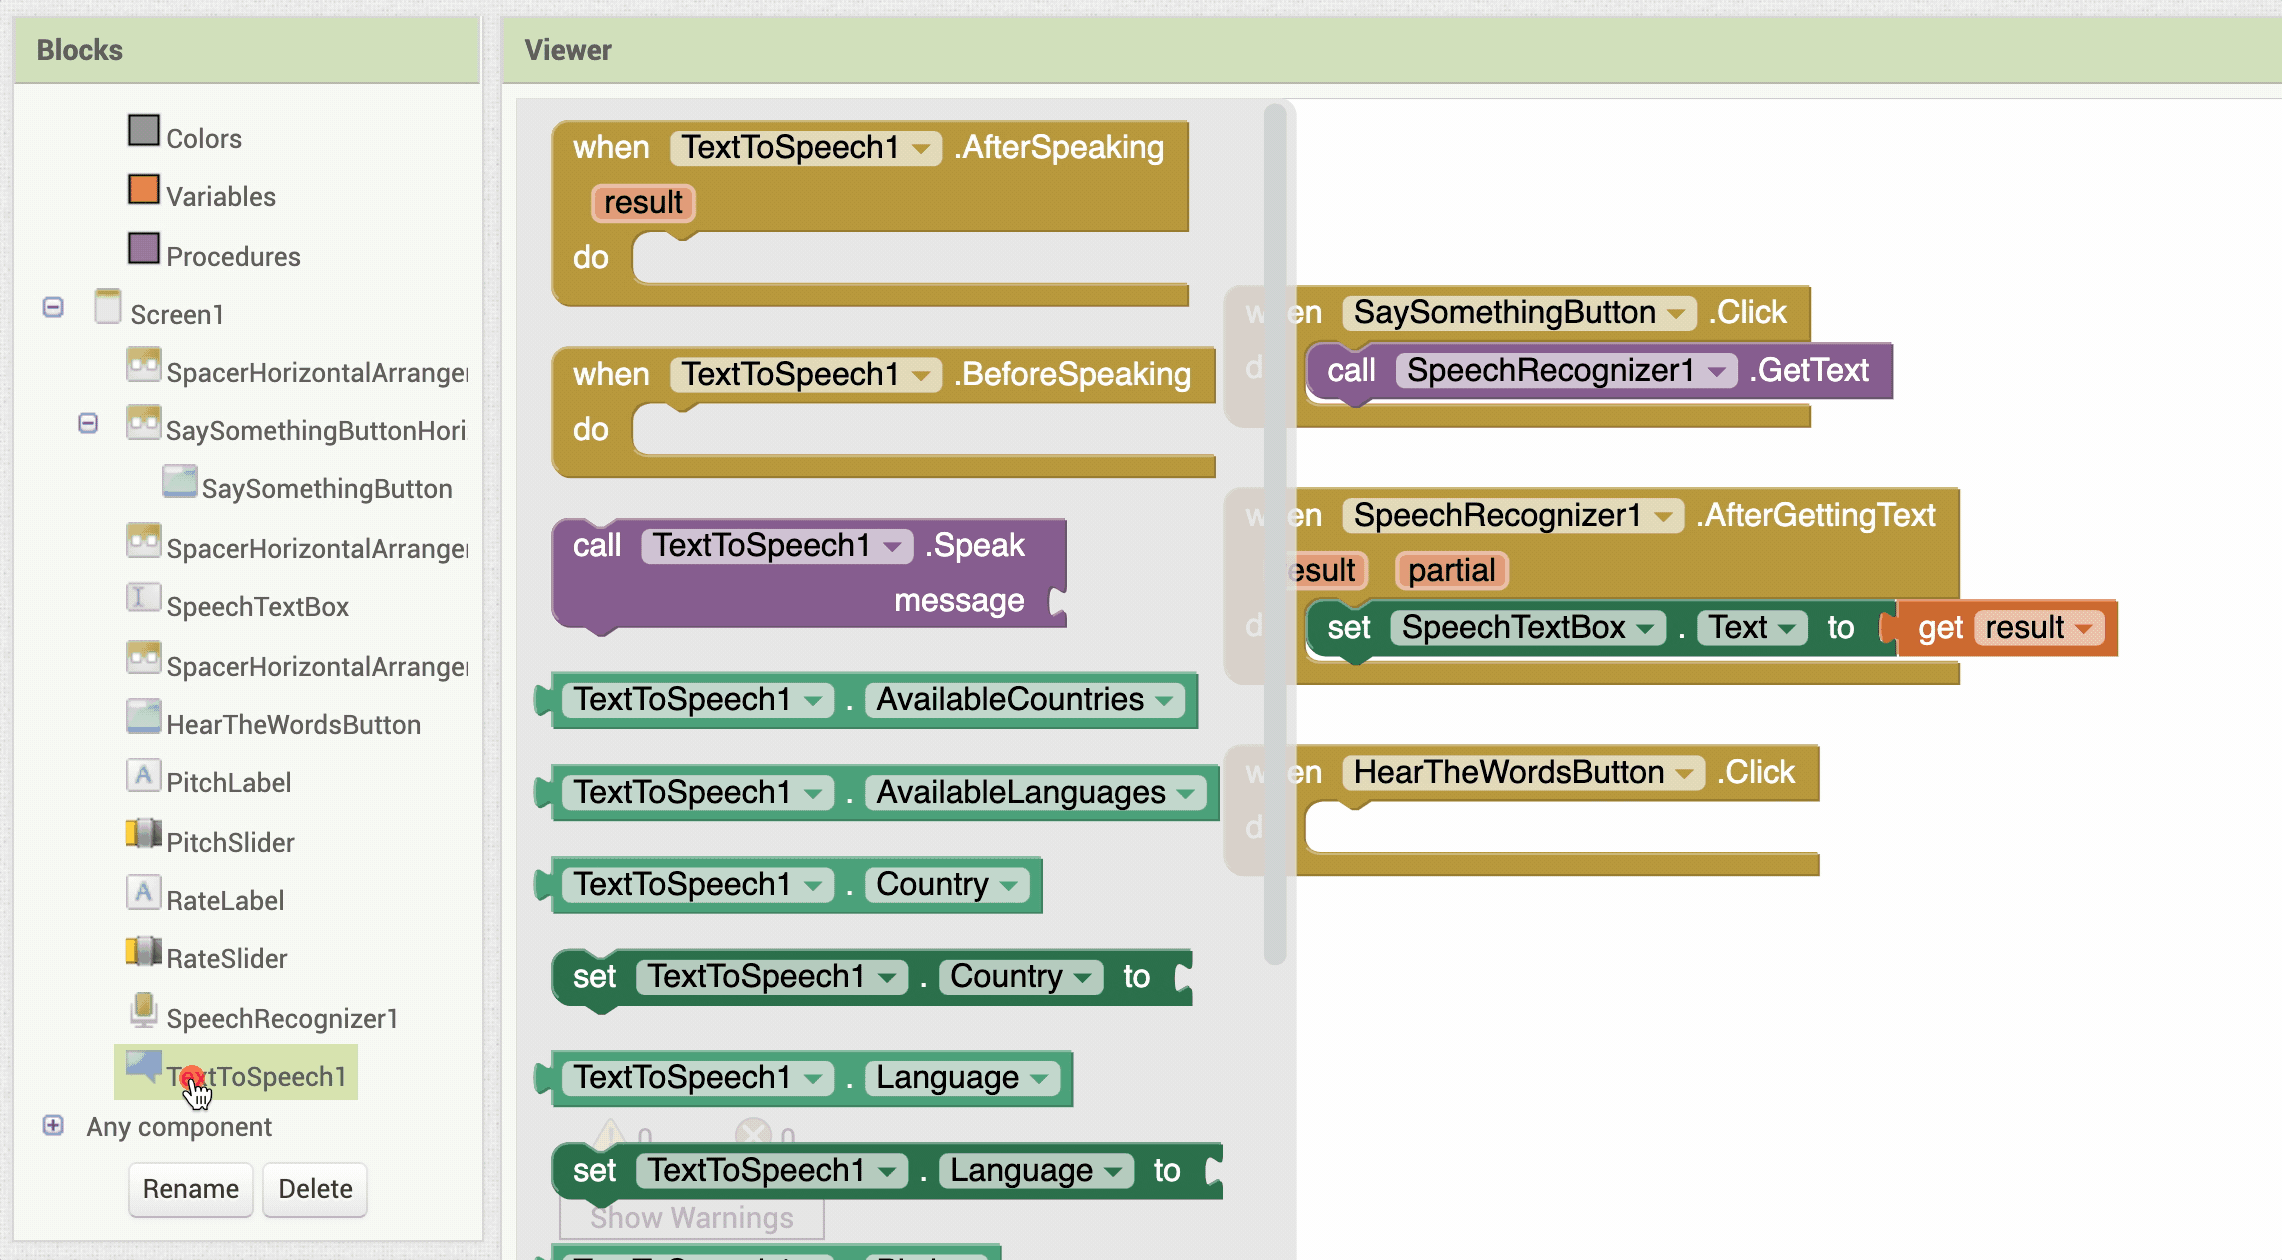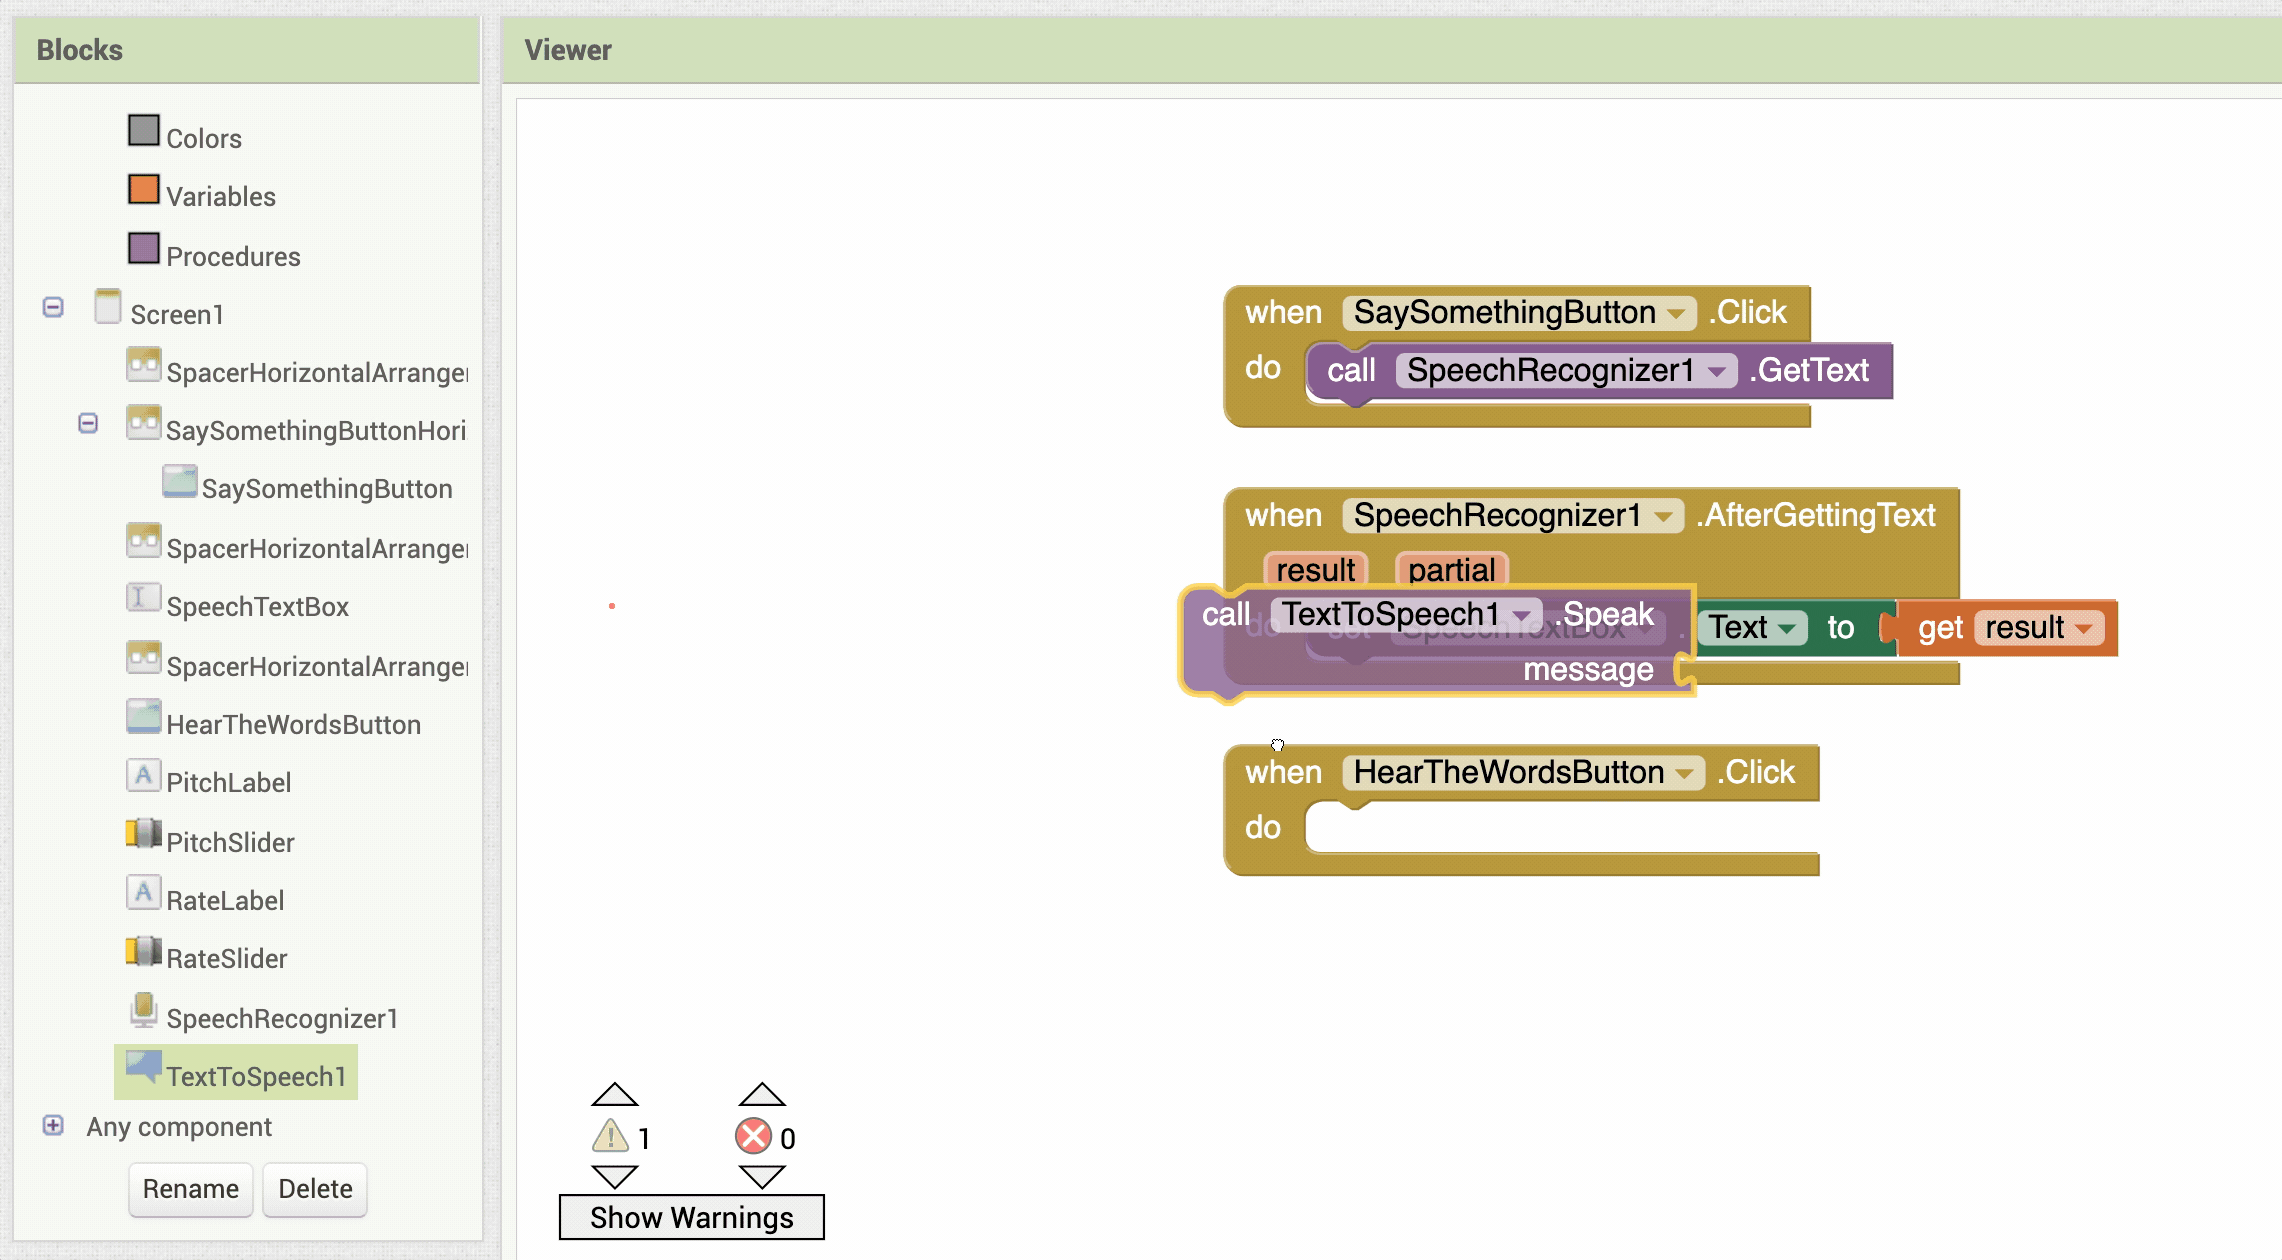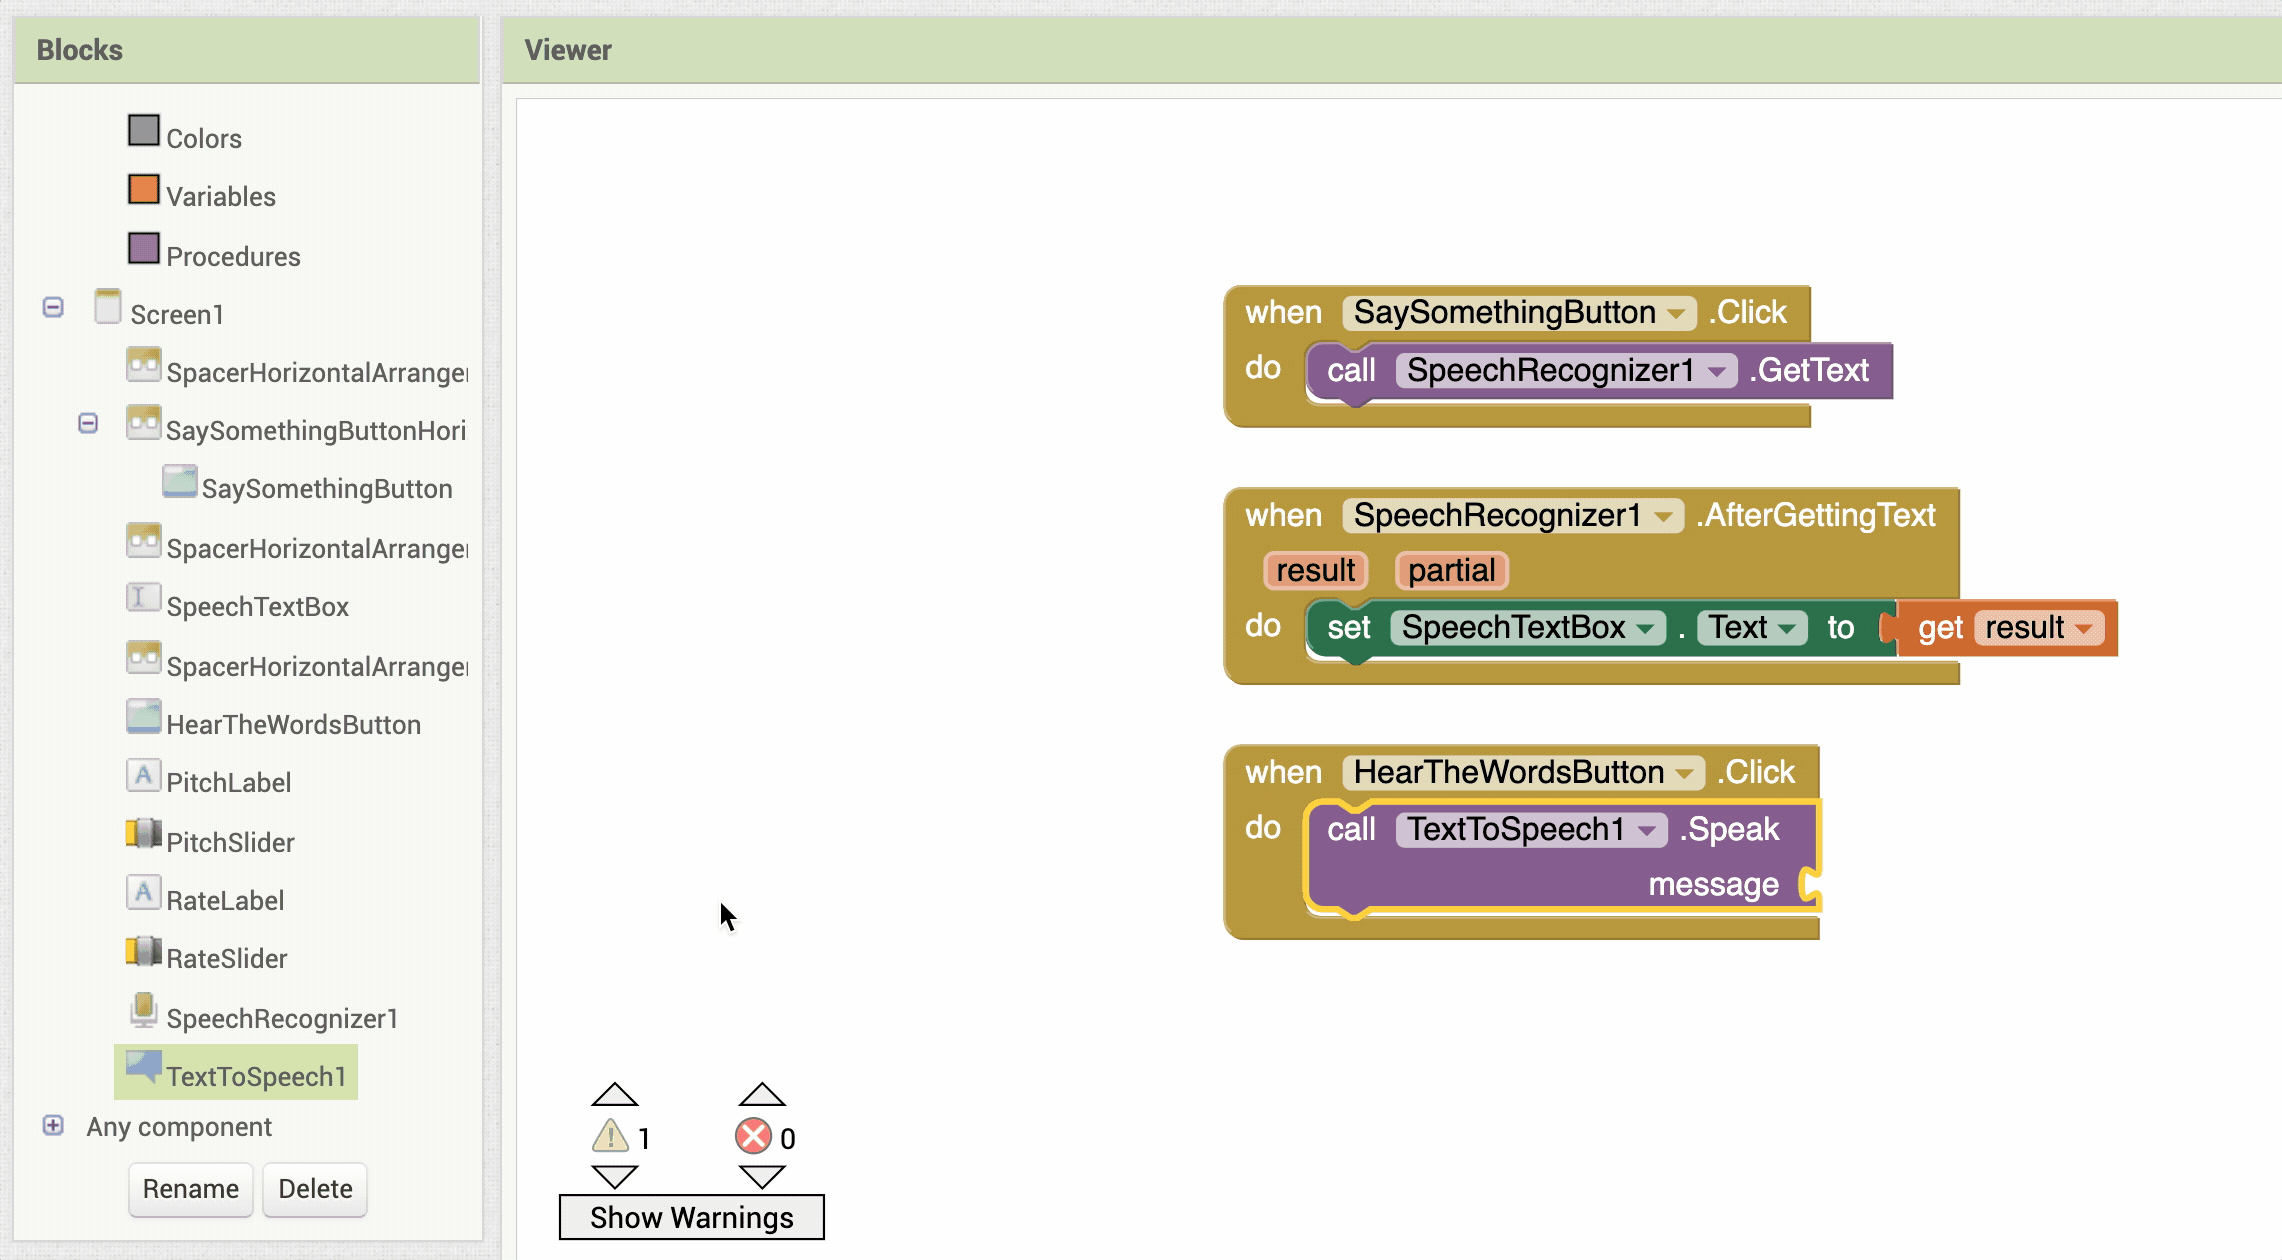
为 HearTheWordsButton.被点击时 添加事件,从 TextToSpeech1 抽屉拖出 调用 TextToSpeech1.念读。按钮点击时,程序将执行这个调用。
13. 把文字接到 TextToSpeech
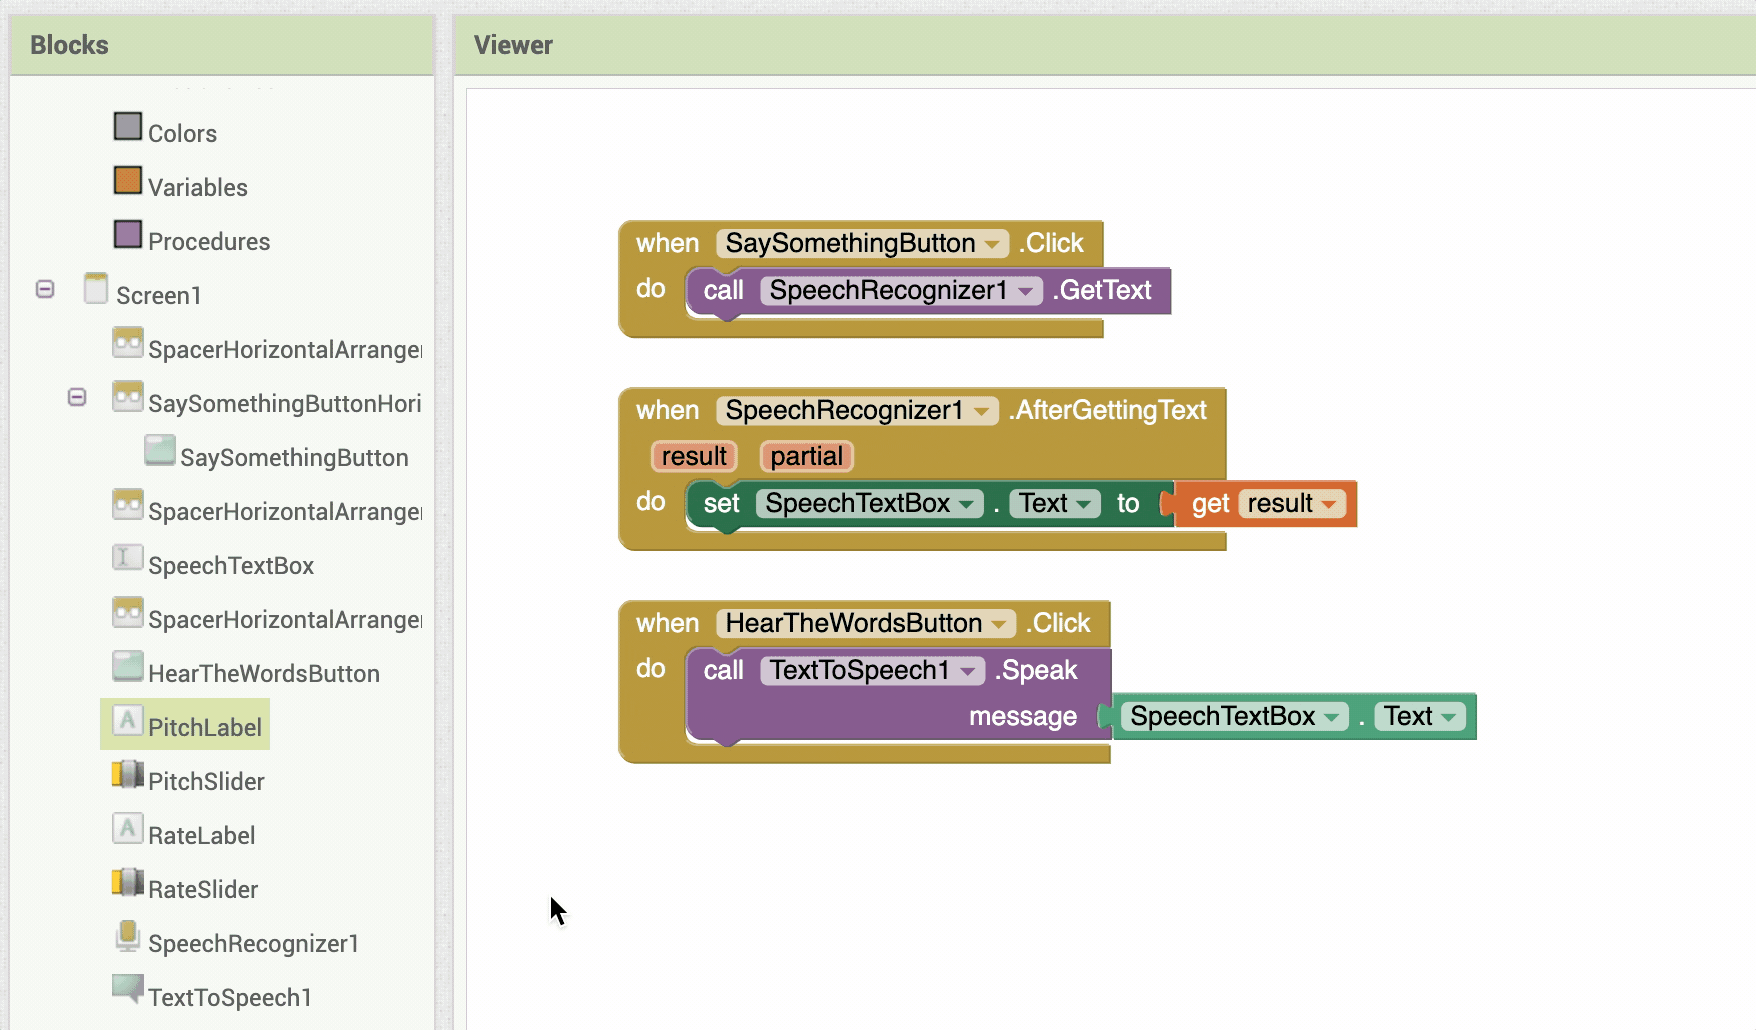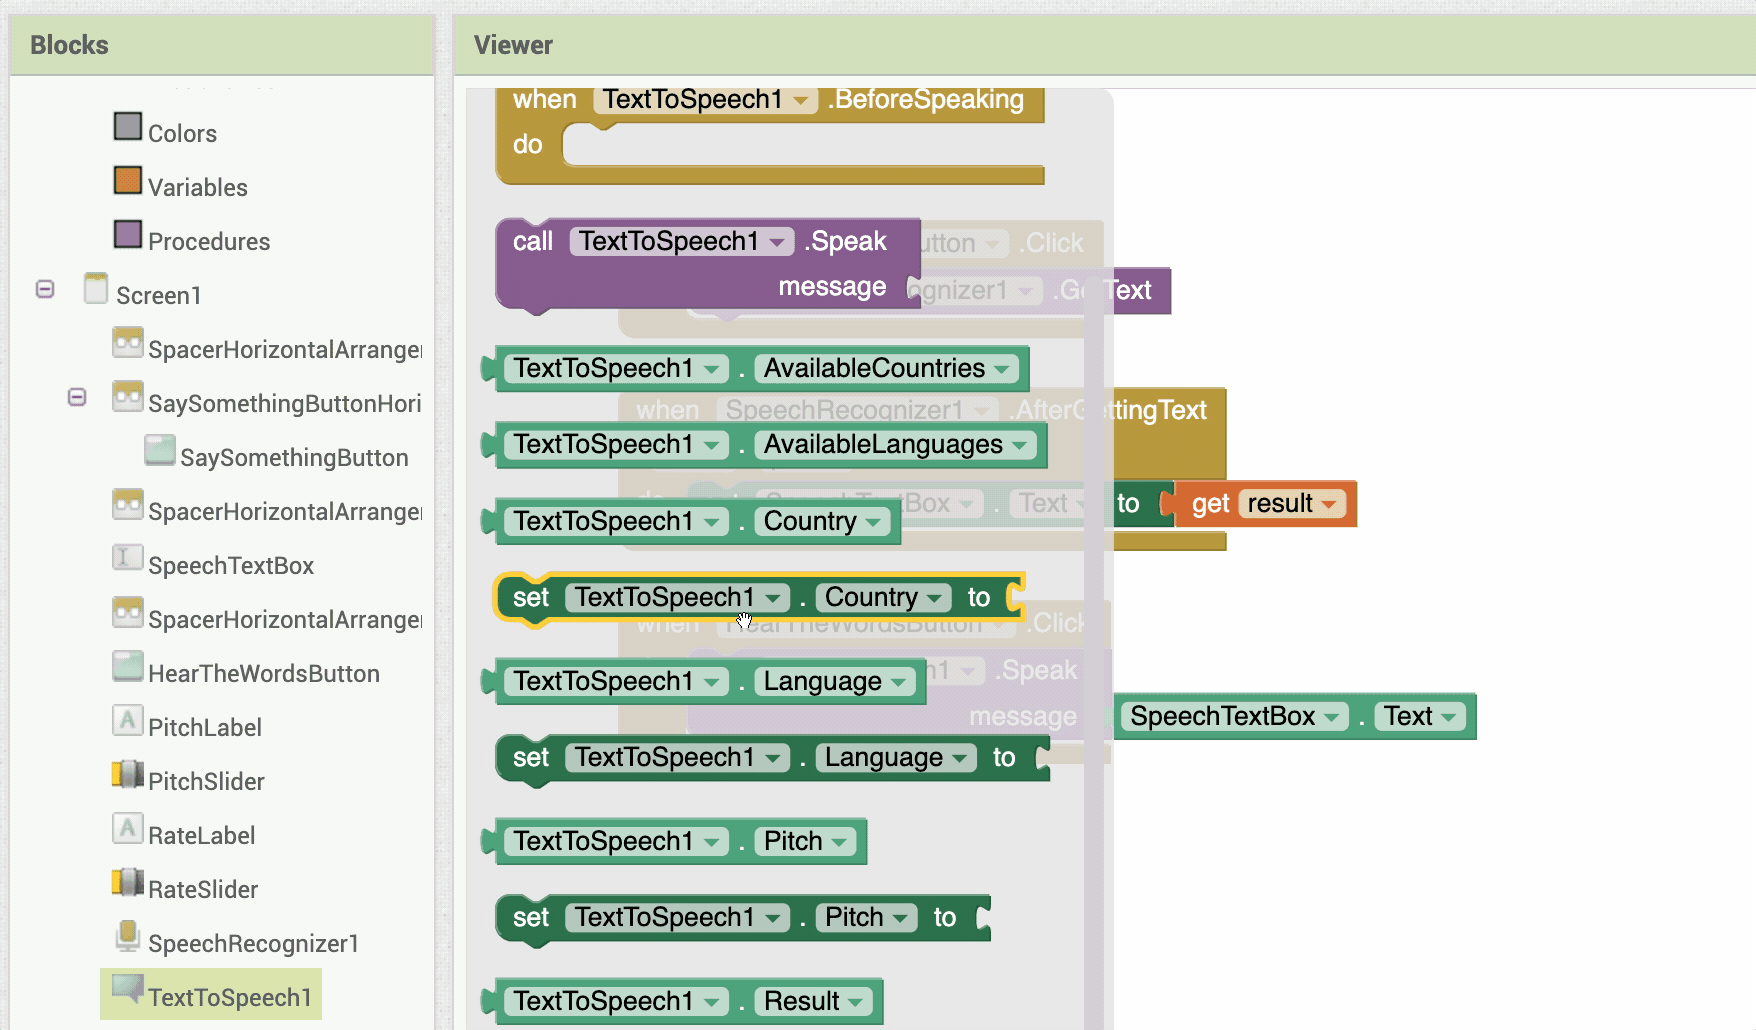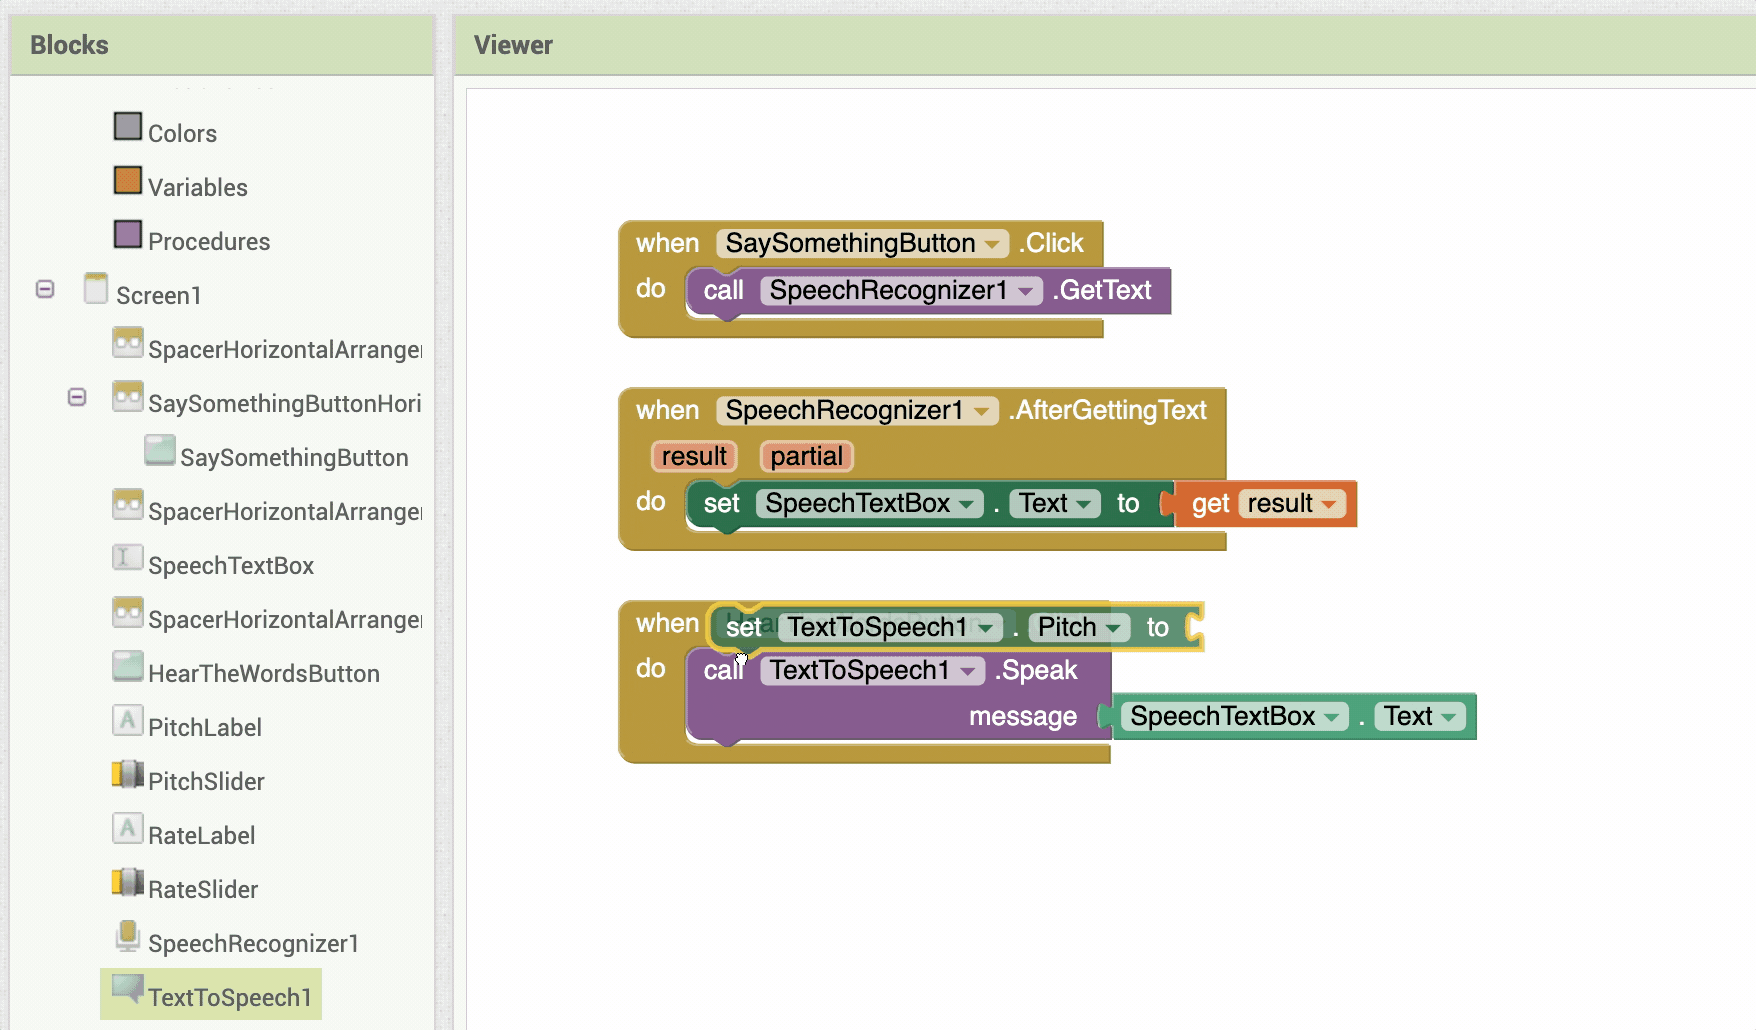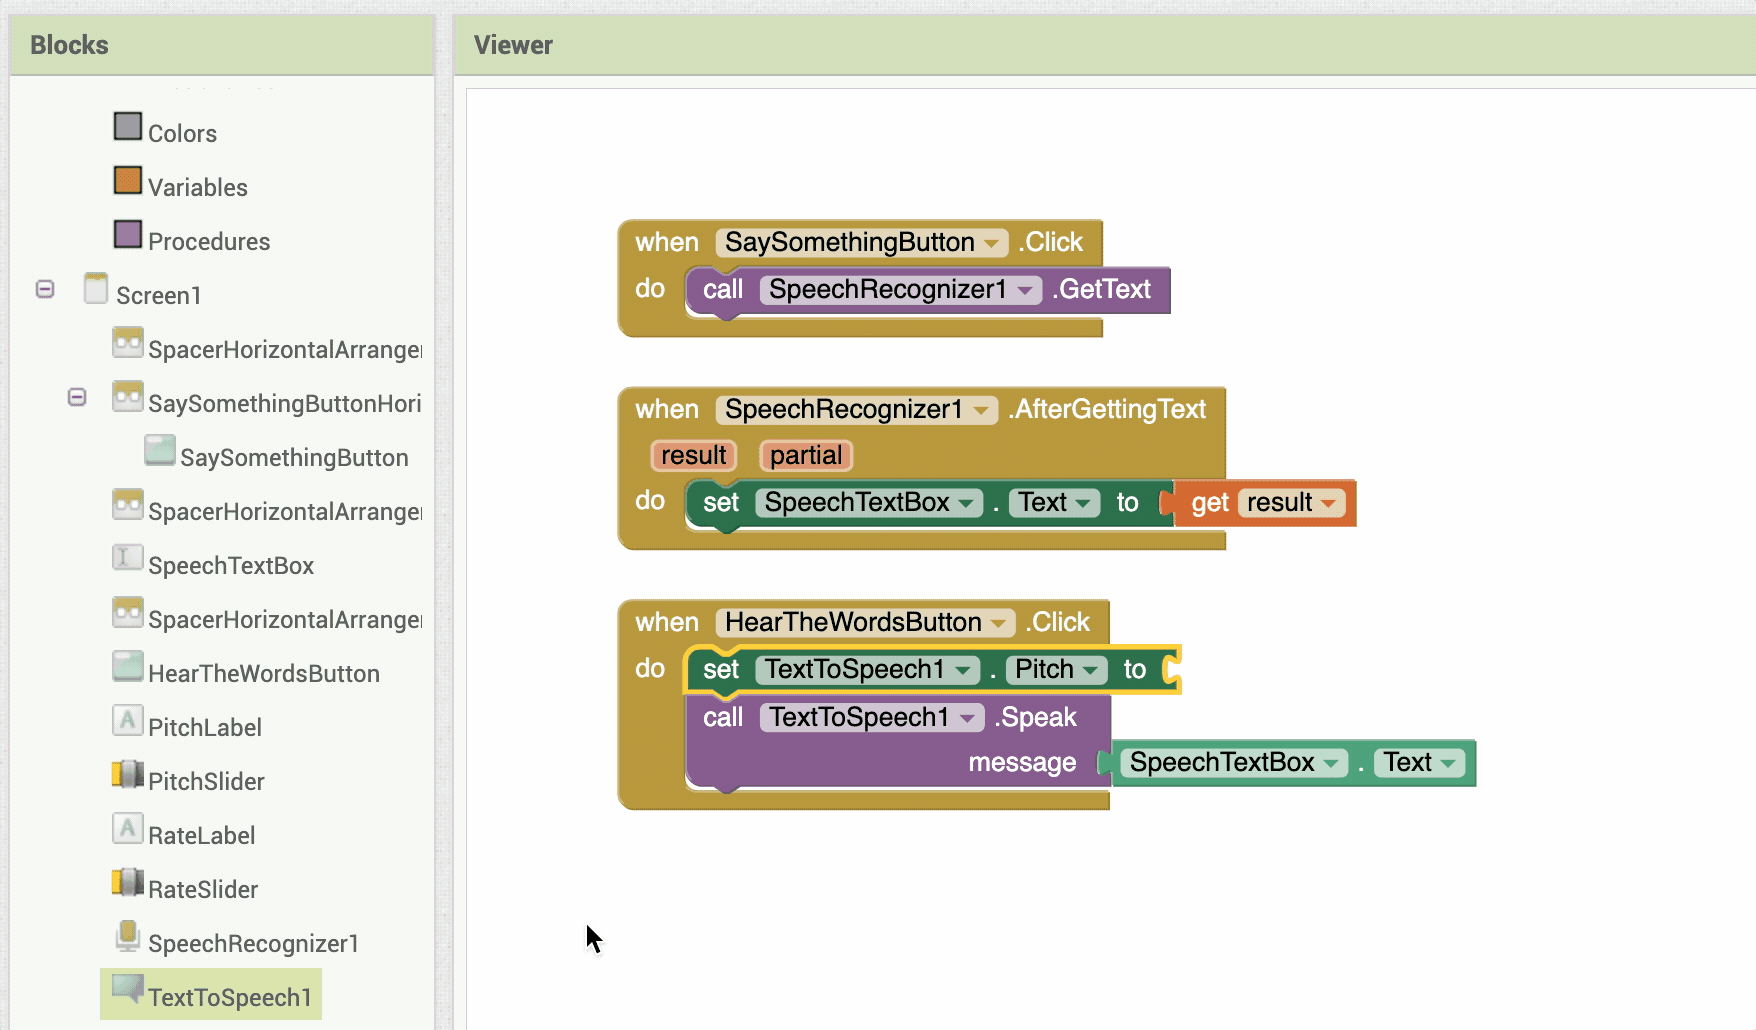
从 SpeechTextBox 抽屉取得 SpeechTextBox.文本,接到 TextToSpeech1.念读 的 message 输入槽。这样文本朗读器才知道应该读什么。
14. 测试变声效果
重新用 AI2 Companion 测试:先点击“开始说话”生成文字,再点击“朗读文字”。也可以直接把手机上的一段文字复制到输入框,比较朗读结果。
15. 使用音调和语速滑块
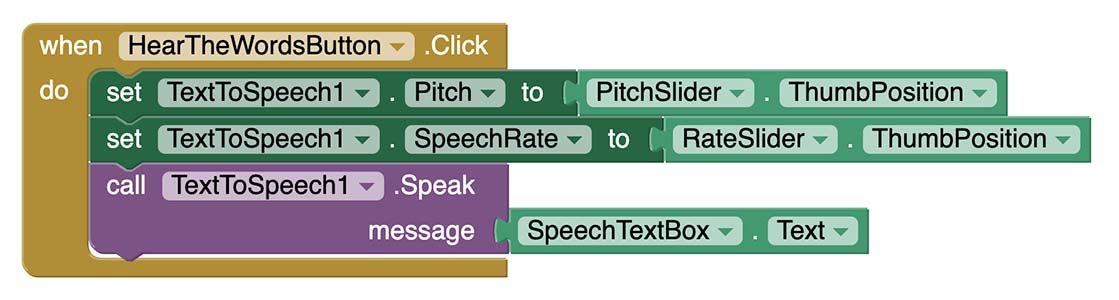
在朗读按钮事件中,把设置放在 Speak 调用之前:
- 用
设 TextToSpeech1.音调接PitchSlider.滑块位置。 - 用
设 TextToSpeech1.语速接RateSlider.滑块位置。
滑块向左或向右会提供不同数值。先设置属性,再调用 Speak,否则本次朗读仍会使用上一次的音调和语速。
连接手机反复测试,寻找高音、低音、快速和慢速的组合。完成后可以保存应用,分享给别人体验,但不要用变声器冒充他人。
扩展你的应用
你可以显示音调和语速的数值,添加语言和口音选择,把 TextToSpeech 的 Language 设置为 ES 朗读西班牙语,或把长文本翻译后再朗读。也可以把它改造成旅行翻译器、朗读器或无障碍辅助工具。
项目来源
本教程讨论的“深度伪造”与合成语音只是背景知识;实际应用使用的是手机系统的 SpeechRecognizer 和 TextToSpeech,不会生成真人声音模型。使用相关技术时要尊重他人身份、声音和隐私。
卡在哪一步?直接查操作
不用退出当前教程。速查会在新页面打开,查完回来继续刚才的进度。