网页资料提取:输入网址,选一种提取规则,把网页上的标题、列表、链接或正文提出来,逐条查看、分享,或导出成 CSV 表格。
这一篇回答的搜索:APP Inventor 提取网页上资料、AppInventor web.get、App Inventor 使用 WEB 客户端、Web 组件找不到 SaveResponse、App Inventor 支持调用 Web API、appinventor 网络组件、网络客户端、解析数据。
界面
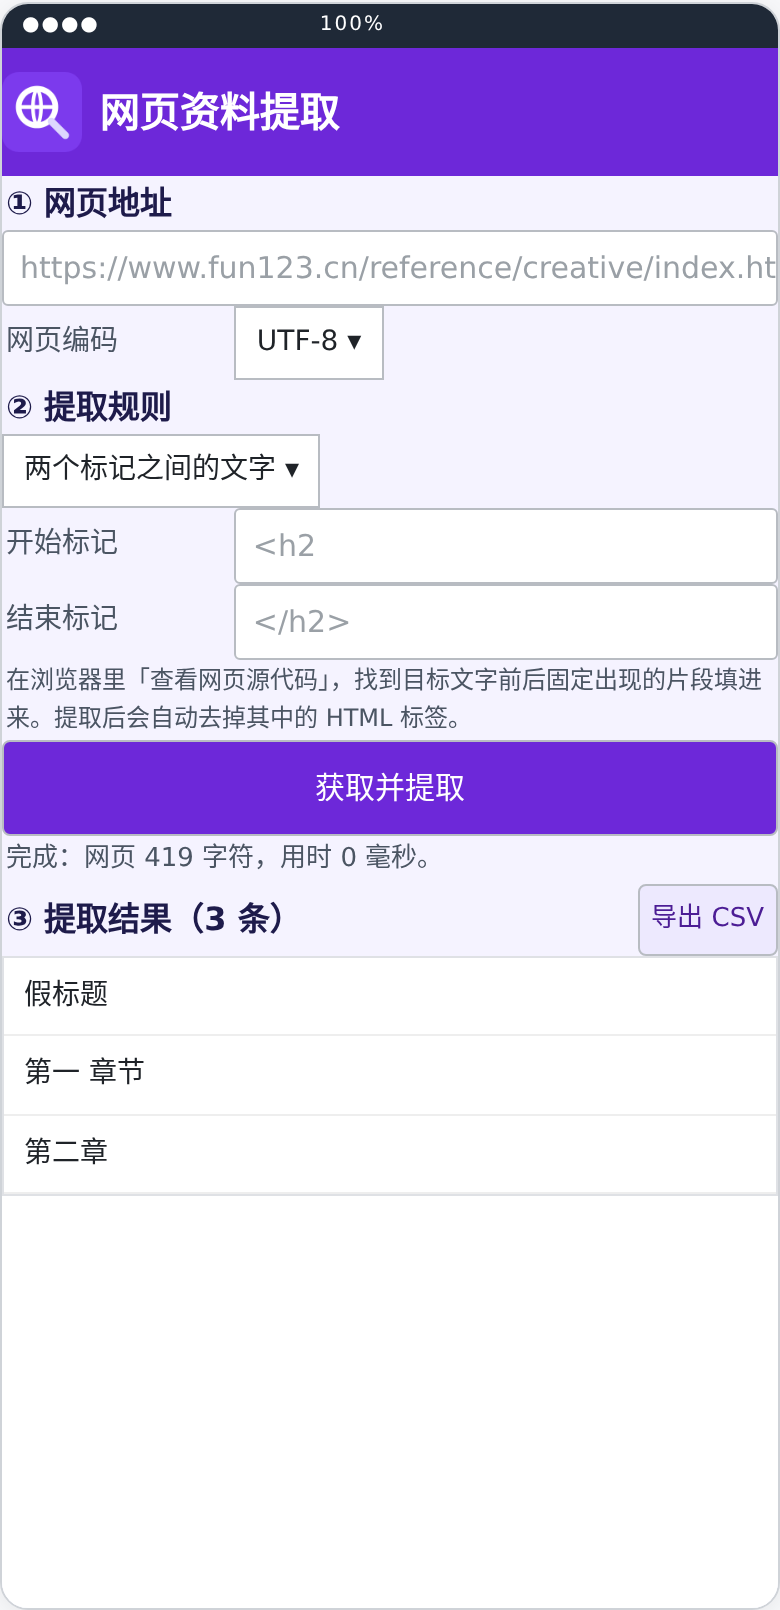
图为由最终 .aia 生成的布局预览(结果为示例),不是真机截图。
怎么用
- 填网址(默认是本站的「原创内容」目录页),网页编码一般选 UTF-8,老网站乱码时改 GBK。
- 选提取规则:
- 两个标记之间的文字:最通用。在电脑浏览器里对目标网页「查看网页源代码」,找到想要的文字前后固定出现的片段,比如每个小标题都是
<h2 id="…">标题</h2>,开始标记填<h2、结束标记填</h2>。 - 网页标题:
<title>里的文字。 - 全部链接:所有
href,/a.html、//cdn…这类相对地址会补成完整网址,去掉#、javascript:和重复项。 - 正文段落:去掉脚本和样式后,标签之间的每一段文字。
- 两个标记之间的文字:最通用。在电脑浏览器里对目标网页「查看网页源代码」,找到想要的文字前后固定出现的片段,比如每个小标题都是
- 点「获取并提取」。
中途验证:默认网址 +<h2/</h2>应提取出「特色」「基础知识」「组件用法」等 8 个小标题。 - 点结果里的一条可以看全文并分享;「导出 CSV」生成表格文件后直接分享到微信、WPS 等。
规则和网址会自动记住,下次打开直接点「获取并提取」即可。
核心代码
发请求,处理成功、失败与超时
Get 是异步的:结果在 GotText 里拿到,网络不通或网站不响应则触发 TimedOut(需要在设计器里给 Timeout 设值,成品是 15000 毫秒)。很多网站会拒绝没有浏览器标识的请求,请求头里加上 User-Agent。
when Screen1.Initialize() {
  Web客户端1.RequestHeaders = [["User-Agent", "Mozilla/5.0 (Linux; Android 13) Chrome/120 Mobile Safari/537.36"]]
}

when 按钮_获取.Click() {
  Web客户端1.Url = 文本输入框_网址.Text
  Web客户端1.ResponseTextEncoding = 下拉框_编码.Selection
  标签_状态.Text = "正在获取……"
  Web客户端1.Get()
}

global 结果 = []

when Web客户端1.GotText(url, responseCode, responseType, responseContent) {
  if responseCode == 200 {
    提取标记之间(responseContent, 文本输入框_开始.Text, 文本输入框_结束.Text)
    列表显示框_结果.Elements = 结果
    标签_状态.Text = join("完成:提取到 ", length(结果), " 条")
  } else {
    标签_状态.Text = join("网站返回 ", responseCode, ",没有成功")
  }
}

when Web客户端1.TimedOut(url) {
  标签_状态.Text = "超时没有响应,检查网络或网址"
}

// 用开始标记切开:第 1 段是标记前面的内容,从第 2 段起每段截到结束标记为止
procedure 提取标记之间(网页, 开始, 结束) {
  结果 = []
  var 片段 = split(网页, 开始)
  for i = 2 to length(片段) {
    var 段 = 片段[i]
    if textContains(段, 结束) {
      段 = segment(段, 1, startsat(段, 结束) - 1)
    }
    listadd(结果, trim(段))
  }
}
去掉 HTML 标签、解码 & 等实体
按 < 切开,每段只保留 > 后面的部分,就去掉了所有标签;Web 客户端的 HtmlTextDecode 把 &、<、 还原成字符,最后把连续空白合并成一个空格。
global 清洗结果 = ""

procedure 去标签(文本) {
  var 输出 = ""
  var 片段 = split(文本, "<")
  for i = 1 to length(片段) {
    var 段 = 片段[i]
    if textContains(段, ">") {
      段 = segment(段, startsat(段, ">") + 1, textLength(段))
    }
    输出 = join(输出, 段)
  }
  输出 = replace(Web客户端1.HtmlTextDecode(输出), "\n", " ")
  while textContains(输出, "  ") {
    输出 = replace(输出, "  ", " ")
  }
  清洗结果 = trim(输出)
}
第一段也要去掉 > 之前的部分:开始标记写成 <h2(不写右尖括号)时,提取到的内容开头会带着 ` id=”xxx”>`,这一步正好把它去掉。
结果导出 CSV 并分享
AfterFileSaved 回传的是你传入的文件名(相对路径),直接交给信息分享器即可,它会按同一个 App 专属目录去找文件。
global 结果 = []

when 按钮_导出.Click() {
  var 表格 = [["序号", "内容"]]
  for i = 1 to length(结果) {
    listadd(表格, [i, 结果[i]])
  }
  文件管理器1.SaveFile(csvTable(表格), "web-extract.csv")
}

when 文件管理器1.AfterFileSaved(fileName) {
  信息分享器1.ShareFile(fileName)
}
常见问题
| 现象 | 原因与处理 |
|---|---|
| 提取结果是 0 条 | ① 内容是网页打开后再用 JavaScript 加载的(很多新闻、电商页面),源代码里根本没有——在浏览器里「查看网页源代码」搜一下目标文字,搜不到就只能找它背后的数据接口(通常返回 JSON,见 JSON 解析);② 标记写错了,标记必须和源代码里一字不差,包括大小写和引号。 |
| 返回 403 | 网站拒绝了请求。成品已加浏览器 User-Agent;仍然 403 说明有反爬限制或需要登录,换个公开页面或官方接口。 |
| 中文是乱码 | 网页是 GBK/GB2312 编码,在「网页编码」里改选,或在设计器里设置 ResponseTextEncoding。 |
| 一直「正在获取」没有反应 | 没设置超时:Timeout 默认 0 表示一直等。设成 10000~15000 毫秒并处理 TimedOut 事件。 |
| 找不到 SaveResponse 选项 | SaveResponse(保存响应信息)是设计器属性,在 Web 客户端的属性面板里;勾上后结果存成文件并触发 GotFile,不再触发 GotText。提取文字时不要勾。 |
| 链接地址不完整 | /a.html 和 //域名/… 会自动补全;像 a.html 这种相对于当前目录的写法,成品按网站根目录补全,个别网站会不准。 |
| 想提取表格里的数据 | 开始标记填 <td、结束标记填 </td>,得到所有单元格,再按列数分组;如果网站提供 JSON/CSV 接口,直接用接口更稳。 |
用到的组件
相关教程:API 通信 · JSON 解析 · XML 解析 · 网页浏览器执行 JS
验证范围
最终 .aia 已通过:正式编辑器载入与保存重开 0 错误、后台导入、Android APK 编译,并用固定的测试网页执行了真实积木的 13 项业务检查(四种规则的提取结果、相对链接补全与去重、script/style 过滤、实体解码、403/超时/无匹配提示、分享与 CSV 导出、重启恢复规则);另用同一套积木对本站真实页面跑过一遍(8 个小标题、187 个链接、233 段正文)。手机网络环境下的表现以实测为准。详见验证记录。
 扫码添加客服咨询